Datenreplikationstechniken für Hochverfügbarkeit: Ein umfassender Vergleich
Datenreplikation auf Datenbank-, Festplatten- oder Dateiebene?
Überblick
Dieser Artikel vergleicht die Vor- und Nachteile der Datenreplikation auf Datenbank-, Festplatten- und Dateiebene für Hochverfügbarkeitscluster. Dabei betrachten wir Failover, Failback und die einfache Implementierung.
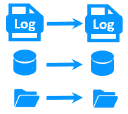
Die folgenden Vergleichstabellen erläutern die von SafeKit implementierten Datenreplikationstechniken. SafeKit ist eine Software für Hochverfügbarkeit.
Wie funktioniert Datenreplikation auf Datenbankebene?
Das Datenbankmanagementsystem repliziert Protokolldateien zwischen zwei Servern, beispielsweise das SQL-Server-Transaktionsprotokoll.
Für automatischen Failover ist synchrone Replikation erforderlich. Andernfalls stehen die zuletzt bestätigten Transaktionen nach dem Failover auf dem sekundären Server nicht zur Verfügung.
Diese Technik repliziert eine Datenbank, aber nicht die übrigen Daten einer Anwendung. Für den Failover vieler Anwendungen müssen auch andere Daten, etwa Konfigurationsdateien, repliziert werden.
Stürzt ein Server ab und gehen Datenbankdateien verloren, erfolgt das Failback nicht automatisch. Ein erfahrener Datenbankadministrator muss die Datenbank auf dem ausgefallenen Server wiederherstellen.
Wie funktioniert Datenreplikation auf Festplattenebene?
Dabei werden Änderungen auf den Festplatten zwischen zwei Servern repliziert, beispielsweise mit DRBD.
Für automatischen Failover ist synchrone Replikation zwischen den Festplatten erforderlich, um Datenverlust zu vermeiden.
Diese Technik kann Datenbanken und andere Dateien replizieren, wirkt sich jedoch stark auf die Organisation der Anwendungsdaten aus: Alle Daten müssen auf der replizierten Festplatte liegen. Das ist möglicherweise nicht möglich, wenn zu replizierende Daten auf der Systemfestplatte gespeichert sind, da diese für jeden Server individuell bleiben muss.
Für die Konfiguration einer replizierten Festplatte mit Dateisystem und die Ablage der Anwendungsdaten darauf sind Fachkenntnisse erforderlich.
Wie funktioniert Datenreplikation auf Dateiebene?
Dabei werden Dateiänderungen zwischen zwei Servern repliziert, beispielsweise mit SafeKit.
Für automatischen Failover ist synchrone Echtzeit-Replikation erforderlich, um Datenverlust zu vermeiden.
Diese Technik kann Datenbanken und andere Dateien replizieren, ohne die Organisation der Anwendungsdaten zu verändern. Liegen Anwendungsdaten beispielsweise auf der Systemfestplatte, funktioniert die Echtzeit-Dateireplikation trotzdem.
Die Konfiguration ist einfach: Es müssen nur die Pfade der zu replizierenden Verzeichnisse angegeben werden.
Vergleichstabellen zu Datenreplikationstechniken
Die Wahl des richtigen Ansatzes zur Datenreplikation ist entscheidend für die Sicherstellung der Geschäftskontinuität. Dieser Vergleich hebt die wichtigsten Unterscheidungsmerkmale des SafeKit Mirror-Clusters mit Echtzeit-Dateireplikation gegenüber traditionellen Alternativen wie Datenbankreplikation, Festplattenreplikation, Shared-Disk-Lösungen und fehlertoleranten Systemen hervor.
SafeKit Mirror-Cluster: Vorteile gegenüber alternativen Replikations- und Clustering-Ansätzen
| Merkmal | SafeKit-Vorteil | Einschränkung der Alternativen |
|---|---|---|
| 3 Produkte in 1 | Spart unter Windows und Linux die Kosten für externen gemeinsamen/replizierten Speicher, Load-Balancing-Geräte und Enterprise-Editionen von Betriebssystemen und Datenbanken. Enthält alle Cluster-Funktionen: synchrone Echtzeit-Dateireplikation, Störungsüberwachung, automatischer Neustart, virtueller IP-Failover. | Traditionelle Ansätze erfordern separate Produkte für Speicherreplikation, Lastverteilung und Clustering — was Kosten und Komplexität erhöht. |
| Sehr einfache Konfiguration | Konfiguration über Anwendungsmodule. Neue Dienste und replizierte Verzeichnisse können einfach hinzugefügt werden. Alles wird über eine zentrale Webkonsole verwaltet. Kein Domänencontroller oder Active Directory erforderlich. | Microsoft Cluster und ähnliche Lösungen erfordern eine komplexe Active-Directory-Konfiguration und Domänencontroller. |
| Synchrone Replikation | Die Echtzeit-Replikation ist synchron ohne Datenverlust bei Ausfall (RPO = 0). | Asynchrone Replikation kann kürzlich durchgeführte Transaktionen verlieren, die zum Zeitpunkt des Ausfalls noch nicht repliziert wurden. |
| Vollautomatisches Failback | Nach einem Ausfall, wenn ein Server neu startet, ist das Replikations-Failback vollautomatisch. Der ausgefallene Server wird ohne Stopp der Anwendung auf dem verbleibenden Server wieder in den Cluster integriert. | Die meisten Replikationslösungen (insbesondere auf Datenbankebene) erfordern eine manuelle Resynchronisation. Die Anwendung kann während des Failbacks sogar gestoppt werden. |
| Replikation aller Datentypen | Die Replikation funktioniert für Datenbanken und für alle Dateien, die repliziert werden müssen. | Replikation auf Datenbankebene schützt nur die Datenbank, nicht Konfigurationsdateien, Protokolle oder andere Anwendungsdaten. |
| Dateireplikation vs. Festplattenreplikation | Die Replikation basiert auf Dateiverzeichnissen, die sich überall befinden können, sogar auf der Systemfestplatte. | Festplattenreplikation erfordert eine dedizierte Partition und eine spezielle Anwendungskonfiguration zur Datenspeicherung. |
| Dateireplikation vs. Shared Disk | Server können an zwei entfernten Standorten ohne gemeinsame Infrastruktur eingesetzt werden. | Shared-Disk-Lösungen erfordern physische Nähe und können keine entfernten Standorte abdecken. |
| Entfernte Standorte und virtuelle IP | Alle Cluster-Funktionen funktionieren für 2 Server an entfernten Standorten. Extended LAN ermöglicht VIP-Umleitung auf Schicht 2. Für unterschiedliche IP-Netzwerke wird die VIP über einen Load Balancer mit SafeKit Health Check verwaltet. | Viele Clustering-Lösungen unterstützen kein Failover an entfernten Standorten oder erfordern eine komplexe DNS-Umleitung mit unvorhersehbaren Wiederherstellungszeiten. |
| Quorum und Split Brain | Funktioniert mit nur 2 Servern. Ein einfacher Split-Brain-Checker zu einem Router bewältigt die Netzwerkisolation zwischen Standorten. | Die meisten Clustering-Lösungen erfordern einen 3. Server für das Quorum-Management. |
| Aktiv/Aktiv-Cluster | Der sekundäre Server ist nicht dediziert. Der Cluster kann mit 2 verschiedenen Mirror-Modulen aktiv/aktiv betrieben werden. | Fehlertolerante Systeme widmen den sekundären Server der Ausführung derselben Anwendung, synchronisiert auf Befehlsebene. |
| Einheitliche HA-Lösung | SafeKit implementiert sowohl Mirror-Cluster (Replikation + Failover) als auch Farm-Cluster (Lastverteilung + Failover). Eine N-Tier-Architektur kann mit einer einzigen Lösung auf Windows und Linux hochverfügbar gemacht werden. | Typische Architekturen mischen verschiedene Technologien für Lastverteilung, Replikation und Failover — was die betriebliche Komplexität erhöht. |
| RTO / RPO | Schneller Neustart der Anwendung bei Ausfall: etwa 1 Minute oder weniger. Kein Datenverlust (synchrone Replikation). | Vollständige VM-Replikation (VMware HA, Hyper-V Cluster) erfordert den Neustart des gesamten Betriebssystems auf einem neuen Hypervisor, was zu längeren Wiederherstellungszeiten führt. |
Zusammenfassend bietet der SafeKit Mirror-Cluster eine einheitliche, kosteneffiziente Hochverfügbarkeitslösung, die synchrone Dateireplikation, automatisches Failover und Failback, Lastverteilung und Unterstützung entfernter Standorte vereint — alles ohne dedizierte Hardware, gemeinsamen Speicher oder einen dritten Quorum-Server. Diese Einfachheit macht ihn besonders geeignet für Softwarehersteller und Organisationen, die zuverlässige HA auf Standard-Windows- und Linux-Servern benötigen.
🔍 SafeKit Hochverfügbarkeit Navigation Hub
Entdecken Sie SafeKit: Funktionen, technische Videos, Dokumentation und kostenlose Testversion
| Ressourcentyp | Beschreibung | Direkter Link |
|---|---|---|
| Hauptfunktionen | Warum SafeKit für einfache und kosteneffiziente Hochverfügbarkeit wählen? | Warum SafeKit für Hochverfügbarkeit? |
| Anwendungsfälle | Erfahren Sie, wie SafeKit die Hochverfügbarkeit kritischer Infrastrukturen gewährleistet | Alle Anwendungsfälle ansehen (OEM-Software, Edge-Server, SCADA und mehr) |
| Bereitstellungsmodell | All-in-One SANlose HA: Shared-Nothing Software-Clustering | SafeKit All-in-One SANlose HA ansehen |
| HA-Strategien | SafeKit: Infrastruktur (VM) vs. Hochverfügbarkeit auf Anwendungsebene | SafeKit HA & Redundanz: VM vs. Anwendungsebene |
| Technische Spezifikationen | Technische Einschränkungen für SafeKit-Clustering | Technische Einschränkungen von SafeKit ansehen |
| Videos | SafeKit: Konfiguration der Hochverfügbarkeit & Failover-Demos | SafeKit Failover-Tutorials ansehen |
| Architektur | Wie der SafeKit Mirror Cluster funktioniert (Echtzeit-Replikation & Failover) | SafeKit Mirror Cluster: Echtzeit-Replikation & Failover |
| Architektur | Wie der SafeKit Farm Cluster funktioniert (Netzwerk-Lastverteilung & Failover) | SafeKit Farm Cluster: Netzwerk-Lastverteilung & Failover |
| Wettbewerbsvorteile | Vergleich: SafeKit vs. traditionelle Hochverfügbarkeits-Cluster (HA) | Vergleich: SafeKit vs. traditionelle HA-Cluster |
| Technische Ressourcen | SafeKit Hochverfügbarkeit: Dokumentation, Downloads & Testversion | Kostenlose Testversion & Technische Dokumentation |
| Vorkonfigurierte Lösungen | SafeKit Applikationsmodul-Bibliothek: Gebrauchsfertige HA-Lösungen | SafeKit Applikationsmodule für Hochverfügbarkeit |
