---
title: "Synchrone vs. asynchrone Replikation: Wie stellt SafeKit sicher, dass es keinen Datenverlust gibt?"
canonical: "https://safekit.eviden.com/de/best-practises/synchronous-replication-vs-asynchronous-replication/"
description: "Vergleichen Sie synchrone und asynchrone Replikation für Geschäftskontinuität. Erfahren Sie, wie SafeKit synchrone Replikation in Echtzeit verwendet, um in HA-Clustern keinen Datenverlust (RPO=0) zu garantieren, und warum asynchrone Replikation besser für die Notfallwiederherstellung über große Entfernungen geeignet ist."
category: "best-practises"
lang: "de"
topics: "Datenverlust oder nicht bei Anwendungs-Failover mit synchroner oder asynchroner Replikation?, Inhaltsverzeichnis, Wie funktioniert die asynchrone Replikation?, Wie funktioniert die synchrone Replikation?, Wie funktioniert die halbsynchrone Replikation?, Abschließendes Urteil: Auswahl der richtigen Replikation für hohe Verfügbarkeit, Vergleichstabelle: Synchron vs. Asynchron vs. Halbsynchron, Videoanleitung: Konfigurieren der synchronen Echtzeitreplikation und Hochverfügbarkeit, FAQ: Replikationsstrategien in Hochverfügbarkeitsclustern"
---
# Synchrone vs. asynchrone Replikation: Wie gewährleistet SafeKit keinen Datenverlust? {#synchronous-vs-asynchronous-replication-how-safekit-ensures-zero-data-loss}
## Datenverlust oder nicht bei Anwendungs-Failover mit synchroner oder asynchroner Replikation? {#data-loss-risk-synchronous-vs-asynchronous-failover}
Es gibt einen erheblichen Unterschied zwischen **synchroner Replikation und asynchroner Replikation**. Je nach Auswahl kann es während eines Anwendungs-Failovers zu Datenverlusten kommen.
* Die **synchrone Replikation**, wie sie von der [SafeKit-Software]() implementiert wird, ist für **Hochverfügbarkeit (HA)** unerlässlich. Es stellt den Failover von Transaktionsanwendungen sicher, ohne dass ein einziges Byte verloren geht: Alle festgeschriebenen Daten auf der Festplatte des Primärservers sind auch auf der Festplatte des Sekundärservers vorhanden.
* **Asynchrone Replikation** wird normalerweise für **Backup und Disaster Recovery (DR)** verwendet. Es besteht das Risiko, dass bei einem Ausfall festgeschriebene Daten auf der Festplatte des Primärservers verloren gehen, weil sie noch nicht auf den Remote-Standort kopiert wurden.
* **Halbsynchrone Replikation** ist eine alternative Lösung, bei der festgeschriebene Daten den sekundären Server erreichen, aber nicht unbedingt auf dessen Festplatte geschrieben werden.
Es ist wichtig zu verstehen, dass diese Lösungen **komplementär** sind. Während die synchrone Replikation von SafeKit Ihre Umgebung vor Hardware- oder Softwareausfällen schützt, um die Verfügbarkeit rund um die Uhr aufrechtzuerhalten, schützt eine Backup-Lösung Ihre historischen Daten vor logischen Fehlern und Cyber-Bedrohungen wie Ransomware.
Damit Sie die richtige Entscheidung bei der Auswahl der besten Architektur für Ihre Anforderungen treffen können, erläutern wir im Folgenden die technischen Mechanismen und die Auswirkungen auf das Anwendungs-Failover.
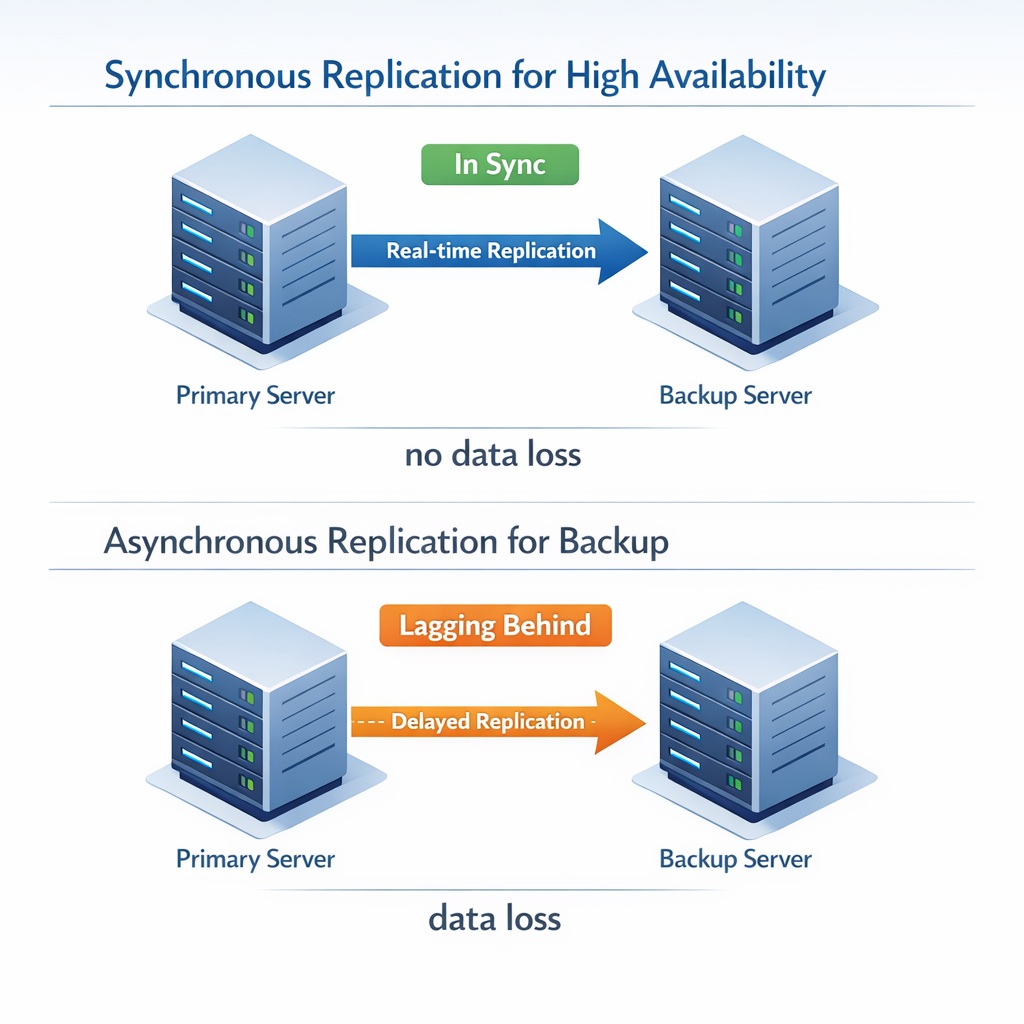
**Vergleich der Auswirkungen der synchronen und asynchronen Replikation auf Datenverlust während des Anwendungs-Failovers.**
## Inhaltsverzeichnis {#table-of-contents}
* [Datenverlust oder nicht bei Anwendungs-Failover mit synchroner oder asynchroner Replikation?](#data-loss-risk-synchronous-vs-asynchronous-failover)
* [Wie funktioniert die asynchrone Replikation?](#how-asynchronous-replication-works)
* [Wie funktioniert die synchrone Replikation?](#how-synchronous-replication-works)
* [Wie funktioniert die halbsynchrone Replikation?](#how-semi-synchronous-replication-works)
* [Abschließendes Urteil: Auswahl der richtigen Replikation für hohe Verfügbarkeit](#best-practices-synchronous-vs-asynchronous-replication)
* [Vergleichstabelle: Synchron vs. Asynchron vs. Semi-Synchronous](#comparison-synchronous-asynchronous-replication)
* [Video-Leitfaden: Konfigurieren der synchronen Echtzeitreplikation und Hochverfügbarkeit](#videoguide-synchronous-real-time-replication-ha)
* [FAQ: Replikationsstrategien in Hochverfügbarkeitsclustern](#faq-replication-high-availability)
* [SafeKit Hochverfügbarkeits-Navigations-Hub](#hub)
## Wie funktioniert die asynchrone Replikation? {#how-asynchronous-replication-works}
Bei der **asynchronen Replikation** bestätigt der Primärserver Schreibvorgänge sofort und aktualisiert Replikate später in **geplanten Stapeln** mit Verzögerung. Diese Entkopplung überwindet die Latenzprobleme der **Fernreplikation** und macht sie zu einer bevorzugten Strategie für **Sicherungen und Notfallwiederherstellung** über Remote-Standorte hinweg.
Diese Effizienz bringt jedoch die Herausforderung der **Konsistenz** mit sich, da der sekundäre Server möglicherweise veraltete Informationen enthält. Da die sekundäre Aktualisierung erfolgt, nachdem der primäre Schreibvorgang abgeschlossen ist, führt jeder Ausfall des primären Servers zum Verlust von **in-flight-Daten**.
## Wie funktioniert die synchrone Replikation? {#how-synchronous-replication-works}
Bei der von SafeKit implementierten **synchronen Replikation** stellt das System die Datenkonsistenz durch einen doppelten Bestätigungsprozess sicher, wenn ein Festplatten-E/A-Vorgang von der Anwendung oder dem Dateisystemcache auf dem Primärserver ausgeführt wird.
SafeKit wartet auf die **E/A-Bestätigung** sowohl von der lokalen Festplatte als auch vom sekundären Server, bevor es die endgültige Bestätigung zurück an die Anwendung oder den Dateisystem-Cache sendet. Dieser synchrone Mechanismus ist für das **Failover von Transaktionsanwendungen** unerlässlich und stellt sicher, dass Transaktionen auf beiden Knoten vollständig gesichert sind, bevor sie als festgeschrieben gelten.
## Wie funktioniert die halbsynchrone Replikation? {#how-semi-synchronous-replication-works}
**Halbsynchrone Replikation** dient als hybrider Ansatz für die Datenintegrität. Wie bei der synchronen Replikation wartet SafeKit auf eine Bestätigung sowohl vom primären als auch vom sekundären Server, bevor der E/A-Vorgang im Anwendungs- oder Dateisystem-Cache bestätigt wird.
Der entscheidende Unterschied liegt im **Antwortzeitpunkt** des sekundären Servers. Im halbsynchronen Fall sendet der sekundäre Server unmittelbar nach dem **Empfang der Daten im Speicher** eine Bestätigung an den primären Server und schreibt sie anschließend auf die Festplatte. Im Gegensatz dazu erfordert die **synchrone Replikation**, dass der sekundäre Server die E/A auf die physische Festplatte schreibt, bevor er die Bestätigung sendet.
## Abschließendes Urteil: Auswahl der richtigen Replikation für hohe Verfügbarkeit {#best-practices-synchronous-vs-asynchronous-replication}
Die Wahl zwischen **synchroner und asynchroner Replikation** ist ein Kompromiss zwischen absoluter Datenintegrität und Netzwerkleistung. Bei geschäftskritischen Infrastrukturen bestimmt diese Entscheidung direkt Ihr **Recovery Point Objective (RPO)**.
**Zusammenfassung:**
* **Asynchrone Replikation**: Der Goldstandard für **Backup**, aber nicht für **Hochverfügbarkeit**. Es unterstützt zwar Konnektivität über große Entfernungen, es besteht jedoch ein inhärentes Risiko eines Datenverlusts, **da die Daten des Sekundärknotens hinter den Daten des Primärknotens zurückbleiben.**
* **Synchronische Replikation:** Der Goldstandard für **Hochverfügbarkeit**, aber nicht für **Backup**. Es stellt sicher, dass die sekundären Knotendateien ein Echtzeit-Klon des primären Knotens sind, was ein **Failover ohne Datenverlust** garantiert.
* **Halbsynchrone Replikation:** Bietet einen leistungsstarken Mittelweg für **hohe Verfügbarkeit**. Durch die Bestätigung von Daten auf Speicherebene vor dem Schreiben auf die Festplatte wird die Latenz minimiert und gleichzeitig ein besserer Datenschutz im Vergleich zu asynchronen Methoden gewährleistet.
**⭐ SafeKit-Empfehlung:** Priorisieren Sie bei kritischen Anwendungen immer die **synchrone oder halbsynchrone Replikation**, um Geschäftskontinuität zu gewährleisten, die Leistung zu maximieren und die mit inkonsistentem Failover verbundenen Risiken zu beseitigen.
## Vergleichstabelle: Synchron vs. Asynchron vs. Halbsynchron {#comparison-synchronous-asynchronous-replication}
Funktion | Synchron | Halbsynchron | Asynchron
---|---|---|---
RPO (Potenzieller Datenverlust) | Null | Null | Nicht Null (Datenverlust: hängt von der letzten asynchronen Kopie ab)
Remote-I/O-Bestätigung | Nach dem Schreiben auf die Remote-Festplatte | Nach Remote-RAM-Schreiben | Wartet nicht auf Bestätigung
Auswirkungen auf die Leistung | Erfordert ein Netzwerk mit geringer Latenz – Hängt von der Roundtrip-Zeit ab (normalerweise RTT <5 ms) | Erfordert ein Netzwerk mit geringer Latenz – Hängt von der Roundtrip-Zeit ab (normalerweise RTT <5 ms) | Unterstützt Netzwerke mit geringer Latenz
Entfernungsbeschränkungen | Lokales/gestrecktes VLAN | Lokales/gestrecktes VLAN | Wide Area Network (WAN)
Am besten für | Hohe Verfügbarkeit (automatisches Failover) | Hohe Verfügbarkeit (automatisches Failover) | Backup-Lösungen (manuelles Failover)
## Videoanleitung: Konfigurieren der synchronen Echtzeitreplikation und Hochverfügbarkeit {#videoguide-synchronous-real-time-replication-ha}
### SafeKit-Video: Clustering auf Anwendungsebene (8:47) {#demo-mirror-ha-cluster}
Entdecken Sie in diesem Video, wie SafeKit einen Spiegel-HA-Cluster ohne die Komplexität eines SAN implementiert. Während diese Demonstration Microsoft SQL Server verwendet, funktioniert die Lösung für andere Datenbanken und Anwendungen identisch.
### Kapitel
1. 🎬 [2 Knoten mit SQL Server](https://www.youtube.com/watch?v=mGwEguDnnH0&t=0s) (0:32)
2. 🎬 [Konfigurieren Sie den Cluster und das Mirror.safe-Modul](https://www.youtube.com/watch?v=mGwEguDnnH0&t=32s) (3:58)
3. 🎬 [Starten und testen Sie SQL-Replikation, Migration und Failover bei Absturz](https://www.youtube.com/watch?v=mGwEguDnnH0&t=270s) (4:17)
### Schrittweise Umsetzung
* 🛠️ [Lesen Sie die Anleitung zum Einrichten eines gespiegelten Clusters unter Windows](https://safekit.eviden.com/quick-install/safekit-quick-installation-guide-for-a-new-windows-application-with-real-time-replication-and-failover/)
* 🛠️ [Lesen Sie die Anleitung zum Einrichten eines gespiegelten Clusters unter Linux](https://safekit.eviden.com/quick-install/safekit-quick-installation-guide-for-a-new-linux-application-with-real-time-replication-and-failover/)
## FAQ: Replikationsstrategien in Hochverfügbarkeitsclustern {#faq-replication-high-availability}
### Replikationstechnologie und -mechanik {#replication-technology--mechanics}
#### Sendet SafeKit bei jeder Änderung die vollständige Datei über das Netzwerk? {#safekit-byte-level-replication-vs-full-file-transfer}
**Nein.** SafeKit nutzt **Replikation auf Byteebene**. Es fängt bestimmte E/A-Änderungen in Dateien ab und repliziert nur die geänderten Bytes, wodurch der Netzwerkverkehr minimiert wird.
#### Wird die Replikation jedes Mal ausgelöst, wenn die Anwendung in ihre Dateien schreibt? {#safekit-synchronous-replication-timing}
**Nein.** Die Replikation erfolgt nur, wenn die Anwendung einen **E/A-Commit** auf die lokale Festplatte anfordert. SafeKit stellt sicher, dass diese Daten vom sekundären Server bestätigt werden, bevor der Schreibvorgang abgeschlossen wird.
#### Verlangsamt die synchrone Replikation meine Anwendung? {#synchronous-replication-performance-impact}
Die Latenz ist an die **Network Round Trip Time (RTT)** gebunden. In einem LAN sind die Auswirkungen vernachlässigbar (ähnlich wie bei NAS/SAN-Speicher). In WANs mit hoher Latenz werden häufig asynchrone Modi bevorzugt, um Leistungsengpässe zu vermeiden, und es ist eine Backup-Lösung (nicht SafeKit) erforderlich.
* * *
### Bereitstellungsstrategie: HA vs. Backup {#deployment-strategy-ha-vs-backup}
#### Wann muss ich mich zwischen synchroner und asynchroner Replikation entscheiden? {#choosing-sync-vs-async}
Wählen Sie **Synchronous** für hohe Verfügbarkeit (automatisches Failover, kein Datenverlust). Wählen Sie **Asynchron** für Backup/DR, wenn die Entfernung eine Echtzeitsynchronisierung verhindert und kein automatisches Failover erforderlich ist.
#### Unterstützt SafeKit die asynchrone Replikation? {#safekit-support-asynchronous}
**Nein.** SafeKit ist eine HA-Lösung, die keinen Datenverlust für **automatisches Failover** erfordert. Suchen Sie für rein asynchrone Anforderungen nach Backup-Lösungen.
#### Macht die Hochverfügbarkeit eine Backup-Lösung überflüssig? {#high-availability-vs-backup}
**Nein, hohe Verfügbarkeit macht eine umfassende Backup-Lösung nicht überflüssig.**
Während Echtzeit-Replikationslösungen wie [SafeKit]() eine kontinuierliche Geschäftskontinuität gewährleisten, dienen sie einem anderen Zweck als Backups. Die Echtzeitreplikation soll vor Hardwareausfällen und Serverausfällen schützen, kann jedoch nicht vor Cyberbedrohungen wie Ransomware schützen, die beide Knoten gleichzeitig verschlüsselt. Nur eine Backup-Lösung mit einer Aufbewahrungsrichtlinie kann dieses Problem lösen.
#### Wie kann ich synchrone und asynchrone Replikation kombinieren? {#combining-synchronous-asynchronous-replication}
Sie können eine **3-Knoten-Hybridarchitektur** verwenden: einen lokalen 2-Knoten-Cluster mit synchroner Replikation für HA und eine dritte Remote-Kopie über eine Backup-Lösung mit asynchroner Replikation für Disaster Recovery.
**Weitere Informationen finden Sie unter:** [SafeKit Hochverfügbarkeit und Notfallwiederherstellung (HADR)]()