Was sind RPO und RTO? Definitionen, Beispiele und HA-Strategien
Kurze Zusammenfassung: RPO vs. RTO
- RPO (Recovery Point Objective): Misst Datenverlust. Es definiert das maximale Alter der Dateien, die wiederhergestellt werden müssen, damit der Betrieb fortgesetzt werden kann.
- RTO (Recovery Time Objective): Misst Ausfallzeiten. Dabei handelt es sich um den Zeitraum, innerhalb dessen ein Geschäftsprozess wiederhergestellt werden muss.
- Der Hauptunterschied: Bei RPO geht es um Speicher/Backups, während es bei RTO um Wiederherstellungs-/Failover-Geschwindigkeit geht.
- SafeKit-Fähigkeit: Bietet 0 RPO (kein Datenverlust) und niedriges RTO (schneller Neustart) durch synchrone Replikation und automatisches Failover.
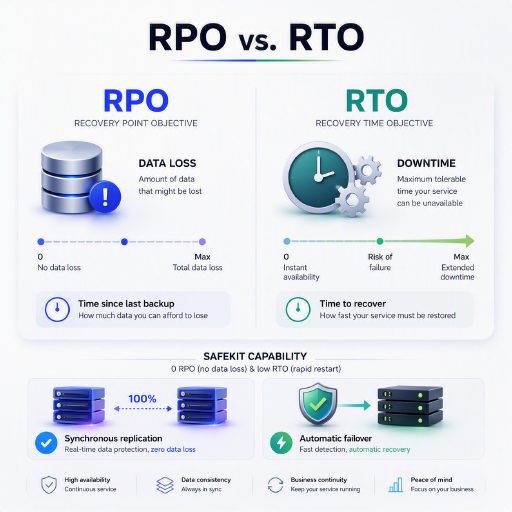
RPO vs. RTO: Vergleich von Datenverlust und Wiederherstellungszeit in SafeKit
Inhaltsverzeichnis
- Wie berechne ich RPO und RTO für eine Hochverfügbarkeits- und Geschäftskontinuitätslösung?
- Wie bestimme ich RPO und RTO für eine Backup- und Disaster-Recovery-Lösung?
- Wie erreicht ein SafeKit Mirror Cluster einen RPO von Null und einen niedrigen RTO?
- Was sind die RTO-Benchmarks für einen SafeKit Farm-Cluster mit Lastausgleich?
- Vergleichstabellen: RTO vs. RPO
- Hohe Verfügbarkeit in Aktion: Echtzeitdemos von Zero RPO und Near-Zero RTO
- Häufig gestellte Fragen zu RPO und RTO
- SafeKit Hochverfügbarkeits-Navigations-Hub
Wie berechne ich RPO und RTO für eine Hochverfügbarkeits- und Geschäftskontinuitätslösung?
Was ist Hochverfügbarkeit?
Hochverfügbarkeit (HA) ist eine technische Architektur, die sicherstellen soll, dass ein System für einen bestimmten Prozentsatz der Zeit (z. B. 99,99 %) betriebsbereit und zugänglich bleibt.
Um die in einem Business Continuity Plan definierten RPO- und RTO-Ziele zu erreichen, wird Hochverfügbarkeit typischerweise über zwei primäre Architekturen implementiert:
- Gemeinsam genutztes Festplattensystem über ein SAN: Ein traditioneller Cluster, bei dem zwei Knoten mit einem zentralen Storage Area Network (SAN) verbunden sind. Fällt ein Knoten aus, übernimmt der andere den Zugriff auf die gemeinsamen Daten.
- SANless Synchronous Replication: Eine moderne „Shared-Nothing“-Architektur – implementiert durch die SafeKit-Software – bei der Daten in Echtzeit zwischen lokalen Festplatten von zwei unabhängigen Knoten repliziert werden, indem die Notwendigkeit eines SAN entfällt.
Was ist der RPO einer Hochverfügbarkeitslösung?
RPO (Recovery Point Objective) definiert das maximal tolerierbare Volumen an Datenverlust gemessen in der Zeit. Für eine echte Hochverfügbarkeitslösung beträgt der angestrebte RPO Null.
Bei der Implementierung eines Hochverfügbarkeitsclusters mit automatischem Failover stellt ein Null-RPO sicher, dass die Anwendung ohne Datenverlust neu gestartet wird.
- Gemeinsames Festplattensystem über ein SAN: Da beide Knoten auf die exakt gleichen physischen Datenblöcke zugreifen, gibt es kein „Delta“ oder keine Verzögerung zwischen den Knoten, wodurch eine vollständige Datenkonsistenz während eines Failovers gewährleistet ist.
- Softwarebasierte synchrone Replikation: Ein SAN-loser Ansatz, bei dem jeder „Schreib“-Vorgang in Echtzeit im gesamten Netzwerk gespiegelt wird. Die Anwendung erhält erst dann eine Schreibbestätigung, wenn die Daten auf beiden Knoten sicher gespeichert sind. Dieser synchrone „Double-Write“-Prozess garantiert keinen Datenverlust, selbst wenn der Primärserver ausfällt.
Was ist der RTO einer Hochverfügbarkeitslösung?
RTO (Recovery Time Objective) stellt die maximal tolerierbare Dauer der Ausfallzeit nach einer Dienstunterbrechung dar. Im Zusammenhang mit hoher Verfügbarkeit sollte die RTO minimal sein, um einen kontinuierlichen Zugriff auf kritische Anwendungen sicherzustellen.
Um eine niedrige RTO zu erreichen, nutzt eine Hochverfügbarkeitslösung automatisches Failover, um Hardware- oder Softwarefehler zu erkennen und die Anwendung sofort neu zu starten. In einem typischen Hochverfügbarkeitscluster beträgt die RTO ungefähr eine Minute und wird wie folgt berechnet:
- Fehlererkennungszeit: Das Intervall, das das System benötigt, um einen Knoten- oder Anwendungs-Heartbeat-Ausfall zu erkennen.
- Automatische Neustartzeit: Die Zeit, die die Anwendungsdienste für die Initialisierung auf dem verbleibenden Knoten benötigen.
Wie bestimme ich RPO und RTO für eine Backup- und Disaster-Recovery-Lösung?
Was ist eine Backup-Lösung?
Eine Backup-Lösung ist eine Datenschutzstrategie, die darauf abzielt, regelmäßig Kopien von Daten auf einem sekundären Speichergerät oder in der Cloud zu erstellen. Im Gegensatz zur Hochverfügbarkeit liegt der Schwerpunkt des Backups auf der langfristigen Datenaufbewahrung und der Wiederherstellung nach Datenbeschädigung oder standortweiten Katastrophen.
Um die in einem Disaster Recovery Plan definierten RPO- und RTO-Ziele zu erreichen, wird die Sicherung typischerweise über zwei primäre Methoden implementiert:
- Geplante Snapshots: Ein Prozess, bei dem in festgelegten Abständen (z. B. täglich) punktuelle Kopien von Daten erstellt werden. Dies definiert den RPO, da alle zwischen dem letzten Snapshot und dem Fehler geänderten Daten verloren gehen.
- Offsite- oder Cloud-Wiederherstellung: Eine Architektur, bei der Daten an einem separaten physischen Ort gespeichert werden. Dies stellt zwar das Überleben der Daten sicher, führt aber zu einer höheren RTO, da Daten übertragen und wiederhergestellt werden müssen, bevor die Anwendung neu gestartet werden kann.
Was ist der RPO einer Backup-Lösung?
RPO (Recovery Point Objective) in einem Sicherungskontext definiert das Alter der Dateien, die aus dem Speicher wiederhergestellt werden müssen, damit der normale Betrieb wieder aufgenommen werden kann. Im Gegensatz zur Hochverfügbarkeit beinhaltet eine Backup-Lösung normalerweise einen RPO ungleich Null, der die seit dem letzten erfolgreichen Abschluss des Backups verstrichene Zeit darstellt.
Das Ausmaß des Datenverlusts bei einer Backup-Strategie wird durch die Backup-Häufigkeit bestimmt. Je nach Architektur kann dieser RPO zwischen Minuten und 24 Stunden liegen:
- Inkrementelle Snapshots: Eine Methode, bei der nur geänderte Datenblöcke in festgelegten Intervallen gespeichert werden. Wenn alle 4 Stunden ein Backup erstellt wird, beträgt der maximale RPO 4 Stunden, was bedeutet, dass alle zwischen dem letzten Snapshot und dem Systemabsturz erstellten Daten dauerhaft verloren gehen.
- Tägliche Vollsicherungen: Ein traditioneller Ansatz, bei dem einmal täglich (normalerweise über Nacht) eine vollständige Kopie der Daten erstellt wird. Dies führt zu einem 24-Stunden-RPO, der für unkritische Daten akzeptabel sein kann, für Transaktionsdatenbanken jedoch oft nicht ausreicht.
Was ist die RTO einer Backup-Lösung?
RTO (Recovery Time Objective) in einer Backup-Strategie ist die Zeitdauer, die benötigt wird, um Daten von einem Backup-Medium wiederherzustellen und die Anwendung wieder in einen betriebsbereiten Zustand zu versetzen. Im Gegensatz zur Hochverfügbarkeit ist die RTO für Backups deutlich länger, da manuelle oder skriptgesteuerte Wiederherstellungsprozesse erforderlich sind.
Bei einer Backup-Lösung kann die RTO je nach Datenvolumen und Wiederherstellungsarchitektur zwischen mehreren Stunden und Tagen liegen. Die Gesamtausfallzeit wird wie folgt berechnet:
- Datenübertragungszeit: Die Zeit, die erforderlich ist, um Daten vom Sicherungsspeicher (lokale Festplatten, Bänder oder Cloud) zurück zum Produktionsserver zu verschieben.
- Systemneukonfigurationszeit: Das Intervall, das erforderlich ist, um die Daten in die Anwendung zu ziehen, Indizes neu zu erstellen und die Datenintegrität zu überprüfen, bevor sich Benutzer wieder anmelden können.
Wie erreicht ein SafeKit Mirror Cluster einen RPO von Null und einen niedrigen RTO?
Was ist der SafeKit Mirror Cluster?
Der SafeKit Mirror Cluster ist eine softwarebasierte Hochverfügbarkeitslösung, die eine „Shared-Nothing“-Architektur implementiert. Im Gegensatz zu herkömmlichen Clustern, die ein teures SAN erfordern, nutzt SafeKit die lokalen Ressourcen von zwei Standardservern, um eine äußerst belastbare Umgebung zu schaffen.
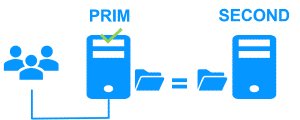
Um maximale Betriebszeit und Datenschutz im Rahmen Ihres Business Continuity Plan zu gewährleisten, arbeitet der SafeKit-Spiegelcluster über zwei integrierte Mechanismen:
- Synchronische Replikation in Echtzeit: SafeKit spiegelt Daten über das Netzwerk zwischen den lokalen Festplatten der primären und sekundären Knoten. Dadurch wird sichergestellt, dass der RPO Null ist, da jedes Datenbyte auf beiden Servern gesichert wird, bevor eine Transaktion abgeschlossen wird.
- Automatischer IP- und Anwendungs-Failover: Wenn der Primärknoten ausfällt, erkennt SafeKit automatisch den Heartbeat-Verlust und stellt die Anwendung und ihre virtuelle IP-Adresse auf dem Sekundärknoten wieder her. Dies führt zu einer RTO von etwa einer Minute und sorgt für eine nahtlose Servicekontinuität.
Was ist der RPO eines SafeKit Mirror Clusters?
Der RPO eines SafeKit-Spiegelclusters ist Null, da die Datenreplikation zwischen Knoten synchron und Echtzeit erfolgt.
Diese Null-Datenverlust-Garantie wird durch einen Schreibbestätigungsprozess erreicht: Ein Festplattenschreibvorgang wird der Anwendung erst dann bestätigt, wenn er erfolgreich auf die lokalen Festplatten sowohl des Primär- als auch des Sekundärknotens geschrieben wurde.
Im Gegensatz dazu ist bei der asynchronen Replikation der RPO größer als Null. Da es zwischen dem primären Schreibvorgang und dem sekundären Update zu einer Verzögerung kommt, führt ein Fehler zu einem Datenverlust während des Failovers auf den sekundären Server. Für geschäftskritische Geschäftskontinuität ist die synchrone Replikation die einzige Möglichkeit, sicherzustellen, dass die Anwendung mit 100 % Datenintegrität neu startet.
Was ist die RTO eines SafeKit Mirror Clusters?
In einer Standardkonfiguration beträgt die RTO eines SafeKit-Spiegelclusters ungefähr eine Minute. SafeKit bietet die Flexibilität, Hochverfügbarkeit entweder auf Anwendungsebene oder auf VM-Ebene zu implementieren, wobei sich beides unterschiedlich auf die Wiederherstellungszeit auswirkt:
- HA auf Anwendungsebene: Dies ist der optimierte SafeKit-Ansatz, bei dem die Software bestimmte Anwendungsdienste überwacht.
- Hardwarefehler: RTO = Heartbeat-Timeout (Standard 30 Sekunden) + Anwendungsneustartzeit.
- Softwarefehler: RTO = Anwendungsstoppzeit + Anwendungsneustartzeit.
- Hauptvorteil: Da das Betriebssystem bereits auf dem sekundären Knoten ausgeführt wird, gibt es keine Verzögerung beim Booten des Betriebssystems, was zu einer schnellstmöglichen Wiederherstellung für Geschäftskontinuität führt.
- HA auf VM-Ebene: In diesem Szenario schützt SafeKit die gesamte Umgebung der virtuellen Maschine.
- Fehlerbehebung: RTO = Fehlererkennung + OS-Neustartzeit + Anwendungsneustartzeit.
- Technischer Kompromiss: Die RTO ist naturgemäß länger (mehrere Minuten), da der Sekundärknoten einen vollständigen Kaltstart des Betriebssystems durchführen muss, bevor die Anwendung überhaupt mit der Initialisierung beginnen kann.
Durch die Verwendung von Hochverfügbarkeit auf Anwendungsebene eliminiert SafeKit die „Neustartstrafe“, die mit der Standardvirtualisierung einhergeht, und stellt sicher, dass Ihr Business Continuity Plan die geringstmögliche Ausfallzeit erreicht.
Was sind die RTO-Benchmarks für einen SafeKit-Farmcluster mit Lastausgleich?
Was ist der SafeKit Farm-Cluster?
Der SafeKit Farm Cluster ist eine softwarebasierte Hochverfügbarkeitslösung, die für zustandslose Anwendungen (wie Webserver) entwickelt wurde, die sowohl Skalierbarkeit als auch Redundanz erfordern. Im Gegensatz zu einem Spiegelcluster, der sich auf die Datenreplikation konzentriert, verteilt ein Farmcluster den eingehenden Datenverkehr auf mehrere aktive Knoten.
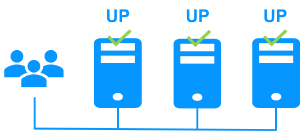
Um Geschäftskontinuität für Umgebungen mit hohem Datenverkehr aufrechtzuerhalten, arbeitet der SafeKit-Farmcluster über zwei Kernmechanismen:
- Netzwerklastenausgleich: SafeKit verwendet eine virtuelle IP-Adresse, um eingehenden Netzwerkverkehr auf eine „Farm“ mehrerer aktiver Server zu verteilen. Dadurch wird sichergestellt, dass kein einzelner Server überlastet wird und die Leistung der Anwendung maximiert wird.
- Automatische Fehlererkennung und Neukonfiguration: Wenn ein Knoten in der Farm ausfällt, erkennt SafeKit den Ausfall über Heartbeats und verteilt seinen Datenverkehr sofort auf die verbleibenden fehlerfreien Knoten. Dies sorgt für eine RTO von nahezu Null für den gesamten Dienst, da andere Knoten bereits aktiv und bereit sind, die Last aufzunehmen.
Wie hoch ist der RPO eines SafeKit Farm-Clusters?
Der RPO (Recovery Point Objective) für einen SafeKit Farm-Cluster gilt im Allgemeinen als Nicht anwendbar (N/A). Dies liegt daran, dass ein Farmcluster speziell für zustandslose Anwendungen konzipiert ist, bei denen Daten nicht lokal auf den Knoten gespeichert werden.
Da sich ein Farmcluster auf den Netzwerklastausgleich und nicht auf die Datensynchronisierung konzentriert, findet keine Datenreplikation zwischen den Knoten innerhalb des Clusters selbst statt. In einem typischen Business Continuity Plan mit einer Farmarchitektur:
- Zustandslose Operationen: Alle Knoten in der Farm sind identisch und enthalten keine persistenten Daten; Daher ist bei einem Knotenausfall kein „Datenverlust“ messbar.
- Externe Datenspeicherung: Wenn die Anwendung Datenpersistenz erfordert, wird dies normalerweise von einem separaten Backend SafeKit Mirror Cluster verwaltet, bei dem der RPO dann Null wäre.
Wie hoch ist die RTO eines SafeKit Farm-Clusters?
In einer Farmarchitektur wird die RTO auf nur wenige Sekunden reduziert, da alle Knoten normalerweise gleichzeitig aktiv sind. Die Wiederherstellungszeit wird durch die Geschwindigkeit bestimmt, mit der der Cluster seine Verkehrsverteilung neu konfiguriert:
- Hardwarefehler: Der RTO entspricht dem Fehlererkennungs-Timeout über alle Überwachungskanäle hinweg (Standard sind einige Sekunden). Sobald der Heartbeat-Verlust erkannt wird, werden die virtuellen IP-Lastausgleichsfilter automatisch neu konfiguriert, um den Datenverkehr an die verbleibenden fehlerfreien Knoten umzuleiten.
- Softwarefehler oder geplanter Neustart: Die RTO wird als Anwendungsstoppzeit plus die Anwendungsneustartzeit auf diesem bestimmten Knoten berechnet, während der die anderen Knoten in der Farm weiterhin den gesamten eingehenden Datenverkehr verarbeiten.
Dieser „Aktiv-Aktiv“-Mechanismus stellt sicher, dass bei zustandslosen Diensten die Auswirkungen auf die Geschäftskontinuität für den Endbenutzer nahezu nicht wahrnehmbar sind, da der Dienst nicht auf einem neuen Standby-Knoten initialisiert werden muss.
Vergleichstabellen: RTO vs. RPO
Semantische Definition: RTO vs. RPO
| Metrisch | Akronym | Definition | Fokusbereich |
|---|---|---|---|
| Erholungszeitziel | RTO | Die angestrebte Zeitdauer für die Wiederherstellung eines Geschäftsprozesses nach einem Ausfall. | Verfügbarkeit / Ausfallzeit |
| Wiederherstellungspunktziel | RPO | Das maximale Alter der Dateien, die aus der Sicherung wiederhergestellt werden müssen, damit der Betrieb fortgesetzt werden kann. | Datenverlust/-integrität |
Hochverfügbarkeit (HA) vs. Standard-Backup
| Funktion | Backup-Lösungen | Hohe Verfügbarkeit (SafeKit) |
|---|---|---|
| Wiederherstellungsautomatisierung | Manueller Eingriff | Automatisches Failover |
| Ziel-RTO | Stunden bis Tage | Sekunden bis ~1 Minute |
| Ziel-RPO | > 0 (Letzter Sicherungspunkt) | 0 (synchrone Replikation) |
RTO- und RPO-Benchmarks für SafeKit-Cluster
| Architektur | Anwendungsfall | RTO (Verfügbarkeit) | RPO (Datenverlust) |
|---|---|---|---|
| Spiegelcluster | Echtzeit-Replikation | ~1 Min. (Herzschlag + Neustart) | 0 (Kein Datenverlust) |
| Farm-Cluster | Netzwerklastenausgleich | Ein paar Sekunden | N/A (Staatenlos) |
Hochverfügbarkeit in Aktion: Echtzeitdemos von Zero RPO und Near Zero RTO
Video: Erreichen von Null RPO und niedrigem RTO in einem SafeKit Mirror Cluster (8:47)
Sehen Sie, wie SafeKit mit einem kritischen Fehler umgeht. Dieses Video demonstriert die synchrone Replikation, um sicherzustellen, dass in einer SQL-Datenbank keine Daten verloren gehen (RPO 0) und den automatischen Neustart von Diensten auf dem sekundären Knoten (Niedriges RTO).
Kapitel
- 🎬 2 Knoten mit SQL Server (0:32)
- 🎬 Konfigurieren Sie den Cluster und das Mirror.safe-Modul (3:58)
- 🎬 SQL-Replikation, Migration und Failover bei Absturz starten und testen (4:17)
Video: Erreichen einer RTO nahe Null in einem SafeKit-Farm-Cluster (5:03)
Sehen Sie, wie SafeKit eine Apache-Webfarm verwaltet, um sowohl Leistungsskalierung als auch sofortiges Failover bereitzustellen.
Kapitel
- 🎬 2 Knoten mit Apache (0:13)
- 🎬 Konfigurieren Sie den Cluster und das farm.safe-Modul (2:20)
- 🎬 Netzwerklastenausgleich starten und testen, Failover bei Absturz (2:30)
FAQ: Optimierung von RPO und RTO für Geschäftskontinuität
Können RPO und RTO Null sein?
Ja. Das Erreichen eines Null-RPO bedeutet keinen Datenverlust, was durch synchrone Datenspiegelung möglich ist. Ein RTO nahe Null wird durch automatisierte Failover-Software wie SafeKit erreicht, die Ausfälle erkennt und Anwendungen auf einem sekundären Knoten innerhalb von Sekunden oder Minuten neu startet.
Was ist wichtiger: RPO oder RTO?
Keines von beiden ist von Natur aus wichtiger; Sie erfüllen unterschiedliche Rollen. RPO (Recovery Point Objective) konzentriert sich auf Datenverlust – wie viele Daten Sie sich leisten können, zu verlieren. RTO (Recovery Time Objective) konzentriert sich auf Ausfallzeiten – wie schnell Sie wieder online sein müssen. Für geschäftskritische Anwendungen müssen beide minimiert werden.
Was ist der Unterschied in RPO und RTO zwischen SafeKit auf Anwendungsebene und VM-Ebene?
Während beide über synchrone Replikation einen RPO von 0 gewährleisten, unterscheiden sie sich in der Wiederherstellungszeit:
- Anwendungsebene: Schnelleres RTO (ca. 1 Minute), da nur Anwendungsdienste auf einem bereits laufenden Betriebssystem neu gestartet werden. Es erkennt auch bestimmte Software-/Prozessabstürze.
- VM-Ebene: Höheres RTO, da die gesamte virtuelle Maschine auf dem sekundären Host neu gestartet werden muss. Obwohl es anwendungsunabhängig ist, fehlt eine detaillierte Überwachung der Anwendungsprozesse selbst.
Was ist der Unterschied zwischen HA- und Backup-Lösungen hinsichtlich RTO?
Hochverfügbarkeit (High Availability, HA) bietet in der Regel eine viel niedrigere RTO (Sekunden bis Minuten), da lokale Ausfälle automatisch behandelt werden. Disaster Recovery mit Backup-Lösungen (DR) hat in der Regel eine höhere RTO (Stunden bis Tage), da es sich um die Wiederherstellung von Daten und Diensten an einem geografisch entfernten Standort nach einer größeren Katastrophe handelt.
Wie erreiche ich das beste RPO und RTO zwischen entfernten Standorten?
Erreichen eines Null RPO und RTO nahe Null über entfernte Standorte hinweg erfordert eine Kombination von synchrone Replikation und ein Erweitertes LAN (Stretched VLAN) :
- Erweitertes LAN/Stretched VLAN: Durch die Ausweitung desselben Subnetzes (Layer 2) über zwei Rechenzentren können Sie eine Anwendung von Standort A zu Standort B verschieben, ohne ihre IP-Adresse zu ändern, wodurch komplexe DNS-Updates vermieden werden.
- Die SafeKit-Lösung: SafeKit nutzt dies, indem es eine softwaredefinierte virtuelle IP (VIP) bereitstellt, die zwischen Standorten wechselt. Der Datenverkehr wird mithilfe von Gratuitous ARP (GARP) sofort zur sekundären Website umgeleitet.
Dies liefert einen RPO = 0 (Echtzeitspiegelung) und einen minimalen RTO (Failover in ca. 1 Minute) ohne menschliches Eingreifen.
Warum ist die Kombination von Hochverfügbarkeit und Backup für die Optimierung von RPO und RTO unerlässlich?
Die Kombination von Hochverfügbarkeit (HA) mit einer Backup-Lösung ist die einzige Möglichkeit, eine Wiederherstellungsstrategie zu erreichen, die das Beste aus beiden Welten vereint. Obwohl sie oft gemeinsam besprochen werden, lösen sie verschiedene Teile der RPO/RTO-Gleichung:
- Hohe Verfügbarkeit (über SafeKit): Optimiert für RTO und RPO nahe Null bei Hardware- oder Softwareausfällen. Durch die Verwendung der synchronen Replikation in Echtzeit ist der Sekundärserver immer auf dem neuesten Stand. Wenn der primäre Server ausfällt, wird der Dienst sofort und ohne Datenverlust auf dem sekundären Server neu gestartet.
- Backup-Lösungen: Schützen Sie sich vor Problemen der Datenintegrität (wie Ransomware oder versehentlichem Löschen). Da HA Änderungen sofort repliziert, wird ein Virus oder ein gelöschter Datenbankeintrag „getreu“ auf dem Standby-Server repliziert. Mit einem Backup können Sie zu einem Zeitpunkt zurückgehen, bevor die Beschädigung auftrat.
- Der Hybrid-Ansatz: Für maximale Ausfallsicherheit verwenden Unternehmen eine 3-Knoten-Hybridarchitektur. Dazu gehören ein lokaler Cluster mit zwei Knoten und synchroner Replikation für sofortige HA und eine dritte Remote-Kopie (asynchron) für die Notfallwiederherstellung. Dieser mehrschichtige Schutz stellt sicher, dass Sie über eine „Live“-Kopie für die sofortige Wiederherstellung und eine „historische“ Kopie für die Datensicherheit verfügen.
🔍 SafeKit Hochverfügbarkeit Navigation Hub
Entdecken Sie SafeKit: Funktionen, technische Videos, Dokumentation und kostenlose Testversion
| Ressourcentyp | Beschreibung | Direkter Link |
|---|---|---|
| Hauptfunktionen | Warum SafeKit für einfache und kosteneffiziente Hochverfügbarkeit wählen? | Warum SafeKit für Hochverfügbarkeit? |
| Anwendungsfälle | Erfahren Sie, wie SafeKit die Hochverfügbarkeit kritischer Infrastrukturen gewährleistet | Alle Anwendungsfälle ansehen (OEM-Software, Edge-Server, SCADA und mehr) |
| Bereitstellungsmodell | All-in-One SANlose HA: Shared-Nothing Software-Clustering | SafeKit All-in-One SANlose HA ansehen |
| HA-Strategien | SafeKit: Infrastruktur (VM) vs. Hochverfügbarkeit auf Anwendungsebene | SafeKit HA & Redundanz: VM vs. Anwendungsebene |
| Technische Spezifikationen | Technische Einschränkungen für SafeKit-Clustering | Technische Einschränkungen von SafeKit ansehen |
| Videos | SafeKit: Konfiguration der Hochverfügbarkeit & Failover-Demos | SafeKit Failover-Tutorials ansehen |
| Architektur | Wie der SafeKit Mirror Cluster funktioniert (Echtzeit-Replikation & Failover) | SafeKit Mirror Cluster: Echtzeit-Replikation & Failover |
| Architektur | Wie der SafeKit Farm Cluster funktioniert (Netzwerk-Lastverteilung & Failover) | SafeKit Farm Cluster: Netzwerk-Lastverteilung & Failover |
| Wettbewerbsvorteile | Vergleich: SafeKit vs. traditionelle Hochverfügbarkeits-Cluster (HA) | Vergleich: SafeKit vs. traditionelle HA-Cluster |
| Technische Ressourcen | SafeKit Hochverfügbarkeit: Dokumentation, Downloads & Testversion | Kostenlose Testversion & Technische Dokumentation |
| Vorkonfigurierte Lösungen | SafeKit Applikationsmodul-Bibliothek: Gebrauchsfertige HA-Lösungen | SafeKit Applikationsmodule für Hochverfügbarkeit |
