Kubernetes K3s Hochverfügbarkeit: Synchrone Replikation und Failover mit 2 Knoten
K3s HA vereinfachen: Warum SafeKit MetalLB und Longhorn vorziehen?
Während der Standard-Open-Source-Stack (MetalLB + Longhorn) für K3s für große Rechenzentren leistungsstark ist, führt er für lokale Standorte mit 2 Knoten zu übermäßiger Komplexität. SafeKit vereinfacht die K3s-Umgebung, indem es eigenständige Netzwerk- und Speichertools durch eine einzige, konsolidierte HA-Engine ersetzt.
Warum SafeKit für die Hochverfügbarkeit (HA) von 2-Knoten-K3s verwenden?
- Echte Hochverfügbarkeit mit 2 Knoten: SafeKit bietet volle Redundanz mit nur 2 Knoten und eliminiert die Anforderung von 3 Knoten für das etcd- Quorum.
- Kein Datenverlust (RPO = 0): Ersetzt Block-Speicher mit hohem Overhead durch synchrone Replikation auf Byte-Ebene für lokale SSD-Leistung.
- Flexibler Schutz auf Dateiebene: SafeKit führt eine hostbasierte Replikation auf Dateiebene durch, die für die Anwendung völlig transparent ist. Es schützt nicht nur Datenbanken, sondern auch alle zugehörigen Ordner und Daten. Sie können vorhandene Ordner genau dort replizieren, wo sie installiert sind, sogar auf der Systemfestplatte.
- Integrierte virtuelle IP (VIP): Verwaltet die Cluster-IP nativ auf Kernel-Ebene, wodurch separate MetalLB- Konfigurationen überflüssig werden.
- Automatisches Failover und Failback: Löst bei einem Fehler einen sofortigen Übergang zum sekundären Knoten aus; sobald der primäre Knoten wieder funktionsfähig ist, führt SafeKit eine automatische Datensynchronisierung ohne manuelles Eingreifen aus.
- Extrem geringer Overhead: SafeKit arbeitet ohne den hohen Verwaltungsaufwand von Storage-Pods (CSI/Longhorn) und Networking-Pods (CNI/MetalLB), die von Standard-Stacks benötigt werden, wodurch kritischer RAM und CPU für Ihre Anwendungen freigegeben werden.
- IT-Generalistenfreundlich: Ersetzt komplexe Infrastruktur-YAML für Netzwerke und Speicher durch eine einfache Web-GUI und automatisierte Bereitstellungsskripte, sodass Sie sich nur auf Ihre Anwendungen konzentrieren können.
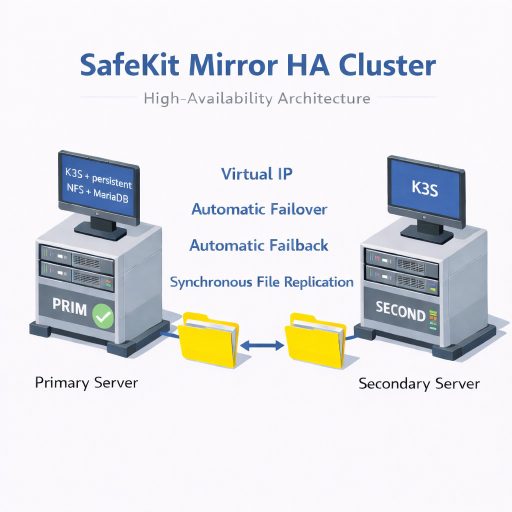
Shared-Nothing-Hochverfügbarkeit (HA) für 2-Knoten-K3s-Cluster
⚡ Kurzanleitung zur Installation Kubernetes-HA-Clusters >
Inhaltsverzeichnis
- Wie implementiert die SafeKit-Software einfach einen Kubernetes K3s-Hochverfügbarkeitscluster?
- Wie funktioniert der SafeKit-Mirror-Cluster mit Kubernetes K3S?
- Einschränkungen SafeKit Hochverfügbarkeit
- Vergleich: SafeKit vs. Standard-K3s-Stack (MetalLB & Longhorn)
- Videoanleitung: Konfigurieren eines SafeKit Mirror-HA-Cluster
- 🔍 SafeKit entdecken
Wie implementiert die SafeKit-Software einfach einen Kubernetes K3s-Hochverfügbarkeitscluster?
Wie implementiere ich Hochverfügbarkeit für einen 2-Knoten Kubernetes-K3s-Cluster?
Sie können Hochverfügbarkeit (HA) für einen 2-Knoten Kubernetes-K3s-Cluster mit dem SafeKit k3s.safe mirror-Modul implementieren. Diese Lösung ermöglicht Ihnen die Bereitstellung einer redundanten Umgebung, ohne dass ein externer NFS-Speicher, eine dedizierte externe Konfigurationsdatenbank oder spezielle Kubernetes Kenntnisse erforderlich sind.
Warum K3s für Edge- und IoT-Computing verwenden?
K3s ist die bevorzugte Kubernetes Engine für IoT und Edge Computing, da es sich um eine schlanke, zertifizierte Distribution handelt, die für ressourcenbeschränkte Umgebungen entwickelt wurde. Es vereinfacht den Betriebsaufwand von Standard Kubernetes bei voller Kompatibilität.
Was sind die wichtigsten Merkmale des k3s.safe mirror-Modul?
Das Modul k3s.safe bietet einen umfassenden HA-Stack für K3s durch die Implementierung von:
- Zwei aktive Knoten: Führt 2 aktive K3s-Master/Agenten gleichzeitig aus, um Pods zu hosten.
- Datenbankreplikation: Echtzeitreplikation der MariaDB-Konfigurationsdatenbank zwischen den Knoten.
- Persistenter Speicher: Replikation persistenter Volumes über einen integrierten NFS-Client-Dynamic-Provisioner (nfs-client).
- Netzwerkkontinuität: Beinhaltet eine virtuelle IP-Adresse für nahtlosen Client-Zugriff.
- Automatisierte Wiederherstellung: Volle Unterstützung für automatisches Failover und Failback.
Welche Anwendungen und Umgebungen kann SafeKit über K3s hinaus schützen?
SafeKit ist eine vielseitige Hochverfügbarkeitslösung für Windows und Linux, die weit über K3s-Mirror-Cluster hinausgeht. Sie ermöglicht synchrone Echtzeit-Replikation und automatisches Failover für eine breite Palette kritischer Workloads, darunter:
- Virtuelle und physische Umgebungen: Vollständige Hyper-V oder KVM Virtual-Machines.
- Container-Orchestrierung: Docker, Podman-Umgebungen.
- Daten & Services: Individuelle Dateiverzeichnisse, Dienste und verschiedene Datenbanken.
- Cloud-Infrastruktur: Hohe Verfügbarkeit für Cloud-Anwendungen.
SafeKit bietet Farm-Cluster auch natives Netzwerk-Lastausgleichs- und Failover für zustandslose Anwendungen wie Webserver.
💡 Die vollständige Liste der unterstützten HA-Lösungen finden Sie hier.
Wie erreicht SafeKit die Hochverfügbarkeit von K3s?
Architektur und Redundanzlogik für einen 2-Knoten-K3s-Cluster mit SafeKit
| 2-Knoten-K3s-Cluster | SafeKit PRIM (Primärknoten) | SafeKit SECOND (Sekundärknoten) |
|---|---|---|
| Workload-Ausführung | Die K3s-Master- und Agent-Dienste sind aktiv, verwalten die Cluster-Orchestrierung und führen Pods aus. | Die K3s-Master- und Agent-Dienste bleiben aktiv und bieten parallele Verarbeitung und Hochverfügbarkeit. |
| NFS-Speicher & PVs | • Hostet virtuelle IP und NFS-Port • Verwaltet aktive exportierte NFS-Freigaben • Speichert K3s-Persistenzvolumen (PVs) | Synchrone Spiegelung: SafeKit repliziert alle persistenten Volumes in Echtzeit, um einen Datenverlust von null zu gewährleisten. |
| Konfigurationsdatenbank | • Virtuelle IP-Adresse und MariaDB-Port des Hosts • Verwaltet die aktive K3s-Konfigurationsdatenbank | Datenbankreplikation: Die MariaDB Datenbank wird synchron gespiegelt, wodurch der Clusterstatus für das Failover erhalten bleibt. |
Automatischer Failover-Mechanismus: Im Falle eines Ausfalls des primären Knotens migriert SafeKit die virtuellen IPs und Speicherdienste automatisch auf den sekundären Knoten, um einen unterbrechungsfreien Dienst für den K3s-Cluster zu gewährleisten.
Wie funktioniert der SafeKit-Mirror-Cluster mit Kubernetes K3S?
Schritt 1: Replikation von Dateien auf Byte-Ebene in einem Mirror-Cluster
Diese Phase veranschaulicht die Hochverfügbarkeitsarchitektur zwischen Server 1 (PRIM) und Server 2 (SECOND). Beide Server führen K3s-Master- und Agent-Komponenten aus, wie in der Architektur-Tabelle definiert.
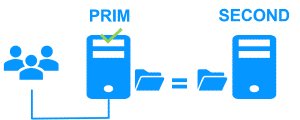
Derzeit sind die virtuelle IP (VIP), der persistente NFS-Speicher und MariaDB nur auf Server 1 (PRIM) aktiv. Die K3s-Masterkomponenten auf beiden Knoten synchronisieren sich miteinander, indem sie über die virtuelle IP und den MariaDB-Port auf den Clusterstatus zugreifen. SafeKit implementiert die synchrone Replikation von MariaDB und persistenten NFS-Dateien, wodurch im Falle eines Ausfalls kein Datenverlust (RPO = 0) entsteht.
Die K3s-Master verteilen die Arbeitslast auf beide (oder mehr) Knoten, indem sie direkt mit den K3s-Agenten kommunizieren. Externe Clients verbinden sich mit dem
Die virtuelle IP-Adresse des Clusters auf dem PRIM Knoten. Mithilfe von Standard Kubernetes Mechanismen leitet der K3s-Master den Datenverkehr an Pods weiter, die auf die Knoten verteilt sind. In ähnlicher Weise greifen Pods über die virtuelle IP und den NFS-Port auf ihre persistenten Volumes (PVs) auf dem PRIM Server zu.
Schritt 2: Automatische Failover und Servicekontinuität
Wenn Server 1 (PRIM) ausfällt, übernimmt Server 2 (SECOND) automatisch den Clusterbetrieb, um die Kontinuität zu gewährleisten.
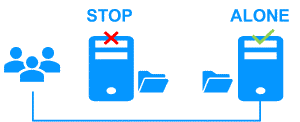
SafeKit erkennt den Fehler und migriert die virtuelle IP-Adresse des Clusters sofort auf Server 2. Anschließend versetzt es die lokalen MariaDB und NFS-Dienste in einen aktiven Zustand. Aufgrund der synchronen Replikation, die in Schritt 1 durchgeführt wurde, sind alle MariaDB Datenbanken und NFS Persistent Volume (PV)-Dateien auf Server 2 bereits auf dem neuesten Stand, wodurch ein Datenverlust ausgeschlossen wird.
Da der Cluster-Status erhalten bleibt, setzt der K3s-Master auf Server 2 die Ausführung fort. Er erkennt den Verlust des Agenten von Server 1 und plant die betroffenen Pods automatisch auf die verbleibenden aktiven K3s-Agenten um. Die gesamte Failover-Zeit (RTO) ist die Summe aus dem Fehlererkennungsintervall (Standard: 30 Sekunden) und der Zeit, die K3s-Komponenten zum Initialisieren auf dem sekundären Knoten benötigen.
Während Server 1 offline ist, laufen MariaDB und NFS-Dienste auf Server 2 weiter und schreiben Änderungen nur lokal.
Schritt 3: Failback und automatische Reintegration
Das Failback erfolgt, wenn Server 1 neu gestartet wird, nachdem das ursprüngliche Problem behoben wurde. SafeKit synchronisiert die MariaDB und NFS-Dateien automatisch neu und aktualisiert nur die Daten, die auf Server 2 während der Ausfallzeit geändert wurden. Dieser Reintegrationsprozess ist nicht störend; die K3s-Master- und Agent-Komponenten laufen ohne Unterbrechung auf Server 2 weiter.
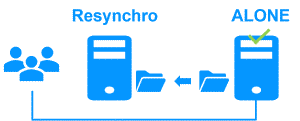
SafeKit optimiert die Wiederherstellungszeit auf der Grundlage der Art und Weise, wie der Server heruntergefahren wurde:
- Sauberer Shutdown: Wenn SafeKit auf Server 1 absichtlich gestoppt wurde, werden nur die spezifischen modifizierten Zonen innerhalb der Dateien mithilfe von Änderungsverfolgungs-Bitmaps erneut synchronisiert. Dies gewährleistet eine ultraschnelle Reintegration.
- Systemabsturz (z. B. Stromausfall): Wenn Server 1 einen nicht ordnungsgemäßen Herunterfahren erlitten hat, werden die Änderungsbitmaps aus Sicherheitsgründen umgangen. SafeKit synchronisiert stattdessen alle Dateien mit einem Änderungszeitstempel, der neuer ist als der letzte festgelegte Synchronisationspunkt, wodurch die vollständige Datenintegrität gewährleistet wird.
Schritt 4: Wiederherstellung der Hochverfügbarkeit und Lastverteilung
Nach der Reintegration kehrt der Cluster in den vollständigen mirror zurück und spiegelt den in Schritt 1 beschriebenen Zustand wider. Das System befindet sich wieder in einem hochverfügbaren Zustand: MariaDB und NFS-Dienste bleiben auf Server 2 aktiv, während SafeKit die Echtzeit-Replikation aller Dateiaktualisierungen zurück auf Server 1 durchführt.
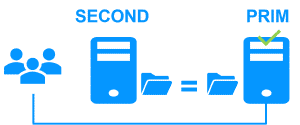
Der K3s-Master und der K3s-Agent werden auf Server 1 automatisch neu gestartet. Der Kubernetes Scheduler erkennt Server 1 nun als funktionierenden Knoten und kann mit der Neuplanung von Pods beginnen, um die Arbeitslast auf beide Server zu verteilen.
Wenn der Administrator es vorzieht, dass die MariaDB und NFS-Dienste auf Server 1 ausgeführt werden (Wiederherstellung der ursprünglichen PRIM Rolle), kann ein Wechsel manuell über die Webkonsole zu einem geeigneten Zeitpunkt oder automatisiert über die Konfigurationseinstellungen ausgelöst werden.
Wie konfiguriere ich einen SafeKit-Mirror-Cluster?
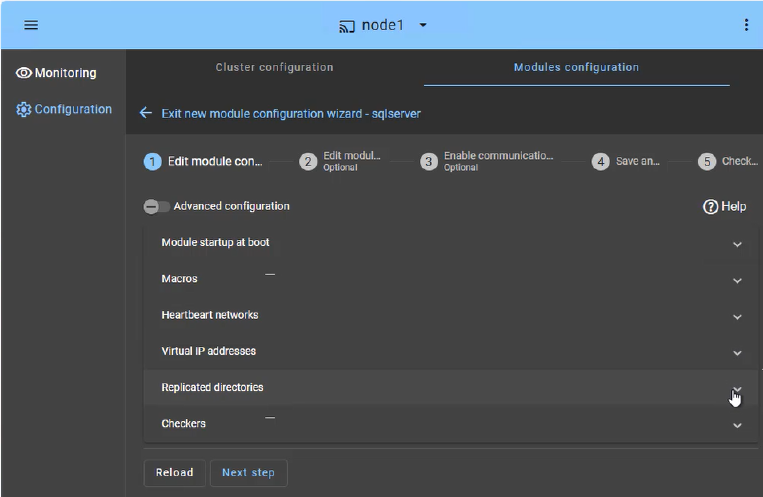
Die SafeKit Webkonsole bietet eine intuitive Schnittstelle zur Orchestrierung der Hochverfügbarkeit für Ihre kritischen Anwendungen. In nur wenigen Schritten können Sie einen SafeKit-Mirror-Cluster konfigurieren, um die Geschäftskontinuität zu gewährleisten:
- Anwendungsfailover (Registerkarte „Makros“): Definieren Sie die spezifischen Anwendungsdienste, die im Falle eines Ausfalls automatisch neu gestartet werden sollen.
- Heartbeat-Netzwerk(e): Dedizierte Kommunikationspfade, die von Clusterknoten verwendet werden, um den Zustand und die Verfügbarkeit der anderen Knoten kontinuierlich zu überwachen und Failover-Entscheidungen zu synchronisieren.
- Virtuelles IP-Management: Richten Sie die virtuelle IP (VIP) für eine transparente Client-Wiederverbindung nach einem Failover ein.
- Echtzeit-Replikation: Wählen Sie die kritischen Verzeichnisse für die hostbasierte, synchrone Replikation auf Byteebene aus.
- Checkers: Überwachen Sie den Zustand der Anwendung und lösen Sie eine automatische Wiederherstellung aus, wenn ein Prozessfehler erkannt wird.
Das SafeKit Cluster verfügt über eine spezielle Split-Brain-Prüfung, um Probleme mit der Netzwerktrennung zu lösen, ohne dass ein dritter Witness-Computer oder ein zusätzliches Heartbeat-Netzwerk erforderlich ist. Erfahren Sie mehr über Heartbeat, Failover und Quorum in einem Cluster.
Wie überwacht man einen SafeKit-Mirror-Cluster?

Die SafeKit Managementkonsole bietet eine einheitliche Ansicht Ihrer Hochverfügbarkeitsinfrastruktur. Sie ermöglicht es Administratoren, den Betriebsstatus des Clusters zu überwachen und die Datensynchronisierung in Echtzeit zu verfolgen.
Bei einem Mirror-Cluster mit zwei Knoten zeigt die Konsole die Rollen der einzelnen Server deutlich an:
- PRIM (Primär): Der aktive Knoten, auf dem die Anwendung derzeit ausgeführt wird und der die virtuelle IP-Adresse verwaltet. Er führt Schreibvorgänge in den lokalen Speicher und die Echtzeitreplikation auf den sekundären Knoten durch.
- SECOND (Sekundär): Der Standby-Knoten empfängt synchrone Updates auf Byte-Ebene. Er ist bereit, sofort die Übernahme zu übernehmen, falls der primäre Knoten ausfällt.
- ALONE Status: Warnt Sie visuell, wenn der Cluster auf einem einzelnen Knoten läuft (z. B. während der Wartung oder nach einem Fehler), was darauf hinweist, dass die Redundanz vorübergehend verloren gegangen ist.
- Resynchronisierungsfortschritt: Wenn sich ein ausgefallener Knoten erholt, wird sein Status während der Hintergrunddatenneuintegration orange, um sicherzustellen, dass es während der „Rückkehr zum Normalzustand“-Phase keine Ausfallzeiten gibt.
Über einfache Status-Symbole hinaus bietet die Schnittstelle eine Failover-Orchestrierung mit einem Klick, mit der Sie die primäre Rolle für geplante Wartungsarbeiten manuell neu zuweisen und gleichzeitig die kontinuierliche Verfügbarkeit für Benutzeraktivitäten gewährleisten können.
Einschränkungen SafeKit Hochverfügbarkeit
| Grenzwert / Anforderung | Grund und Auswirkung | Empfohlene Alternative |
|---|---|---|
| Replikationsgröße: Einige TB | Resynchronisierungszeit nach einem Fehler (Schritt 3): • 1-Gbit/s-Netzwerk ≈ 3 Stunden/TB • 10-Gbit/s-Netzwerk ≈ 1 Stunde/TB (abhängig von der Schreibgeschwindigkeit der Festplatte) | • Verwenden Sie externen gemeinsam genutzten Speicher (teurer, komplexer). |
| Anzahl der Dateien: < 1.000.000 Dateien | • Leistung der Resynchronisierungszeit nach einem Fehler (Schritt 3). • Zeit, die zum Vergleichen jeder Datei zwischen beiden Knoten benötigt wird. | • Legen Sie die vielen zu replizierenden Dateien auf eine virtuelle Festplatte/in eine virtuelle Maschine. • In diesem Fall werden nur die Dateien repliziert und erneut synchronisiert, die die virtuelle Festplatte/virtuelle Maschine darstellen. |
| Failover-Kapazität: ≤ 32 VMs | • Jede VM läuft in einem unabhängigen mirror-Modul. • Maximal 32 mirror-Module die auf demselben Cluster laufen. | • Verwenden Sie einen externen gemeinsam genutzten Speicher und eine andere VM-Clustering-Lösung (teurer, komplexer). |
| Netzwerkarchitektur: LAN/VLAN-Netzwerk zwischen entfernten Standorten | • Automatisches Failover der virtuellen IP-Adresse mit 2 Knoten im selben Subnetz. • Gute Bandbreite für die Resynchronisierung (Schritt 3). • Geringe Latenz für die synchrone Replikation: typischerweise < 5 ms RTT; höhere Werte sollten mit der Schreibgeschwindigkeit der Anwendung abgeglichen werden. | • Wenn sich die beiden Knoten in unterschiedlichen Subnetzen befinden (in der Cloud üblich), verwenden Sie andere Umleitungsoptionen: einen Load Balancer, Cloud-Provider-CLIs, BGP oder DNS-Umleitung. • Verwenden Sie Backup-Lösungen mit asynchroner Replikation für Netzwerke mit hoher Latenz. |
Vergleich: SafeKit vs. Standard-K3s-Stack (MetalLB & Longhorn)
Vergleich: SafeKit vs. Standard Open-Source (MetalLB + Longhorn)
| Fähigkeit | SafeKit (K3s.safe) | MetalLB + Longhorn (Standard-K8s) |
|---|---|---|
| Architektur | Alles in einem: Integrierte Netzwerk-, Replikations- und Failover-Funktionen in einem einzigen Paket. | DIY (Do It Yourself)-Stack: Mehrere unabhängige Pakete erforderlich (CNI, CSI, LoadBalancer). |
| Hardware-Effizienz | Reine 2-Knoten-HA: Volle Redundanz ohne einen 3. „Witness“- oder Arbiter-Knoten. | Mindestens 3 Knoten: Für das Etcd-Quorum und die Speichersicherheit sind in der Regel ungerade Zahlen erforderlich. |
| Networking (VIP) | Nativ: Virtuelle IP-Adresse, die auf Betriebssystemebene verwaltet wird; transparent für K3s. | Komplex: Erfordert die Installation von MetalLB mit L2- oder BGP-Konfiguration unter Verwendung dedizierter Speaker-Pods, die CPU/RAM auf jedem Knoten verbrauchen. |
| Speicheranforderungen | Byte-Level-Synchronisation: Echtzeit-Dateireplikation bestehender Verzeichnisse; funktioniert auf Standard-Systemlaufwerken; Byte-Level-Dateireplikation mit minimalem CPU-/Netzwerk-Overhead. | Blockebene: Verteilter Blockspeicher (Longhorn) mit dedizierten Speicher-Pods; höherer Ressourcenverbrauch. |
| Failover-Intelligenz | Unabhängige Stabilität: SafeKit arbeitet außerhalb der Container-Laufzeit. Es überwacht direkt das Betriebssystem und die Hardware und gewährleistet ein Failover, selbst wenn die Kubernetes-Steuerungsebene oder die Container-Engine ausfällt. | Zirkuläre Abhängigkeit: Die Failover-Logik wird in den Pods gehostet, die sie schützen soll. Wenn das Host-Betriebssystem oder die K3s-Engine hängt, frieren auch die Management-Pods (MetalLB/Longhorn) ein, was oft eine manuelle Fehlerbehebung erfordert, um die „Sperre“ aufzuheben |
| Verwaltung | Vereinfacht: Über eine einzige Webkonsole verwaltbar; kein Kubernetes Experte erforderlich. | Spezialisiert: Erfordert fundierte Kenntnisse von YAML, Helm und den internen Controllern von K8s. |
Zusammenfassend lässt sich sagen, dass ein Standard-DIY-Stack (MetalLB + Longhorn) zwar Modularität für Kubernetes Experten bietet, aber eine zirkuläre Abhängigkeit schafft, bei der die Speicher- und Netzwerktools anfällig für dieselben Knotenausfälle sind, die sie eigentlich verwalten sollen. SafeKit durchbricht diesen Kreislauf, indem es als unabhängige Infrastrukturschicht fungiert; es bietet eine robustere, hardwareunabhängige 2-Knoten-HA-Lösung, die auch dann betriebsbereit bleibt, wenn die Kubernetes-Engine oder das Host-Betriebssystem abstürzt. Dies gewährleistet eine automatisierte Wiederherstellung und Datenintegrität ohne den hohen Ressourcenaufwand, das zwingende Drei-Knoten-Quorum oder die Konfigurationskomplexität, die von traditionellen verteilten Blockspeichern und Netzwerk-Overlays gefordert werden.
Videoanleitung: Konfigurieren eines SafeKit HA-Mirror-Cluster
SafeKit Video: Clustering auf Anwendungsebene (8:47)
Dieses Video demonstriert die Hochverfügbarkeit von SafeKit für Microsoft SQL Server und bietet einen hervorragenden Überblick darüber, wie die Lösung K3s-Umgebungen sichert. SafeKit funktioniert identisch für jede andere Datenbank oder geschäftskritische Anwendung.
Video-Highlights
- 🎬 2 Knoten mit SQL Server (0:32)
- 🎬 Konfigurieren Sie den Cluster und das Modul mirror.safe (3:58)
- 🎬 SQL-Replikation, -Migration und Failover bei Absturz starten und testen (4:17)
&amp;amp;amp;amp;lt;br /&amp;amp;amp;amp;gt;
🔍 SafeKit entdecken
Finden Sie Informationen zu SafeKit-Funktionen, Architekturen, Videos, Dokumentation und der kostenlosen Testversion.
| Ressource | Beschreibung | Link |
|---|---|---|
| Wichtige Merkmale | Erfahren Sie, warum SafeKit eine einfache und kostengünstige Hochverfügbarkeitslösung ist. | Entdecken Sie die wichtigsten Funktionen |
| Anwendungsfälle | Erfahren Sie, wie SafeKit kritische Anwendungen und Infrastrukturen verfügbar hält. | Anwendungsfälle erkunden |
| Bereitstellungsmodell | SafeKit bietet Hochverfügbarkeit ohne SAN oder gemeinsam genutzten Speicher. | Das Bereitstellungsmodell erkunden |
| Hochverfügbarkeitsstrategien | Vergleichen Sie die Hochverfügbarkeit für virtuelle Maschinen mit der Hochverfügbarkeit für Anwendungen. | Vergleichen Sie die beiden Strategien |
| Technische Daten | Überprüfen Sie die technischen Anforderungen und Einschränkungen für SafeKit-Cluster. | Lesen Sie die technischen Daten |
| Videos | Sehen Sie sich Demonstrationen der SafeKit-Konfiguration und des automatischen Failovers an. | Sehen Sie sich die technischen Videos an |
| Architektur | Erfahren Sie, wie der SafeKit Mirror-Cluster Dateien in Echtzeit repliziert und Failover abwickelt. | Erkunden Sie die Mirror Architektur |
| Architektur | Erfahren Sie, wie der SafeKit Farm-Cluster den Netzwerkverkehr ausgleicht und Failover handhabt. | Entdecken Sie die Architektur Farm |
| Produktvergleich | Vergleichen Sie SafeKit mit herkömmlichen Hochverfügbarkeits-Clustern. | Vergleichen Sie die Lösungen |
| Technische Ressourcen | Finden Sie technische Dokumentation, laden Sie SafeKit herunter und greifen Sie auf die kostenlose Testversion zu. | Auf die Dokumentation und die kostenlose Testversion zugreifen |
| Anwendungsmodule | Nutzen Sie vorkonfigurierte SafeKit-Module, um die Hochverfügbarkeit Ihrer Anwendungen einzurichten. | Erkunden Sie die Anwendungsmodule |
