¿Qué son RPO y RTO? Definiciones, ejemplos y estrategias de HA
Resumen rápido: RPO frente a RTO
- RPO (objetivo de punto de recuperación): Mide la pérdida de datos. Define la antigüedad máxima de los archivos que deben recuperarse para que se reanuden las operaciones.
- RTO (objetivo de tiempo de recuperación): Mide el tiempo de inactividad. Es el período de tiempo dentro del cual se debe restaurar un proceso de negocio.
- La diferencia clave: RPO se trata de almacenamiento/copias de seguridad, mientras que RTO se trata de velocidad de recuperación/conmutación por error.
- Capacidad SafeKit: Ofrece 0 RPO (sin pérdida de datos) y bajo RTO (reinicio rápido) a través de replicación sincrónica y conmutación por error automática.
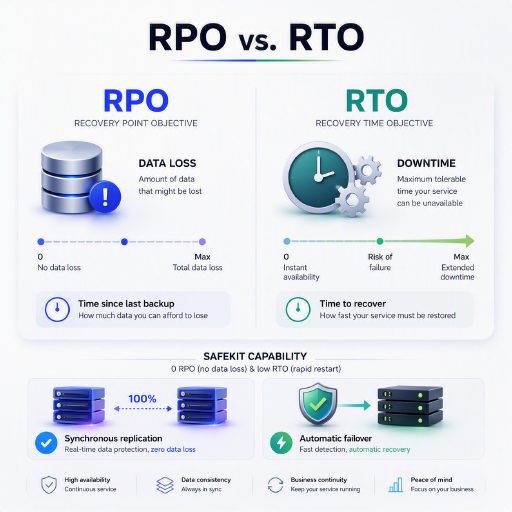
RPO frente a RTO: comparación del tiempo de recuperación y pérdida de datos en SafeKit
Tabla de contenidos
- ¿Cómo calculo el RPO y el RTO para una solución de alta disponibilidad y continuidad del negocio?
- ¿Cómo determino el RPO y el RTO para una solución de respaldo y recuperación ante desastres?
- ¿Cómo logra un clúster espejo SafeKit un RPO cero y un RTO bajo?
- ¿Cuáles son los puntos de referencia de RTO para un clúster de granja SafeKit con equilibrio de carga?
- Tablas comparativas: RTO vs RPO
- Alta disponibilidad en acción: demostraciones en tiempo real de RPO cero y RTO cercano a cero
- Preguntas frecuentes sobre RPO y RTO
- SafeKit Centro de navegación de alta disponibilidad
¿Cómo calculo el RPO y el RTO para una solución de alta disponibilidad y continuidad del negocio?
¿Qué es la alta disponibilidad?
Alta disponibilidad (HA) es una arquitectura técnica diseñada para garantizar que un sistema permanezca operativo y accesible durante un porcentaje específico de tiempo (por ejemplo, 99,99%).
Para lograr los objetivos de RPO y RTO definidos en un Plan de continuidad del negocio, la alta disponibilidad generalmente se implementa a través de dos arquitecturas principales:
- Sistema de disco compartido a través de SAN: Un clúster tradicional donde 2 nodos están conectados a una red de área de almacenamiento (SAN) central. Si un nodo falla, el otro asume el acceso a los datos compartidos.
- Replicación síncrona sin SAN: Una arquitectura moderna de “nada compartido”, implementada por el software SafeKit, donde los datos se replican en tiempo real entre discos locales de 2 nodos independientes, eliminando la necesidad de una SAN.
¿Cuál es el RPO de una solución de alta disponibilidad?
RPO (Objetivo de punto de recuperación) define el volumen máximo tolerable de pérdida de datos medido en el tiempo. Para una verdadera solución de alta disponibilidad, el RPO objetivo es cero.
Al implementar un clúster de alta disponibilidad con conmutación por error automática, un RPO cero garantiza que la aplicación se reinicie sin pérdida de datos.
- Sistema de disco compartido a través de SAN: Debido a que ambos nodos acceden a exactamente los mismos bloques físicos de datos, no hay “delta” ni retraso entre los nodos, lo que garantiza una coherencia total de los datos durante una conmutación por error.
- Replicación síncrona basada en software: Un enfoque sin SAN donde cada operación de “escritura” se refleja en tiempo real en toda la red. La aplicación solo recibe un confirmación de escritura una vez que los datos se almacenan de forma segura en ambos nodos. Este proceso sincrónico de “doble escritura” garantiza cero pérdida de datos incluso si falla el servidor principal.
¿Cuál es el RTO de una solución de alta disponibilidad?
RTO (objetivo de tiempo de recuperación) representa la duración máxima tolerable del tiempo de inactividad después de una interrupción del servicio. En el contexto de alta disponibilidad, el RTO debe ser mínimo para garantizar el acceso continuo a las aplicaciones críticas.
Para lograr un RTO bajo, una solución de alta disponibilidad utiliza conmutación por error automática para detectar fallas de hardware o software y reiniciar la aplicación inmediatamente. En un clúster típico de alta disponibilidad, el RTO es de aproximadamente un minuto y se calcula como:
- Tiempo de detección de fallas: El intervalo requerido para que el sistema identifique una pérdida de latidos del nodo o de la aplicación.
- Tiempo de reinicio automático: El tiempo necesario para que los servicios de la aplicación se inicialicen en el nodo superviviente.
¿Cómo determino el RPO y el RTO para una solución de respaldo y recuperación ante desastres?
¿Qué es una solución de respaldo?
Una Solución de respaldo es una estrategia de protección de datos diseñada para crear copias periódicas de datos en un dispositivo de almacenamiento secundario o en la nube. A diferencia de la alta disponibilidad, el respaldo se centra en la retención de datos a largo plazo y la recuperación de datos dañados o desastres en todo el sitio.
Para cumplir con los objetivos de RPO y RTO definidos en un Plan de recuperación ante desastres, la copia de seguridad generalmente se implementa mediante dos métodos principales:
- Instantáneas programadas: Un proceso en el que se toman copias de datos en un momento dado a intervalos fijos (por ejemplo, diariamente). Esto define el RPO, ya que cualquier dato modificado entre la última instantánea y la falla se pierde.
- Recuperación fuera del sitio o en la nube: Una arquitectura donde los datos se almacenan en una ubicación física separada. Si bien esto garantiza la supervivencia de los datos, da como resultado un RTO más alto porque los datos deben transferirse y restaurarse antes de que la aplicación pueda reiniciarse.
¿Cuál es el RPO de una solución de respaldo?
RPO (objetivo de punto de recuperación) en un contexto de copia de seguridad define la antigüedad de los archivos que se deben recuperar del almacenamiento para que se reanuden las operaciones normales. A diferencia de la alta disponibilidad, una solución de respaldo generalmente implica un RPO distinto de cero, que representa el tiempo transcurrido desde que se completó exitosamente el último respaldo.
La cantidad de pérdida de datos en una estrategia de copia de seguridad está determinada por la frecuencia de la copia de seguridad. Dependiendo de la arquitectura, este RPO puede variar desde minutos hasta 24 horas:
- Instantáneas incrementales: Un método en el que solo se guardan los bloques de datos modificados en intervalos establecidos. Si se realiza una copia de seguridad cada 4 horas, el RPO máximo es de 4 horas, lo que significa que cualquier dato creado entre la última instantánea y la falla del sistema se perderá permanentemente.
- Copias de seguridad completas diarias: Un enfoque tradicional en el que se realiza una copia completa de los datos una vez al día (normalmente durante la noche). Esto da como resultado un RPO de 24 horas, que puede ser aceptable para datos no críticos, pero a menudo es insuficiente para bases de datos transaccionales.
¿Cuál es el RTO de una solución de respaldo?
RTO (objetivo de tiempo de recuperación) en una estrategia de copia de seguridad es el tiempo que lleva restaurar los datos desde un medio de copia de seguridad y devolver la aplicación a un estado operativo. A diferencia de la alta disponibilidad, el RTO para respaldo es significativamente más largo porque implica procesos de restauración manuales o programados.
Para una solución de respaldo, el RTO puede variar desde varias horas hasta días, según el volumen de datos y la arquitectura de recuperación. El tiempo de inactividad total se calcula como:
- Tiempo de transferencia de datos: El tiempo necesario para mover datos desde el almacenamiento de respaldo (discos locales, cintas o nube) al servidor de producción.
- Tiempo de reconfiguración del sistema: El intervalo necesario para introducir los datos en la aplicación, reconstruir índices y verificar la integridad de los datos antes de que los usuarios puedan volver a iniciar sesión.
¿Cómo logra un clúster espejo SafeKit lograr un RPO cero y un RTO bajo?
¿Qué es el grupo de espejos SafeKit?
SafeKit Mirror Cluster es una solución de alta disponibilidad basada en software que implementa una arquitectura de “nada compartido”. A diferencia de los clústeres tradicionales que requieren una costosa SAN, SafeKit utiliza los recursos locales de dos servidores estándar para crear un entorno altamente resistente.
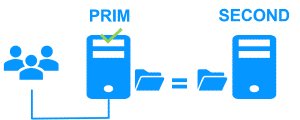
Para garantizar el máximo tiempo de actividad y protección de datos dentro de su Plan de continuidad del negocio, el clúster espejo SafeKit opera a través de dos mecanismos integrados:
- Replicación síncrona en tiempo real: SafeKit refleja los datos en la red entre los discos locales de los nodos primario y secundario. Esto garantiza que el RPO sea cero, ya que cada byte de datos está protegido en ambos servidores antes de finalizar una transacción.
- Conmutación por error automática de IP y aplicaciones: Si el nodo principal falla, SafeKit detecta automáticamente la pérdida de latidos y restablece la aplicación y su dirección IP virtual en el nodo secundario. Esto da como resultado un RTO de aproximadamente un minuto, lo que proporciona una continuidad del servicio perfecta.
¿Cuál es el RPO de un grupo espejo SafeKit?
El RPO de un clúster espejo SafeKit es cero porque la replicación de datos entre nodos es sincrónica y en tiempo real.
Esta garantía de cero pérdida de datos se logra mediante un proceso de reconocimiento de escritura: una escritura en disco solo se confirma en la aplicación una vez que se ha escrito correctamente en los discos locales de los nodos primario y secundario.
Por el contrario, con la replicación asincrónica, el RPO es mayor que cero. Debido a que hay un retraso entre la escritura principal y la actualización secundaria, una falla resultará en la pérdida de datos durante la conmutación por error al servidor secundario. Para la Continuidad del Negocio de misión crítica, la replicación sincrónica es la única forma de garantizar que la aplicación se reinicie con una integridad de datos del 100 %.
¿Cuál es el RTO de un grupo de espejos SafeKit?
En una configuración estándar, el RTO de un clúster reflejado SafeKit es de aproximadamente un minuto. SafeKit ofrece la flexibilidad de implementar alta disponibilidad en el nivel de aplicación o en el nivel de VM, cada uno de los cuales impacta el tiempo de recuperación de manera diferente:
- HA a nivel de aplicación: Este es el enfoque optimizado SafeKit donde el software monitorea servicios de aplicaciones específicas.
- Error de hardware: RTO = tiempo de espera de latido (predeterminado 30 segundos) + tiempo de reinicio de la aplicación.
- Error de software: RTO = hora de parada de la aplicación + hora de reinicio de la aplicación.
- Beneficio clave: Dado que el sistema operativo ya se está ejecutando en el nodo secundario, no hay demora en el inicio del sistema operativo, lo que resulta en la recuperación más rápida posible para la continuidad del negocio.
- HA a nivel de VM: En este escenario, SafeKit protege todo el entorno de la máquina virtual.
- Recuperación de fallos: RTO = detección de fallos + Tiempo de reinicio del sistema operativo + tiempo de reinicio de la aplicación.
- Compensación técnica: El RTO es naturalmente más largo (varios minutos) porque el nodo secundario debe realizar un arranque en frío completo del sistema operativo antes de que la aplicación pueda siquiera comenzar a inicializarse.
Al utilizar alta disponibilidad a nivel de aplicación, SafeKit elimina la “penalización de reinicio” inherente a la virtualización estándar, lo que garantiza que su Plan de continuidad del negocio logre el menor tiempo de inactividad posible.
¿Cuáles son los puntos de referencia de RTO para un clúster agrícola SafeKit con equilibrio de carga?
¿Qué es el Clúster Agrícola SafeKit?
SafeKit Farm Cluster es una solución de alta disponibilidad basada en software diseñada para aplicaciones sin estado (como servidores web) que requieren escalabilidad y redundancia. A diferencia de un clúster espejo que se centra en la replicación de datos, un clúster de granja distribuye el tráfico entrante entre varios nodos activos.
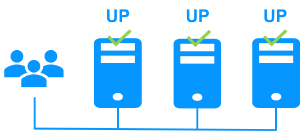
Para mantener la Continuidad del negocio en entornos de alto tráfico, el clúster de granja SafeKit opera a través de dos mecanismos principales:
- Equilibrio de carga de red: SafeKit utiliza una dirección IP virtual para distribuir el tráfico de red entrante en una “granja” de múltiples servidores activos. Esto garantiza que ningún servidor se vea abrumado y maximiza el rendimiento de la aplicación.
- Detección y reconfiguración automática de fallas: Si un nodo de la granja falla, SafeKit detecta la falla mediante latidos e inmediatamente redistribuye su tráfico entre los nodos restantes en buen estado. Esto proporciona un RTO cercano a cero para el servicio general, ya que otros nodos ya están activos y listos para absorber la carga.
¿Cuál es el RPO de un clúster agrícola SafeKit?
El RPO (objetivo de punto de recuperación) para un clúster de granja SafeKit generalmente se considera No aplicable (N/A). Esto se debe a que un clúster de granja está diseñado específicamente para aplicaciones sin estado donde los datos no se almacenan localmente en los nodos.
Dado que un clúster de granja se centra en el equilibrio de carga de la red en lugar de la sincronización de datos, no hay replicación de datos entre los nodos dentro del propio clúster. En un típico Plan de Continuidad de Negocio que involucra una arquitectura de granja:
- Operaciones sin estado: Todos los nodos de la granja son idénticos y no contienen datos persistentes; por lo tanto, no hay “pérdida de datos” que medir durante una falla de nodo.
- Almacenamiento de datos externo: Si la aplicación requiere persistencia de datos, generalmente la maneja un backend independiente SafeKit Mirror Cluster donde el RPO sería cero.
¿Cuál es el RTO de un grupo agrícola SafeKit?
En una arquitectura de granja, el RTO se reduce a solo unos segundos porque todos los nodos suelen estar activos simultáneamente. El tiempo de recuperación está determinado por la velocidad a la que el clúster reconfigura su distribución de tráfico:
- Falla de hardware: El RTO es igual al tiempo de espera de detección de fallas en todos los canales de monitoreo (el valor predeterminado es unos segundos). Una vez que se detecta la pérdida de latidos, los filtros de equilibrio de carga de IP virtuales se reconfiguran automáticamente para redirigir el tráfico a los nodos restantes en buen estado.
- Error de software o reinicio planificado: El RTO se calcula como el tiempo de detención de la aplicación más el tiempo de reinicio de la aplicación en ese nodo específico, durante el cual los otros nodos de la granja continúan manejando todo el tráfico entrante.
Este mecanismo “Activo-Activo” garantiza que, para los servicios sin estado, el impacto de la Continuidad del Negocio sea casi imperceptible para el usuario final, ya que no es necesario inicializar el servicio en un nuevo nodo en espera.
Tablas comparativas: RTO vs RPO
Definición semántica: RTO frente a RPO
| Métrica | Acrónimo | Definición | Área de enfoque |
|---|---|---|---|
| Objetivo de tiempo de recuperación | RTO | La duración de tiempo objetivo para restaurar un proceso de negocio después de un error. | Disponibilidad/tiempo de inactividad |
| Objetivo del punto de recuperación | RPO | La antigüedad máxima de los archivos que se deben recuperar de la copia de seguridad para que se reanuden las operaciones. | Pérdida de datos/integridad |
Alta disponibilidad (HA) frente a copia de seguridad estándar
| Característica | Soluciones de respaldo | Alta disponibilidad (SafeKit) |
|---|---|---|
| Automatización de recuperación | Intervención Manual | Conmutación por error automática |
| RTO objetivo | Horas a Días | Segundos a ~1 minuto |
| RPO objetivo | > 0 (Último punto de respaldo) | 0 (replicación sincrónica) |
Parámetros de referencia de RTO y RPO para clústeres SafeKit
| Arquitectura | Caso de uso | RTO (disponibilidad) | RPO (pérdida de datos) |
|---|---|---|---|
| Grupo de espejos | Replicación en tiempo real | ~1 min (latido + reinicio) | 0 (sin pérdida de datos) |
| Clúster agrícola | Equilibrio de carga de red | unos segundos | N/A (Apátrida) |
Alta disponibilidad en acción: demostraciones en tiempo real de RPO cero y RTO casi nulo
Vídeo: Cómo lograr un RPO cero y un RTO bajo en un grupo de espejos SafeKit (8:47)
Vea cómo SafeKit maneja una falla crítica. Este video muestra la replicación sincrónica que garantiza que no se pierdan datos (RPO 0) en una base de datos SQL y el reinicio automático de los servicios en el nodo secundario (RTO bajo).
Capítulos
- 🎬 Nodos 2 con SQL Server (0:32)
- 🎬 Configurar el clúster y el módulo mirror.safe (3:58)
- 🎬 Inicie y pruebe la replicación, migración y conmutación por error de SQL en caso de fallo (4:17)
Vídeo: Lograr un RTO casi nulo en un grupo agrícola SafeKit (5:03)
Vea cómo SafeKit administra una granja web Apache para proporcionar escalamiento del rendimiento y conmutación por error instantánea.
Capítulos
- 🎬 Nodos 2 con Apache (0:13)
- 🎬 Configurar el clúster y el módulo farm.safe (2:20)
- 🎬 Inicie y pruebe el equilibrio de carga de la red, conmutación por error en caso de fallo (2:30)
Preguntas frecuentes: optimización de RPO y RTO para la continuidad del negocio
¿Pueden RPO y RTO ser cero?
Sí. Lograr un RPO cero significa que no se perderán datos, lo cual es posible mediante la duplicación de datos sincrónica. Se logra un RTO cercano a cero mediante un software de conmutación por error automatizado como SafeKit, que detecta fallas y reinicia aplicaciones en un nodo secundario en segundos o minutos.
¿Qué es más importante: RPO o RTO?
Ninguno de los dos es intrínsecamente más importante; cumplen diferentes roles. RPO (objetivo de punto de recuperación) se centra en la pérdida de datos: cuántos datos puede permitirse perder. RTO (objetivo de tiempo de recuperación) se centra en el tiempo de inactividad: la rapidez con la que debe volver a estar en línea. Para aplicaciones de misión crítica, ambos deben minimizarse.
¿Cuál es la diferencia en RPO y RTO entre SafeKit a nivel de aplicación y a nivel de VM?
Si bien ambos garantizan un RPO de 0 mediante replicación sincrónica, difieren en el tiempo de recuperación:
- Nivel de aplicación: RTO más rápido (aproximadamente 1 min) porque solo los servicios de aplicaciones se reinician en un sistema operativo que ya se está ejecutando. También detecta fallas específicas de software/proceso.
- Nivel de VM: RTO más alto porque toda la máquina virtual debe reiniciarse en el host secundario. Si bien es independiente de la aplicación, carece de monitoreo granular de los propios procesos de la aplicación.
¿Cuál es la diferencia entre HA y las soluciones de respaldo en términos de RTO?
La alta disponibilidad (HA) normalmente ofrece un RTO (de segundos a minutos) mucho más bajo porque maneja las fallas locales automáticamente. La recuperación ante desastres con soluciones de respaldo (DR) generalmente tiene un RTO más alto (de horas a días) porque implica recuperar datos y servicios en un sitio geográficamente distante después de una catástrofe importante.
¿Cómo logro el mejor RPO y RTO entre sitios remotos?
Lograr un RPO cero y un RTO casi nulo en sitios remotos requiere una combinación de replicación síncrona y una LAN extendida (VLAN extendida):
- LAN extendida/VLAN extendida: Al extender la misma subred (Capa 2) a través de dos centros de datos, puede mover una aplicación del Sitio A al Sitio B sin cambiar su dirección IP, evitando actualizaciones complejas de DNS.
- La solución SafeKit: SafeKit aprovecha esto al proporcionar una IP virtual (VIP) definida por software que flota entre sitios. Redirige instantáneamente el tráfico al sitio secundario mediante ARP gratuito (GARP).
Esto ofrece un RPO = 0 (duplicación en tiempo real) y un RTO mínimo (conmutación por error en aproximadamente 1 minuto) sin intervención humana.
¿Por qué es esencial combinar alta disponibilidad y respaldo para optimizar RPO y RTO?
Combinar alta disponibilidad (HA) con una solución de respaldo es la única manera de lograr una estrategia de recuperación que ofrezca lo mejor de ambos mundos. Si bien a menudo se analizan juntos, resuelven diferentes partes de la ecuación RPO/RTO:
- Alta disponibilidad (a través de SafeKit): Optimiza para lograr un RTO cercano a cero y un RPO cero durante fallas de hardware o software. Al utilizar la replicación síncrona en tiempo real, el servidor secundario siempre está actualizado. Si el principal falla, el servicio se reinicia en el secundario inmediatamente sin pérdida de datos.
- Soluciones de respaldo: Proteja contra problemas de integridad de datos (como ransomware o eliminación accidental). Debido a que HA replica los cambios instantáneamente, replicará “fielmente” un virus o un registro de base de datos eliminado en el servidor en espera. Una copia de seguridad le permite “regresar en el tiempo” a un punto anterior a que ocurriera la corrupción.
- El enfoque híbrido: Para lograr la máxima resiliencia, las organizaciones utilizan una arquitectura híbrida de 3 nodos. Esto incluye un clúster local de 2 nodos con replicación sincrónica para HA inmediata y una tercera copia remota (asincrónica) para recuperación ante desastres. Esta defensa en capas garantiza que usted tenga una copia “viva” para una recuperación instantánea y una copia “histórica” para la seguridad de los datos.
🔍 Centro de Navegación de Alta Disponibilidad SafeKit
Explore SafeKit: Funciones, vídeos técnicos, documentación y prueba gratuita
| Tipo de Recurso | Descripción | Enlace Directo |
|---|---|---|
| Funciones Clave | ¿Por qué elegir SafeKit para una alta disponibilidad sencilla y rentable? | Vea por qué elegir SafeKit para alta disponibilidad |
| Casos de uso | Descubra cómo SafeKit garantiza la alta disponibilidad de infraestructuras críticas | Ver todos los casos de uso (Software OEM, Servidores Edge, SCADA y más) |
| Modelo de Despliegue | Alta Disponibilidad SANless Todo-en-Uno: Clustering de software Shared-Nothing | Vea SafeKit HA SANless Todo-en-Uno |
| Estrategias de HA | SafeKit: Alta disponibilidad a nivel de infraestructura (VM) vs. nivel de aplicación | Vea SafeKit HA y Redundancia: VM vs. Nivel de Aplicación |
| Especificaciones Técnicas | Limitaciones técnicas para el clustering con SafeKit | Vea las limitaciones de alta disponibilidad de SafeKit |
| Vídeos | SafeKit: Demos de configuración y failover de alta disponibilidad | Vea los tutoriales de failover de SafeKit |
| Arquitectura | Cómo funciona el Mirror Cluster de SafeKit (Replicación en tiempo real y failover) | Vea SafeKit Mirror Cluster: Replicación en tiempo real y failover |
| Arquitectura | Cómo funciona el Farm Cluster de SafeKit (Equilibrio de carga de red y failover) | Vea SafeKit Farm Cluster: Equilibrio de carga de red y failover |
| Ventajas Competitivas | Comparativa: SafeKit frente a los clusters de alta disponibilidad (HA) tradicionales | Vea la comparativa entre SafeKit y los clusters de HA tradicionales |
| Recursos Técnicos | Alta Disponibilidad SafeKit: Documentación, descargas y prueba | Vea la prueba gratuita y documentación técnica de SafeKit HA |
| Soluciones Preconfiguradas | Librería de módulos de aplicación SafeKit: Soluciones de HA listas para usar | Vea los módulos de aplicación de alta disponibilidad de SafeKit |
