Alta disponibilidad Kubernetes K3s: replicación síncrona y conmutación por error de 2 nodos
Simplificando la alta disponibilidad de K3s: ¿Por qué elegir SafeKit en lugar de MetalLB y Longhorn?
Si bien el stack estándar de código abierto (MetalLB + Longhorn) para K3s es potente para grandes centros de datos, introduce una complejidad excesiva para sitios locales de 2 nodos. SafeKit simplifica el entorno K3s al reemplazar las herramientas de red y almacenamiento independientes con un único motor de alta disponibilidad consolidado.
¿Por qué usar SafeKit para la alta disponibilidad (HA) de K3s de 2 nodos?
- Alta disponibilidad real de 2 nodos: SafeKit proporciona redundancia total con solo 2 nodos, lo que elimina el requisito de 3 nodos para el quórum de etcd.
- Pérdida de datos cero (RPO = 0): reemplaza el almacenamiento en bloque de alta sobrecarga con replicación sincrónica a nivel de byte para un rendimiento SSD local.
- Protección flexible a nivel de archivo: SafeKit realiza la replicación basada en host a nivel de archivo, lo que es completamente transparente para la aplicación. Protege no solo las bases de datos, sino también todas las carpetas y datos asociados. Puede replicar las carpetas existentes exactamente donde están instaladas, incluso en el disco del sistema.
- IP virtual integrada (VIP): gestiona de forma nativa la IP del clúster a nivel del kernel, lo que elimina la necesidad de configuraciones separadas de MetalLB.
- Conmutación por error y recuperación automáticas: activa una transición inmediata al nodo secundario en caso de error; una vez que el nodo primario está en buen estado, SafeKit ejecuta la resincronización automática de datos sin intervención manual.
- Consumo de recursos ultrabajo: SafeKit funciona sin la gran sobrecarga de gestión de los pods de almacenamiento (CSI/Longhorn) y los pods de red (CNI/MetalLB) que requieren las pilas estándar, lo que libera RAM y CPU críticas para sus aplicaciones.
- Amigable para el generalista de TI: Reemplaza la compleja infraestructura YAML para redes y almacenamiento con una sencilla interfaz gráfica de usuario web y scripts de implementación automatizados, lo que le permite centrarse únicamente en sus aplicaciones.
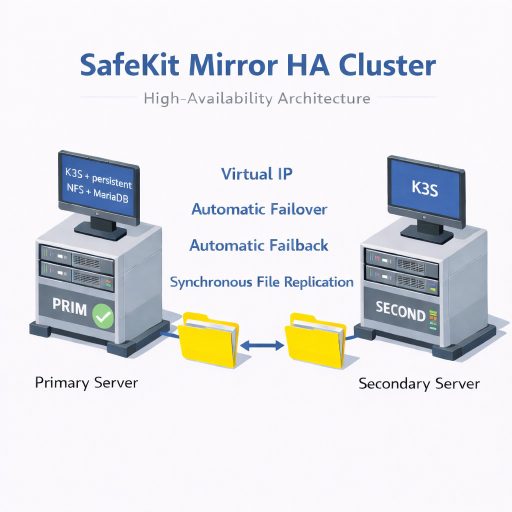
Alta disponibilidad (HA) sin recursos compartidos para clústeres K3s de 2 nodos
⚡ Guía rápida de instalación de un clúster HA Kubernetes >
Índice
- ¿Cómo implementa el software SafeKit un clúster de alta disponibilidad Kubernetes K3s?
- ¿Cómo funciona el clúster mirror SafeKit con Kubernetes K3S?
- Limitaciones de alta disponibilidad SafeKit
- Comparación: SafeKit vs. pila K3s estándar (MetalLB y Longhorn)
- Guía en vídeo: Configuración de un clúster HA mirror SafeKit Mirror
- 🔍 Explora SafeKit
¿Cómo implementa el software SafeKit un clúster de alta disponibilidad Kubernetes K3s?
¿Cómo implemento la alta disponibilidad para un clúster K3s Kubernetes de 2 nodos?
Puede implementar alta disponibilidad (HA) para un clúster Kubernetes K3s de 2 nodos utilizando el módulo mirror SafeKit k3s.safe. Esta solución le permite implementar un entorno redundante sin necesidad de almacenamiento NFS externo, una base de datos de configuración externa dedicada o experiencia especializada Kubernetes.
¿Por qué usar K3s para la computación perimetral y de IoT?
K3s es el motor Kubernetes preferido para IoT y computación perimetral porque es una distribución ligera y certificada diseñada para entornos con recursos limitados. Simplifica la sobrecarga operativa de Kubernetes estándar manteniendo una compatibilidad total.
¿Cuáles son las características principales del módulo mirror k3s.safe?
El módulo k3s.safe proporciona una pila HA completa para K3s mediante la implementación de:
- Nodos activos duales: ejecuta 2 maestros/agentes K3s activos simultáneamente para alojar pods.
- Replicación de bases de datos: replicación en tiempo real de la base de datos de configuración de MariaDB entre nodos.
- Almacenamiento persistente: replicación de volúmenes persistentes a través de un aprovisionador dinámico de cliente NFS integrado (nfs-client).
- Continuidad de la red: incluye una dirección IP virtual para un acceso ininterrumpido del cliente.
- Recuperación automatizada: compatibilidad total con la conmutación por error y la recuperación automática.
Además de K3s, ¿qué aplicaciones y entornos puede proteger SafeKit?
SafeKit es una solución versátil de alta disponibilidad para Windows y Linux que va mucho más allá clúster mirror K3s. Permite la replicación síncrona en tiempo real y la conmutación por error automática para una amplia gama de cargas de trabajo críticas, que incluyen:
- Entornos virtuales y físicos: máquinas virtuales Hyper-V o KVM completas.
- Orquestación de contenedores: entornos Docker y Podman.
- Datos y servicios: directorios de archivos individuales, servicios y diversas bases de datos.
- Infraestructura en la nube: alta disponibilidad para aplicaciones en la nube.
SafeKit también proporciona a clústeres farm un equilibrio de carga de red y una conmutación por error nativos para aplicaciones sin estado, como los servidores web.
💡 Explora la lista completa de soluciones de alta disponibilidad compatibles aquí.
¿Cómo consigue SafeKit la alta disponibilidad de K3s?
Arquitectura y lógica de redundancia para un clúster K3s de 2 nodos con SafeKit
| Clúster K3s de 2 nodos | SafeKit PRIM (nodo principal) | SafeKit SECOND (nodo secundario) |
|---|---|---|
| Ejecución de la carga de trabajo | Los servicios maestros y de agente de K3s están activos, gestionando la orquestación del clúster y ejecutando pods. | Los servicios del maestro y del agente de K3s permanecen activos, proporcionando procesamiento paralelo y alta disponibilidad. |
| Almacenamiento NFS y PV | • IP virtual y puerto NFS del host • Gestiona los recursos compartidos NFS exportados activos • Almacena volúmenes persistentes (PV) de K3s | Réplica síncrona: SafeKit replica todos los volúmenes persistentes en tiempo real para garantizar la pérdida cero de datos. |
| Base de datos de configuración | • Aloja la IP virtual y el puerto MariaDB • Gestiona la base de datos de configuración activa de K3s | Replicación de bases de datos: la base de datos MariaDB se replica de forma síncrona, lo que preserva el estado del clúster para la conmutación por error. |
Mecanismo de conmutación por error automática: en caso de fallo del nodo principal, SafeKit migra automáticamente las IP virtuales y los servicios de almacenamiento al nodo secundario, lo que garantiza un servicio ininterrumpido para el clúster K3s.
¿Cómo funciona el clúster mirror SafeKit con Kubernetes K3S?
Paso 1: Replicación de archivos a nivel de byte en un clúster mirror
Esta etapa ilustra la arquitectura de alta disponibilidad entre el servidor 1 (PRIM) y el servidor 2 (SECOND). Ambos servidores ejecutan los componentes maestros y de agente de K3s como se define en la tabla de arquitectura.
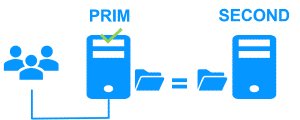
Actualmente, la IP virtual (VIP), el almacenamiento persistente NFS y MariaDB están activos solo en el servidor 1 (PRIM). Los componentes maestros de K3s en ambos nodos se sincronizan entre sí accediendo al estado del clúster a través de la IP virtual y el puerto MariaDB. SafeKit implementa la replicación síncrona de MariaDB y de los archivos NFS persistentes, lo que garantiza la pérdida cero de datos (RPO = 0) en caso de fallo.
Los maestros de K3s distribuyen la carga de trabajo entre ambos nodos (o más) comunicándose directamente con los agentes de K3s. Los clientes externos se conectan al
dirección IP virtual del clúster en el nodo PRIM. Mediante los mecanismos estándar Kubernetes, el maestro de K3s retransmite el tráfico a los pods distribuidos por los nodos. Del mismo modo, los pods acceden a sus volúmenes persistentes (PV) en el servidor PRIM a través de la IP virtual y el puerto NFS.
Paso 2: Conmutación por error automática y continuidad del servicio
Cuando el servidor 1 (PRIM) falla, el servidor 2 (SECOND) asume automáticamente las operaciones del clúster para garantizar la continuidad.
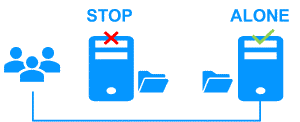
SafeKit detecta el fallo y migra inmediatamente la dirección IP virtual del clúster al Servidor 2. A continuación, promueve los servicios locales MariaDB y NFS a un estado activo. Debido a la replicación síncrona realizada en el Paso 1, todas las bases de datos MariaDB y los archivos de volumen persistente (PV) de NFS ya están actualizados en el Servidor 2, lo que garantiza la pérdida cero de datos.
Con el estado del clúster conservado, el maestro de K3s en el servidor 2 continúa la ejecución. Detecta la pérdida del agente del servidor 1 y reprograma automáticamente los pods afectados en los agentes de K3s activos restantes. El tiempo total de conmutación por error (RTO) es la suma del intervalo de detección de fallos (por defecto: 30 segundos) y el tiempo necesario para que los componentes de K3s se inicialicen en el nodo secundario.
Mientras el servidor 1 está desconectado, los servicios MariaDB y NFS continúan ejecutándose en el servidor 2, escribiendo los cambios solo localmente.
Paso 3: Conmutación por error y reintegración automática
La recuperación de fallos se produce cuando el servidor 1 se reinicia después de que se haya resuelto el problema inicial. SafeKit resincroniza automáticamente los archivos MariaDB y NFS, actualizando solo los datos modificados en el servidor 2 durante el tiempo de inactividad. Este proceso de reintegración no es disruptivo; los componentes maestros y agentes de K3s continúan ejecutándose en el servidor 2 sin interrupción.
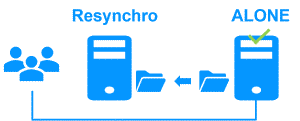
SafeKit optimiza el tiempo de recuperación en función de cómo se detuvo el servidor:
- Apagado limpio: Si SafeKit se detuvo intencionalmente en el Servidor 1, solo las zonas específicas modificadas dentro de los archivos se resincronizan utilizando mapas de bits de seguimiento de modificaciones. Esto garantiza una reintegración ultrarrápida.
- Fallo del sistema (por ejemplo, fallo de alimentación): Si el Servidor 1 sufrió un apagado incorrecto, los mapas de bits de modificación se omiten por seguridad. SafeKit en su lugar, resincroniza todos los archivos con una marca de tiempo de modificación más reciente que el último punto de sincronización establecido, lo que garantiza la integridad total de los datos.
Paso 4: Restaurar la alta disponibilidad y la distribución de la carga
Tras la reintegración, el clúster vuelve al modo mirror completo, reflejando el estado descrito en el paso 1. El sistema está una vez más en un estado de alta disponibilidad: los servicios MariaDB y NFS permanecen activos en el servidor 2, mientras que SafeKit realiza la replicación en tiempo real de todas las actualizaciones de archivos al servidor 1.
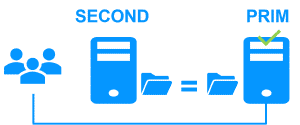
El maestro de K3s y el agente de K3s se reinician automáticamente en el servidor 1. El planificador Kubernetes ahora reconoce el servidor 1 como un nodo saludable y puede comenzar a reprogramar los pods para distribuir la carga de trabajo entre ambos servidores.
Si el administrador prefiere que los servicios MariaDB y NFS se ejecuten en el Servidor 1 (restaurando el rol PRIM original), se puede activar un cambio manualmente a través de la consola web en un momento conveniente o automatizado a través de la configuración.
¿Cómo configurar un clúster mirror SafeKit?
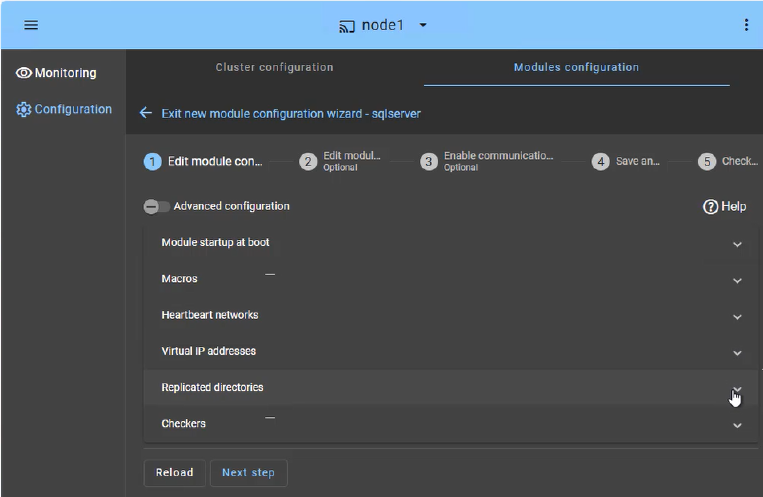
La consola web SafeKit proporciona una interfaz intuitiva para organizar la alta disponibilidad de sus aplicaciones críticas. En solo unos pasos, puede configurar un clúster mirror SafeKit para garantizar la continuidad del negocio:
- Conmutación por error de la aplicación (pestaña Macros): defina los servicios de aplicación específicos que se reiniciarán automáticamente en caso de error.
- Red(es) de latido: ruta(s) de comunicación dedicada(s) utilizada(s) por los nodos del clúster para supervisar continuamente el estado y la disponibilidad de los demás y sincronizar las decisiones de conmutación por error.
- Gestión de IP virtual: configure la IP virtual (VIP) para la reconexión transparente del cliente después de una conmutación por error.
- Replicación en tiempo real: Seleccione los directorios críticos para la replicación síncrona a nivel de byte basada en el host.
- Checkers: supervise el estado de la aplicación y active la recuperación automática si se detecta un error en un proceso.
El clúster SafeKit incluye un verificador de división de clúster dedicado para resolver problemas de aislamiento de red sin necesidad de una tercera máquina testigo o una red de latidos adicional. Obtenga más información sobre los latidos, la conmutación por error y el quórum en un clúster.
¿Cómo supervisar un clúster mirror SafeKit?

La consola de administración SafeKit ofrece una vista unificada de su infraestructura de alta disponibilidad. Permite a los administradores supervisar el estado operativo del clúster y realizar un seguimiento de la sincronización de datos en tiempo real.
Para un clúster mirror de 2 nodos, la consola muestra claramente las funciones de cada servidor:
- PRIM (primario): el nodo activo que ejecuta actualmente la aplicación y gestiona la IP virtual. Realiza escrituras en el almacenamiento local y replicación en tiempo real al nodo secundario.
- SECOND (Secundario): El nodo en espera recibe actualizaciones síncronas a nivel de byte. Está listo para asumir el control al instante si el primario falla.
- Estado ALONE: le avisa visualmente cuando el clúster se está ejecutando en un solo nodo (por ejemplo, durante el mantenimiento o después de una falla), lo que indica que la redundancia se pierde temporalmente.
- Progreso de la resincronización: cuando un nodo fallido se recupera, su estado se vuelve naranja durante la reintegración de datos en segundo plano, lo que garantiza que no haya tiempo de inactividad durante la fase de “regreso a la normalidad”.
Más allá de los simples iconos de estado, la interfaz proporciona una orquestación de conmutación por error con un solo clic, lo que le permite reasignar manualmente el rol principal para el mantenimiento planificado, al tiempo que garantiza la disponibilidad continua para la actividad del usuario.
Limitaciones de alta disponibilidad SafeKit
| Límite / Requisito | Motivo e impacto | Alternativa recomendada |
|---|---|---|
| Tamaño de la replicación: unos pocos TB | Tiempo de resincronización tras un fallo (paso 3): • Red de 1 Gb/s ≈ 3 horas/TB • Red de 10 Gb/s ≈ 1 hora/TB (dependiendo del rendimiento de escritura del disco) | • Utilizar almacenamiento compartido externo (más caro, más complejo). |
| Número de archivos: < 1 000 000 | • Rendimiento del tiempo de resincronización después de una falla (paso 3). • Tiempo necesario para comparar cada archivo entre ambos nodos. | • Coloque los numerosos archivos que se van a replicar en un disco duro virtual o en una máquina virtual. • En este caso, solo se replicarán y resincronizarán los archivos que representan el disco duro virtual o la máquina virtual. |
| Capacidad de conmutación por error: ≤ 32 máquinas virtuales | • Cada máquina virtual se ejecuta en un módulo mirror independiente. • Máximo de 32 módulos mirror que se ejecutan en el mismo clúster. | • Utilizar un almacenamiento compartido externo y otra solución de clúster de máquinas virtuales (más cara y más compleja). |
| Arquitectura de red: red LAN/VLAN entre sitios remotos | • Conmutación por error automática de la dirección IP virtual con 2 nodos en la misma subred. • Buen ancho de banda para la resincronización (paso 3). • Baja latencia para la replicación sincrónica: normalmente < 5 ms RTT; los valores más altos deben validarse con la tasa de escritura de la aplicación. | • Si los dos nodos están en subredes diferentes (común en la nube), utilice otras opciones de reenvío: un balanceador de carga, las CLI del proveedor de la nube, BGP o la redirección de DNS. • Utilice soluciones de copia de seguridad con replicación asíncrona para redes con alta latencia. |
Comparación: SafeKit vs. pila K3s estándar (MetalLB y Longhorn)
Comparación: SafeKit vs. soluciones estándar de código abierto (MetalLB + Longhorn)
| Capacidad | SafeKit (K3s.safe) | MetalLB + Longhorn (K8s estándar) |
|---|---|---|
| Arquitectura | Todo en uno: redes, replicación y conmutación por error integradas en un solo paquete. | Pila DIY (hágalo usted mismo): se requieren varios paquetes independientes (CNI, CSI, LoadBalancer). |
| Eficiencia del hardware | HA de 2 nodos puro: redundancia total sin un tercer nodo “testigo” o árbitro. | Mínimo de 3 nodos: normalmente se requieren números impares para el quórum de Etcd y la seguridad del almacenamiento. |
| Networking (VIP) | Nativo: IP virtual gestionada a nivel del sistema operativo; transparente para K3s. | Complejo: Requiere la instalación de MetalLB con configuración L2 o BGP utilizando pods de altavoz dedicados que consumen CPU/RAM en cada nodo. |
| Requisitos de almacenamiento | Síncrono a nivel de byte: replicación de archivos en tiempo real de directorios existentes; funciona en discos de sistema estándar; replicación de archivos a nivel de byte con una sobrecarga mínima de CPU/red. | A nivel de bloque: almacenamiento de bloques distribuido (Longhorn) mediante pods de almacenamiento dedicados; mayor consumo de recursos. |
| Inteligencia de conmutación por error | Estabilidad independiente: SafeKit funciona fuera del tiempo de ejecución del contenedor. Supervisa directamente el sistema operativo y el hardware, lo que garantiza la conmutación por error incluso si el plano de control Kubernetes o el motor de contenedores se cuelgan. | Dependencia circular: la lógica de conmutación por error se aloja dentro de los pods que está destinada a proteger. Si el sistema operativo host o el motor K3s se cuelgan, los pods de gestión (MetalLB/Longhorn) también se congelan, lo que a menudo requiere una intervención manual para romper el “bloqueo” |
| Administración | Simplificado: se puede gestionar a través de una única consola web; no se requiere un experto Kubernetes. | Especializado: Requiere un conocimiento profundo de YAML, Helm y los controladores internos de K8s. |
En resumen, si bien una pila estándar de bricolaje (MetalLB + Longhorn) ofrece modularidad para los expertos Kubernetes, crea una dependencia circular en la que las herramientas de almacenamiento y redes son vulnerables a los mismos fallos de nodo que están diseñadas para gestionar. SafeKit rompe este bucle al operar como una capa de infraestructura independiente; proporciona una solución de alta disponibilidad de 2 nodos más robusta y agnóstica del hardware que permanece operativa incluso si el motor Kubernetes o el sistema operativo anfitrión se cuelgan. Esto garantiza la recuperación automatizada y la integridad de los datos sin la pesada sobrecarga de recursos, el quórum obligatorio de tres nodos o la complejidad de configuración requerida por el almacenamiento de bloques distribuido tradicional y las superposiciones de red.
Guía en vídeo: Configuración de un clúster mirror SafeKit HA
Vídeo SafeKit: Agrupación en clúster a nivel de aplicación (8:47)
Aunque este vídeo demuestra la alta disponibilidad de SafeKit para Microsoft SQL Server, ofrece una excelente visión general de cómo la solución protege los entornos K3s. SafeKit funciona de forma idéntica para cualquier otra base de datos o aplicación de misión crítica.
Momentos destacados del vídeo
- 🎬 2 nodos con SQL Server (0:32)
- 🎬 Configura el clúster y el módulo mirror.safe (3:58)
- 🎬 Iniciar y probar la replicación, migración y conmutación por error de SQL en caso de fallo (4:17)
&amp;amp;amp;amp;lt;br /&amp;amp;amp;amp;gt;
🔍 Explora SafeKit
Encuentre información sobre las características, arquitecturas, vídeos, documentación y la prueba gratuita de SafeKit.
| Recurso | Descripción | Enlace |
|---|---|---|
| Características principales | Descubra por qué SafeKit es una solución de alta disponibilidad sencilla y rentable. | Descubre las características clave |
| Casos de uso | Descubra cómo SafeKit mantiene disponibles las aplicaciones y la infraestructura críticas. | Explora los casos de uso |
| Modelo de implementación | SafeKit proporciona alta disponibilidad sin necesidad de una SAN o almacenamiento compartido. | Explore el modelo de implementación |
| Estrategias de alta disponibilidad | Compare la alta disponibilidad de las máquinas virtuales con la alta disponibilidad de las aplicaciones. | Compare las dos estrategias |
| Especificaciones técnicas | Compruebe los requisitos técnicos y las limitaciones de los clústeres de SafeKit. | Lea las especificaciones técnicas |
| Vídeos | Vea demostraciones de la configuración de SafeKit y de la conmutación por error automática. | Mira los vídeos técnicos |
| Arquitectura | Aprenda cómo el clúster mirror replica archivos en tiempo real y gestiona la conmutación por error. | Explora la arquitectura Mirror |
| Arquitectura | Descubra cómo el clúster farm equilibra el tráfico de la red y gestiona la conmutación por error. | Explora la arquitectura Farm |
| Comparación de productos | Compare SafeKit con los clústeres tradicionales de alta disponibilidad. | Compare las soluciones |
| Recursos técnicos | Encuentre la documentación técnica, descargue SafeKit y acceda a la versión de prueba gratuita. | Acceda a la documentación y a la prueba gratuita |
| Módulos de aplicación | Utilice los módulos SafeKit preconfigurados para configurar la alta disponibilidad de sus aplicaciones. | Explora los módulos de la aplicación |
