Haute disponibilité Kubernetes K3s : réplication synchrone et basculement à 2 nœuds
Simplifier la haute disponibilité de K3s : pourquoi choisir SafeKit plutôt que MetalLB et Longhorn ?
Bien que la pile open-source standard (MetalLB + Longhorn) pour K3s soit puissante pour les grands centres de données, elle introduit une complexité excessive pour les sites sur site à 2 nœuds. SafeKit simplifie l’environnement K3s en remplaçant les outils réseau et de stockage autonomes par un moteur HA unique et consolidé.
Pourquoi utiliser SafeKit pour la haute disponibilité (HA) de K3s à 2 nœuds ?
- Haute disponibilité à 2 nœuds réelle : SafeKit offre une redondance complète avec seulement 2 nœuds, éliminant l’exigence de 3 nœuds pour le quorum etcd.
- Zéro perte de données (RPO = 0) : remplace le stockage par blocs à forte surcharge par une réplication synchrone au niveau de l’octet pour des performances SSD locales.
- Protection flexible au niveau des fichiers : SafeKit effectue une réplication basée sur l’hôte au niveau des fichiers, ce qui est totalement transparent pour l’application. Il protège non seulement les bases de données, mais aussi tous les dossiers et données associés. Vous pouvez répliquer les dossiers existants exactement là où ils sont installés, même sur le disque système.
- IP virtuelle intégrée (VIP) : gère nativement l’IP du cluster au niveau du noyau, ce qui élimine le besoin de configurations MetalLB distinctes.
- Basculement et retour automatique en cas de défaillance : déclenche une transition immédiate vers le nœud secondaire en cas de défaillance ; une fois que le nœud principal est opérationnel, SafeKit exécute une resynchronisation automatique des données sans intervention manuelle.
- Frais généraux ultra-faibles : SafeKit fonctionne sans les frais généraux de gestion élevés des pods de stockage (CSI/Longhorn) et des pods réseau (CNI/MetalLB) requis par les piles standard, libérant ainsi de la RAM et du CPU critiques pour vos applications.
- Idéal pour les informaticiens généralistes : remplace l’infrastructure YAML complexe pour la mise en réseau et le stockage par une interface graphique Web simple et des scripts de déploiement automatisés, vous permettant de vous concentrer uniquement sur vos applications.
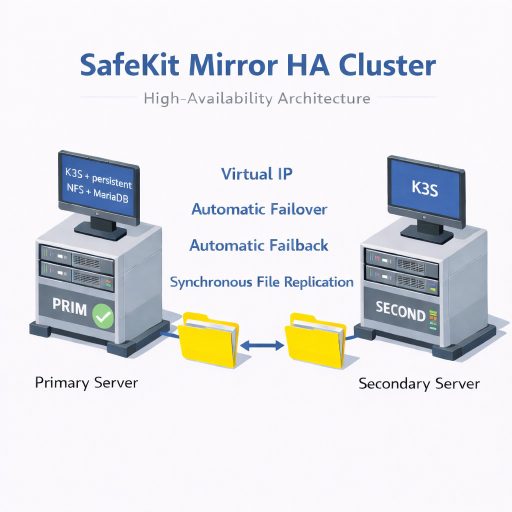
Haute disponibilité (HA) sans partage de données pour les clusters K3s à 2 nœuds
⚡ Guide d’installation rapide d’un cluster Kubernetes HA >
Table des matières
- Comment le logiciel SafeKit implémente-t-il simplement un cluster Kubernetes K3s cluster de haute disponibilité ?
- Comment le cluster mirror SafeKit fonctionne-t-il avec Kubernetes K3S ?
- Limitations de la haute disponibilité SafeKit
- Comparaison : SafeKit et la pile K3s standard (MetalLB et Longhorn)
- Guide vidéo : Configuration d’un cluster HA mirror SafeKit
- 🔍 Explorez SafeKit
Comment le logiciel SafeKit implémente-t-il simplement un cluster Kubernetes K3s cluster de haute disponibilité ?
Comment mettre en œuvre une haute disponibilité pour un cluster Kubernetes K3s à 2 nœuds ?
Vous pouvez mettre en œuvre la haute disponibilité (HA) pour un cluster Kubernetes K3s à 2 nœuds à l’aide du module mirror k3s.safe SafeKit. Cette solution vous permet de déployer un environnement redondant sans avoir besoin d’un stockage NFS externe, d’une base de données de configuration externe dédiée ou d’une expertise Kubernetes spécialisée.
Pourquoi utiliser K3s pour l’informatique en périphérie et l’IdO ?
K3s est le moteur Kubernetes privilégié pour l’IoT et l’informatique en périphérie, car il s’agit d’une distribution légère et certifiée, conçue pour les environnements aux ressources limitées. Il simplifie la surcharge opérationnelle de Kubernetes standard tout en conservant une compatibilité totale.
Quelles sont les principales caractéristiques du module mirror k3s.safe ?
Le module k3s.safe fournit une pile HA complète pour K3s en implémentant :
- Nœuds actifs doubles : Exécute simultanément 2 maîtres/agents K3s actifs pour héberger des pods.
- Réplication de base de données : réplication en temps réel de la base de données de configuration MariaDB entre les nœuds.
- Stockage persistant : Réplication des volumes persistants via un provisionneur dynamique de client NFS intégré (nfs-client).
- Continuité du réseau : Comprend une adresse IP virtuelle pour un accès client transparent.
- Reprise après sinistre automatisée : Prise en charge complète du basculement et du retour arrière automatiques.
Au-delà de K3s, quelles applications et environnements SafeKit peut-il protéger ?
SafeKit est une solution polyvalente de haute disponibilité pour Windows et Linux qui va bien au-delà du cluster mirror K3s. Elle permet la réplication synchrone en temps réel et le basculement automatique pour une large gamme de charges de travail critiques, notamment :
- Environnements virtuels et physiques : Machines virtuelles Hyper-V ou KVM complètes.
- Orchestration de conteneurs : environnements Docker, Podman.
- Données et services : Répertoires de fichiers individuels, services et diverses bases de données.
- Infrastructure Cloud : Haute disponibilité pour les applications Cloud.
SafeKit fournit également clusters farm une répartition de charge réseau et un basculement natifs pour les applications sans état telles que les serveurs Web.
💡 Découvrez la liste complète des solutions HA prises en charge ici.
Comment SafeKit assure-t-il la haute disponibilité de K3s ?
Architecture et logique de redondance pour un cluster K3s à 2 nœuds à l’aide SafeKit
| Cluster K3s à 2 nœuds | SafeKit PRIM (nœud principal) | SafeKit SECOND (nœud secondaire) |
|---|---|---|
| Exécution de la charge de travail | Les services maître et agent de K3s sont actifs, gérant l’orchestration du cluster et exécutant les pods. | Les services maître et agent de K3s restent actifs, assurant un traitement parallèle et une haute disponibilité. |
| Stockage NFS et volumes persistants | • Hôtes IP virtuelle et port NFS • Gère les partages NFS actifs exportés • Stocke les volumes persistants (PV) de K3s | Mise en miroir synchrone : SafeKit réplique tous les volumes persistants en temps réel pour garantir l’absence de perte de données. |
| Base de données de configuration | • Hôtes IP virtuelle et port MariaDB • Gère la base de données de configuration active de K3s | Réplication de base de données : la base de données MariaDB est mise en miroir de manière synchrone, ce qui préserve l’état du cluster pour le basculement. |
Mécanisme de basculement automatique : en cas de défaillance du nœud principal, SafeKit migre automatiquement les adresses IP virtuelles et les services de stockage vers le nœud secondaire, garantissant ainsi un service ininterrompu pour le cluster K3s.
Comment le cluster mirror SafeKit fonctionne-t-il avec Kubernetes K3S ?
Étape 1 : Réplication de fichiers au niveau des octets dans un cluster mirror
Cette étape illustre l’architecture de haute disponibilité entre le serveur 1 (PRIM) et le serveur 2 (SECOND). Les deux serveurs exécutent les composants maître et agent K3s tels que définis dans le tableau d’architecture.
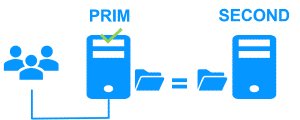
Actuellement, l’IP virtuelle (VIP), le stockage persistant NFS et MariaDB sont actifs uniquement sur le serveur 1 (PRIM). Les composants maîtres K3s des deux nœuds se synchronisent en accédant à l’état du cluster via l’IP virtuelle et le port MariaDB. SafeKit implémente la réplication synchrone de MariaDB et des fichiers NFS persistants, garantissant une perte de données nulle (RPO = 0) en cas de panne.
Les maîtres K3s répartissent la charge de travail sur les deux nœuds (ou plus) en communiquant directement avec les agents K3s. Les clients externes se connectent au
l’adresse IP virtuelle du cluster sur le nœud PRIM. À l’aide des mécanismes Kubernetes standard, le maître K3s relaie le trafic vers les pods distribués sur les nœuds. De même, les pods accèdent à leurs volumes persistants (PV) sur le serveur PRIM via l’adresse IP virtuelle et le port NFS.
Étape 2 : Basculement automatique et continuité de service
Lorsque le serveur 1 (PRIM) tombe en panne, le serveur 2 (SECOND) prend automatiquement le relais des opérations du cluster pour assurer la continuité.
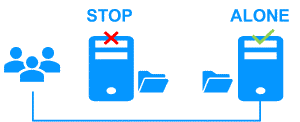
SafeKit détecte la défaillance et migre immédiatement l’adresse IP virtuelle du cluster vers le serveur 2. Il active ensuite les services MariaDB et NFS locaux. Grâce à la réplication synchrone effectuée à l’étape 1, toutes les bases de données MariaDB et les fichiers de volume persistant (PV) NFS sont déjà à jour sur le serveur 2, ce qui garantit l’absence de perte de données.
L’état du cluster étant préservé, le maître K3s du serveur 2 poursuit son exécution. Il détecte la perte de l’agent du serveur 1 et replanifie automatiquement les pods affectés sur les agents K3s actifs restants. Le temps de basculement total (RTO) est la somme de l’intervalle de détection des pannes (par défaut : 30 secondes) et du temps nécessaire à l’initialisation des composants K3s sur le nœud secondaire.
Pendant que le serveur 1 est hors ligne, les services MariaDB et NFS continuent de s’exécuter sur le serveur 2, en écrivant les modifications uniquement localement.
Étape 3 : Rétablissement de la situation antérieure et réintégration automatique
Le basculement inverse se produit lorsque le serveur 1 est redémarré après la résolution du problème initial. SafeKit resynchronise automatiquement les fichiers MariaDB et NFS, en mettant à jour uniquement les données modifiées sur le serveur 2 pendant la panne. Ce processus de réintégration est non perturbateur ; les composants maître et agent de K3s continuent de s’exécuter sur le serveur 2 sans interruption.
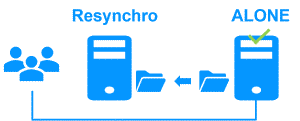
SafeKit optimise le temps de récupération en fonction de la manière dont le serveur a été arrêté :
- Arrêt propre : Si SafeKit a été arrêté intentionnellement sur le serveur 1, seules les zones spécifiques modifiées dans les fichiers sont resynchronisées à l’aide des bitmaps de suivi des modifications. Cela garantit une réintégration ultra-rapide.
- Panne système (par exemple, panne de courant) : Si le serveur 1 a subi un arrêt brutal, les bitmaps de modification sont ignorés pour des raisons de sécurité. SafeKit resynchronise plutôt tous les fichiers avec une horodatage de modification plus récent que le dernier point de synchronisation établi, assurant ainsi l’intégrité totale des données.
Étape 4 : Restauration de la haute disponibilité et de la répartition de la charge
Après la réintégration, le cluster revient en mode mirror complet, reflétant l’état décrit à l’étape 1. Le système est à nouveau dans un état de haute disponibilité : les services MariaDB et NFS restent actifs sur le serveur 2, tandis que SafeKit effectue une réplication en temps réel de toutes les mises à jour de fichiers vers le serveur 1.
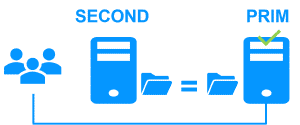
Les composants K3s Master et K3s Agent sont automatiquement redémarrés sur le serveur 1. Le planificateur Kubernetes reconnaît désormais le serveur 1 comme un nœud sain et peut commencer à replanifier les pods pour répartir la charge de travail sur les deux serveurs.
Si l’administrateur préfère que les services MariaDB et NFS s’exécutent sur le serveur 1 (restauration du rôle PRIM d’origine), un basculement peut être déclenché manuellement via la console Web à un moment opportun ou automatisé via les paramètres de configuration.
Comment configurer un cluster mirror SafeKit ?
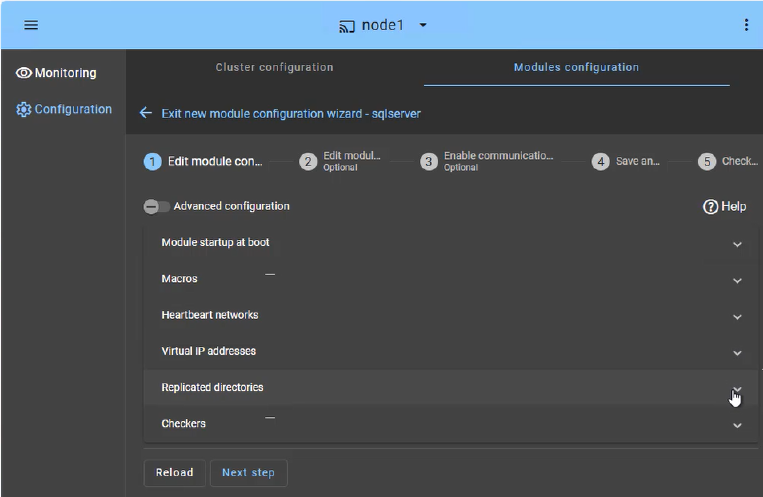
La console Web SafeKit fournit une interface intuitive pour orchestrer la haute disponibilité de vos applications critiques. En quelques étapes seulement, vous pouvez configurer un cluster mirror SafeKit pour assurer la continuité des activités :
- Basculement d’application (onglet Macros) : Définissez les services d’application spécifiques à redémarrer automatiquement en cas de défaillance.
- Réseau(x) de pulsation : Chemin(s) de communication dédié(s) utilisé(s) par les nœuds du cluster pour surveiller en permanence l’état de santé et la disponibilité de chacun et pour synchroniser les décisions de basculement.
- Gestion de l’IP virtuelle : configurez l’IP virtuelle (VIP) pour une reconnexion transparente du client après un basculement.
- Réplication en temps réel : sélectionnez les répertoires critiques pour la réplication synchrone au niveau de l’octet, basée sur l’hôte.
- Checkers : surveillez l’état de l’application et déclenchez une récupération automatique si une défaillance de processus est détectée.
Le cluster SafeKit inclut un vérificateur de split-brain dédié pour résoudre les problèmes d’isolement du réseau sans avoir besoin d’une troisième machine témoin ou d’un réseau de pulsation supplémentaire. En savoir plus sur la pulsation, le basculement et le quorum dans un cluster.
Comment surveiller un cluster mirror SafeKit ?

La console de gestion SafeKit offre une vue unifiée de votre infrastructure de haute disponibilité. Elle permet aux administrateurs de surveiller l’état opérationnel du cluster et de suivre la synchronisation des données en temps réel.
Pour un cluster mirror à 2 nœuds, la console affiche clairement les rôles de chaque serveur :
- PRIM (primaire) : le nœud actif exécutant actuellement l’application et gérant l’adresse IP virtuelle. Il effectue des écritures sur le stockage local et la réplication en temps réel vers le nœud secondaire.
- SECOND (Secondaire) : Le nœud de secours reçoit des mises à jour synchrones au niveau de l’octet. Il est prêt à prendre le relais instantanément en cas de défaillance du nœud principal.
- État ALONE : vous avertit visuellement lorsque le cluster s’exécute sur un seul nœud (par exemple, pendant la maintenance ou après une panne), indiquant que la redondance est temporairement perdue.
- Progression de la resynchronisation : lorsqu’un nœud défaillant se rétablit, son statut devient orange pendant la réintégration des données en arrière-plan, garantissant l’absence d’interruption pendant la phase de « retour à la normale ».
Au-delà des simples icônes d’état, l’interface fournit une orchestration de basculement en un clic, vous permettant de réaffecter manuellement le rôle principal pour la maintenance planifiée tout en assurant la disponibilité continue de l’activité des utilisateurs.
Limitations de la haute disponibilité SafeKit
| Limite / Exigence | Raison et impact | Alternative recommandée |
|---|---|---|
| Taille de la réplication : quelques To | Temps de resynchronisation après une défaillance (étape 3) : • Réseau à 1 Gb/s ≈ 3 heures/To • Réseau 10 Gb/s ≈ 1 heure/To (selon les performances d’écriture du disque) | • Utiliser un stockage partagé externe (plus coûteux, plus complexe). |
| Nombre de fichiers : < 1 000 000 | • Performance du temps de resynchronisation après une panne (étape 3). • Temps nécessaire pour comparer chaque fichier entre les deux nœuds. | • Placez les nombreux fichiers à répliquer dans un disque dur virtuel/une machine virtuelle. • Dans ce cas, seuls les fichiers représentant le disque dur virtuel ou la machine virtuelle seront répliqués et resynchronisés. |
| Capacité de basculement : ≤ 32 machines virtuelles | • Chaque machine virtuelle s’exécute dans un module mirror indépendant. • Maximum de 32 modules mirror fonctionnant sur le même cluster. | • Utiliser un stockage partagé externe et une autre solution de clustering de machines virtuelles (plus coûteuse et plus complexe). |
| Architecture réseau : réseau LAN/VLAN entre sites distants | • Basculement automatique de l’adresse IP virtuelle avec 2 nœuds dans le même sous-réseau. • Bonne bande passante pour la resynchronisation (étape 3). • Faible latence pour la réplication synchrone : généralement < 5 ms RTT ; les valeurs plus élevées doivent être validées par rapport au taux d’écriture de l’application. | • Si les deux nœuds se trouvent dans des sous-réseaux différents (ce qui est courant dans le cloud), utilisez d’autres options de réacheminement : un équilibreur de charge, des CLI de fournisseur de cloud, BGP ou une redirection DNS. • Utilisez des solutions de sauvegarde avec réplication asynchrone pour les réseaux à latence élevée. |
Comparaison : SafeKit et la pile K3s standard (MetalLB et Longhorn)
Comparaison : SafeKit vs. solution open source standard (MetalLB + Longhorn)
| Capacité | SafeKit (K3s.safe) | MetalLB + Longhorn (K8s standard) |
|---|---|---|
| Architecture | Tout-en-un : Réseau, réplication et basculement intégrés dans un seul et même ensemble. | Pile DIY (Do It Yourself) : plusieurs packages indépendants requis (CNI, CSI, LoadBalancer). |
| Efficacité du matériel | HA à 2 nœuds pur : redondance complète sans 3e nœud « témoin » ou d’arbitrage. | Minimum de 3 nœuds : Nécessite généralement des nombres impairs pour le quorum Etcd et la sécurité du stockage. |
| Réseautage (VIP) | Natif : IP virtuelle gérée au niveau du système d’exploitation ; transparente pour K3s. | Complexe : Nécessite l’installation de MetalLB avec une configuration L2 ou BGP à l’aide de pods de diffusion dédiés qui consomment du CPU/de la RAM sur chaque nœud. |
| Configuration requise en matière de stockage | Synchronisation au niveau de l’octet : réplication de fichiers en temps réel des répertoires existants ; fonctionne sur les disques système standard ; réplication de fichiers au niveau de l’octet avec une surcharge minimale du processeur et du réseau. | Niveau bloc : Stockage en bloc distribué (Longhorn) utilisant des pods de stockage dédiés ; consommation de ressources plus élevée. |
| Intelligence de basculement | Stabilité indépendante : SafeKit fonctionne en dehors de l’environnement d’exécution des conteneurs. Il surveille directement le système d’exploitation et le matériel, assurant le basculement même si le plan de contrôle Kubernetes ou le moteur de conteneurs se bloque. | Dépendance circulaire : La logique de basculement est hébergée à l’intérieur des pods qu’elle est censée protéger. Si le système d’exploitation hôte ou le moteur K3s se fige, les pods de gestion (MetalLB/Longhorn) se figent également, ce qui nécessite souvent un triage manuel pour briser le « verrou » |
| Administration | Simplifié : Gérable via une seule console web ; aucun expert Kubernetes requis. | Spécialisé : Nécessite une connaissance approfondie de YAML, Helm et des contrôleurs internes de K8s. |
En résumé, si une pile DIY standard (MetalLB + Longhorn) offre une modularité pour les experts Kubernetes, elle crée une dépendance circulaire où les outils de stockage et de mise en réseau sont vulnérables aux mêmes pannes de nœuds qu’ils sont conçus pour gérer. SafeKit rompt cette boucle en fonctionnant comme une couche d’infrastructure indépendante ; il fournit une solution HA à 2 nœuds plus robuste et indépendante du matériel qui reste opérationnelle même si le moteur Kubernetes ou le système d’exploitation hôte se bloque. Cela garantit une récupération automatisée et l’intégrité des données sans la lourde surcharge de ressources, le quorum obligatoire à trois nœuds ou la complexité de configuration requise par les superpositions de stockage en bloc distribué et de mise en réseau traditionnelles.
Guide vidéo : Configuration d’un cluster mirror SafeKit HA
Vidéo SafeKit : Clustering au niveau de l’application (8:47)
Bien que cette vidéo présente la haute disponibilité de SafeKit pour Microsoft SQL Server, elle donne un excellent aperçu de la façon dont la solution sécurise les environnements K3s. SafeKit fonctionne de la même manière pour toute autre base de données ou application critique pour l’entreprise.
Moments forts de la vidéo
- 🎬 2 nœuds avec SQL Server (0:32)
- 🎬 Configurer le cluster et le module mirror.safe (3:58)
- 🎬 Démarrer et tester la réplication, la migration et le basculement SQL en cas de panne (4:17)
&amp;amp;amp;amp;lt;br /&amp;amp;amp;amp;gt;
🔍 Explorez SafeKit
Trouvez des informations sur les fonctionnalités, les architectures, les vidéos, la documentation et l’essai gratuit de SafeKit.
| Ressource | Description | Lien |
|---|---|---|
| Caractéristiques principales | Découvrez pourquoi SafeKit est une solution de haute disponibilité simple et économique. | Découvrez les fonctionnalités clés |
| Cas d’utilisation | Découvrez comment SafeKit assure la disponibilité des applications et des infrastructures critiques. | Explorez les cas d’utilisation |
| Modèle de déploiement | SafeKit assure une haute disponibilité sans SAN ni stockage partagé. | Explorez le modèle de déploiement |
| Stratégies de haute disponibilité | Comparez la haute disponibilité des machines virtuelles avec la haute disponibilité des applications. | Comparez les deux stratégies |
| Spécifications techniques | Consultez les exigences et les limitations techniques des clusters SafeKit. | Lisez les spécifications techniques |
| Vidéos | Regardez des démonstrations de la configuration de SafeKit et du basculement automatique. | Regardez les vidéos techniques |
| Architecture | Découvrez comment le cluster mirror réplique les fichiers en temps réel et gère le basculement. | Découvrez l’architecture Mirror |
| Architecture | Découvrez comment le cluster farm équilibre le trafic réseau et gère le basculement. | Découvrez l’architecture Farm |
| Comparaison de produits | Comparez SafeKit aux clusters de haute disponibilité. | Comparer les solutions |
| Ressources techniques | Trouvez la documentation technique, téléchargez SafeKit et accédez à la version d’essai gratuite. | Accéder à la documentation et à l’essai gratuit |
| Modules d’application | Utilisez les modules SafeKit préconfigurés pour configurer la haute disponibilité de vos applications. | Explorez les modules de l’application |
