Cosa sono RPO e RTO? Definizioni, esempi e strategie HA
Breve riepilogo: RPO e RTO
- RPO (Recovery Point Objective): Misura la perdita di dati. Definisce la durata massima dei file che devono essere ripristinati affinché le operazioni possano riprendere.
- RTO (Recovery Time Objective): misura i tempi di inattività. È l’intervallo di tempo entro il quale un processo aziendale deve essere ripristinato.
- La differenza fondamentale: RPO riguarda archiviazione/backup, mentre RTO riguarda la velocità di ripristino/failover.
- Funzionalità SafeKit: Fornisce 0 RPO (nessuna perdita di dati) e RTO basso (riavvio rapido) tramite replica sincrona e failover automatico.
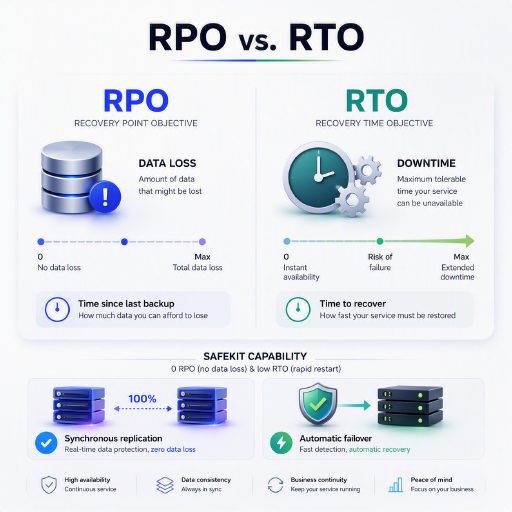
RPO e RTO: confronto tra perdita di dati e tempi di ripristino in SafeKit
Sommario
- Come posso calcolare RPO e RTO per una soluzione ad alta disponibilità e continuità aziendale?
- Come posso determinare RPO e RTO per una soluzione di backup e ripristino di emergenza?
- Come fa un mirror cluster SafeKit a raggiungere un RPO pari a zero e un RTO basso?
- Quali sono i parametri di riferimento RTO per un cluster farm SafeKit con bilanciamento del carico?
- Tabelle di confronto: RTO vs RPO
- Elevata disponibilità in azione: demo in tempo reale di RPO zero e RTO quasi zero
- Domande frequenti su RPO e RTO
- SafeKit Hub di navigazione ad alta disponibilità
Come posso calcolare RPO e RTO per una soluzione ad alta disponibilità e continuità aziendale?
Cos’è l’alta disponibilità?
Alta disponibilità (HA) è un’architettura tecnica progettata per garantire che un sistema rimanga operativo e accessibile per una percentuale di tempo specificata (ad esempio, 99,99%).
Per raggiungere gli obiettivi RPO e RTO definiti in un Piano di continuità aziendale, l’alta disponibilità viene generalmente implementata attraverso due architetture principali:
- Sistema di dischi condivisi su SAN: un cluster tradizionale in cui 2 nodi sono collegati a una Storage Area Network (SAN) centrale. Se un nodo fallisce, l’altro assume l’accesso ai dati condivisi.
- Replica sincrona senza SAN: una moderna architettura “shared-nothing”, implementata dal software SafeKit, in cui i dati vengono replicati in tempo reale tra i dischi locali di 2 nodi indipendenti, eliminando la necessità di una SAN.
Qual è l’RPO di una soluzione ad alta disponibilità?
RPO (Recovery Point Objective) definisce il volume massimo tollerabile di perdita di dati misurato nel tempo. Per una vera soluzione ad alta disponibilità, l’RPO target è zero.
Quando si implementa un cluster ad alta disponibilità con failover automatico, un RPO pari a zero garantisce il riavvio dell’applicazione senza perdita di dati.
- Sistema di dischi condivisi su SAN: poiché entrambi i nodi accedono agli esatti stessi blocchi fisici di dati, non vi è alcun “delta” o ritardo tra i nodi, garantendo la totale coerenza dei dati durante un failover.
- Replica sincrona basata su software: un approccio SANless in cui ogni operazione di “scrittura” viene replicata in tempo reale sulla rete. L’applicazione riceve un riconoscimento di scrittura solo dopo che i dati sono stati archiviati in modo sicuro su entrambi i nodi. Questo processo sincrono di “doppia scrittura” garantisce nessuna perdita di dati anche in caso di guasto del server primario.
Qual è l’RTO di una soluzione ad alta disponibilità?
RTO (Recovery Time Objective) rappresenta la durata massima tollerabile del tempo di inattività dopo un’interruzione del servizio. Nel contesto dell’alta disponibilità, l’RTO dovrebbe essere minimo per garantire l’accesso continuo alle applicazioni critiche.
Per ottenere un RTO basso, una soluzione ad alta disponibilità utilizza il failover automatico per rilevare guasti hardware o software e riavviare immediatamente l’applicazione. In un tipico cluster ad alta disponibilità, l’RTO è di circa un minuto, calcolato come:
- Tempo di rilevamento errore: l’intervallo richiesto dal sistema per identificare la perdita di battito cardiaco di un nodo o di un’applicazione.
- Tempo di riavvio automatico: il tempo necessario per l’inizializzazione dei servizi applicativi sul nodo sopravvissuto.
Come posso determinare RPO e RTO per una soluzione di backup e ripristino di emergenza?
Cos’è una soluzione di backup?
Una Soluzione di backup è una strategia di protezione dei dati progettata per creare copie periodiche dei dati su un dispositivo di archiviazione secondario o sul cloud. A differenza dell’elevata disponibilità, il backup si concentra sulla conservazione dei dati a lungo termine e sul ripristino dalla corruzione dei dati o da disastri a livello di sito.
Per soddisfare gli obiettivi RPO e RTO definiti in un Piano di ripristino di emergenza, il backup viene in genere implementato attraverso due metodi principali:
- Istantanee pianificate: un processo in cui vengono acquisite copie di dati temporizzate a intervalli fissi (ad esempio, quotidianamente). Ciò definisce l’RPO, poiché tutti i dati modificati tra l’ultimo snapshot e l’errore vengono persi.
- Recupero offsite o cloud: un’architettura in cui i dati vengono archiviati in una posizione fisica separata. Sebbene ciò garantisca la sopravvivenza dei dati, si traduce in un RTO più elevato perché i dati devono essere trasferiti e ripristinati prima che l’applicazione possa riavviarsi.
Qual è l’RPO di una soluzione di backup?
RPO (Recovery Point Objective) in un contesto di backup definisce l’età dei file che devono essere ripristinati dallo spazio di archiviazione affinché le normali operazioni possano riprendere. A differenza dell’elevata disponibilità, una soluzione di backup comporta in genere un RPO diverso da zero, che rappresenta il tempo trascorso dal completamento corretto dell’ultimo backup.
La quantità di perdita di dati in una strategia di backup è determinata dalla frequenza di backup. A seconda dell’architettura, questo RPO può variare da minuti a 24 ore:
- Istantanee incrementali: un metodo in cui solo i blocchi di dati modificati vengono salvati a intervalli prestabiliti. Se viene eseguito un backup ogni 4 ore, l’RPO massimo è 4 ore, il che significa che tutti i dati creati tra l’ultimo snapshot e il crash del sistema verranno persi in modo permanente.
- Backup completi giornalieri: un approccio tradizionale in cui viene eseguita una copia completa dei dati una volta al giorno (solitamente durante la notte). Ciò si traduce in un RPO 24 ore, che può essere accettabile per i dati non critici ma spesso non è sufficiente per i database transazionali.
Qual è l’RTO di una soluzione di backup?
RTO (Recovery Time Objective) in una strategia di backup è la durata del tempo necessario per ripristinare i dati da un supporto di backup e riportare l’applicazione a uno stato operativo. A differenza dell’elevata disponibilità, l’RTO per il backup è significativamente più lungo perché prevede processi di ripristino manuali o basati su script.
Per una soluzione di backup, l’RTO può variare da diverse ore a giorni, a seconda del volume di dati e dell’architettura di ripristino. Il tempo di inattività totale viene calcolato come:
- Tempo di trasferimento dati: il tempo necessario per spostare i dati dallo spazio di archiviazione di backup (dischi locali, nastri o cloud) al server di produzione.
- Tempo di riconfigurazione del sistema: l’intervallo necessario per inserire i dati nell’applicazione, ricostruire gli indici e verificare l’integrità dei dati prima che gli utenti possano accedere nuovamente.
In che modo un mirror cluster SafeKit raggiunge un RPO pari a zero e un RTO basso?
Cos’è il cluster di specchi SafeKit?
Il SafeKit Mirror Cluster è una soluzione ad alta disponibilità basata su software che implementa un’architettura “shared-nothing”. A differenza dei cluster tradizionali che richiedono una SAN costosa, SafeKit utilizza le risorse locali di due server standard per creare un ambiente altamente resiliente.
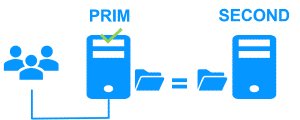
Per garantire la massima operatività e protezione dei dati nell’ambito del Piano di continuità aziendale, il mirror cluster SafeKit funziona attraverso due meccanismi integrati:
- Replica sincrona in tempo reale: SafeKit esegue il mirroring dei dati attraverso la rete tra i dischi locali dei nodi primari e secondari. Ciò garantisce che l’RPO sia pari a zero, poiché ogni byte di dati viene protetto su entrambi i server prima che una transazione venga finalizzata.
- Failover automatico dell’IP e dell’applicazione: Se il nodo primario si guasta, SafeKit rileva automaticamente la perdita di heartbeat e ristabilisce l’applicazione e il relativo indirizzo IP virtuale sul nodo secondario. Ciò si traduce in un RTO di circa un minuto, garantendo una continuità del servizio senza interruzioni.
Qual è l’RPO di un cluster di mirror SafeKit?
L’RPO di un cluster mirror SafeKit è zero perché la replica dei dati tra i nodi è sincrona e in tempo reale.
Questa garanzia di perdita di dati pari a zero si ottiene attraverso un processo di riconoscimento di scrittura: una scrittura su disco viene confermata all’applicazione solo dopo che è stata scritta con successo sui dischi locali sia del nodo primario che di quello secondario.
Al contrario, con la replica asincrona, l’RPO è maggiore di zero. Poiché è presente un ritardo tra la scrittura primaria e l’aggiornamento secondario, un errore comporterà la perdita di dati durante il failover sul server secondario. Per la continuità aziendale mission-critical, la replica sincrona è l’unico modo per garantire che l’applicazione venga riavviata con il 100% di integrità dei dati.
Qual è l’RTO di un cluster di mirror SafeKit?
In una configurazione standard, l’RTO di un mirror cluster SafeKit è di circa un minuto. SafeKit offre la flessibilità necessaria per implementare l’alta disponibilità a livello di applicazione o a livello di VM, ciascuno dei quali incide sui tempi di ripristino in modo diverso:
- HA a livello di applicazione: questo è l’approccio SafeKit ottimizzato in cui il software monitora servizi applicativi specifici.
- Errore hardware: RTO = timeout heartbeat (predefinito 30 secondi) + tempo di riavvio dell’applicazione.
- Errore software: RTO = ora di arresto dell’applicazione + ora di riavvio dell’applicazione.
- Vantaggio principale: poiché il sistema operativo è già in esecuzione sul nodo secondario, non vi è alcun ritardo nell’avvio del sistema operativo, con conseguente ripristino più rapido possibile per la continuità aziendale.
- HA a livello di VM: In questo scenario, SafeKit protegge l’intero ambiente della macchina virtuale.
- Ripristino da errori: RTO = rilevamento errori + Ora di riavvio del sistema operativo + ora di riavvio dell’applicazione.
- Compromesso tecnico: L’RTO è naturalmente più lungo (diversi minuti) perché il nodo secondario deve eseguire un avvio a freddo completo del sistema operativo prima ancora che l’applicazione possa iniziare l’inizializzazione.
Utilizzando l’alta disponibilità a livello di applicazione, SafeKit elimina la “penalità di riavvio” inerente alla virtualizzazione standard, garantendo che il tuo Piano di continuità aziendale raggiunga il minor tempo di inattività possibile.
Quali sono i parametri di riferimento RTO per un cluster farm SafeKit con bilanciamento del carico?
Cos’è il cluster agricolo SafeKit?
Il SafeKit Farm Cluster è una soluzione ad alta disponibilità basata su software progettata per applicazioni stateless (come server Web) che richiedono sia scalabilità che ridondanza. A differenza di un cluster mirror incentrato sulla replica dei dati, un cluster farm distribuisce il traffico in entrata su più nodi attivi.
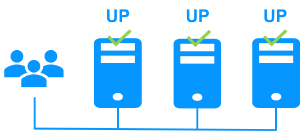
Per mantenere la continuità aziendale per ambienti a traffico elevato, il cluster farm SafeKit opera attraverso due meccanismi principali:
- Bilanciamento del carico di rete: SafeKit utilizza un indirizzo IP virtuale per distribuire il traffico di rete in entrata su una “farm” di più server attivi. Ciò garantisce che nessun singolo server venga sopraffatto e massimizza le prestazioni dell’applicazione.
- Rilevamento e riconfigurazione automatici dei guasti: Se un nodo della farm si guasta, SafeKit rileva l’errore tramite heartbeat e ridistribuisce immediatamente il traffico tra i restanti nodi integri. Ciò fornisce un RTO prossimo allo zero per il servizio complessivo, poiché altri nodi sono già attivi e pronti ad assorbire il carico.
Qual è l’RPO di un cluster agricolo SafeKit?
L’RPO (Recovery Point Objective) per un SafeKit Farm Cluster è generalmente considerato Non applicabile (N/A). Questo perché un cluster farm è progettato specificamente per applicazioni senza stato in cui i dati non vengono archiviati localmente sui nodi.
Poiché un cluster farm si concentra sul bilanciamento del carico di rete anziché sulla sincronizzazione dei dati, non esiste alcuna replica dei dati tra i nodi all’interno del cluster stesso. In un tipico Piano di continuità aziendale che coinvolge un’architettura agricola:
- Operazioni stateless: tutti i nodi della farm sono identici e non contengono dati persistenti; pertanto, non vi è alcuna “perdita di dati” da misurare durante un guasto del nodo.
- Archiviazione dati esterna: se l’applicazione richiede la persistenza dei dati, in genere viene gestita da un backend separato SafeKit Mirror Cluster dove l’RPO sarebbe quindi pari a zero.
Qual è l’RTO di un cluster agricolo SafeKit?
In un’architettura farm, l’RTO è ridotto a pochi secondi perché in genere tutti i nodi sono attivi contemporaneamente. Il tempo di ripristino è determinato dalla velocità con cui il cluster riconfigura la distribuzione del traffico:
- Guasto hardware: L’RTO è uguale al timeout di rilevamento guasto tra i canali di monitoraggio (l’impostazione predefinita è pochi secondi). Una volta rilevata la perdita di heartbeat, i filtri di bilanciamento del carico IP virtuale vengono riconfigurati automaticamente per reindirizzare il traffico ai restanti nodi integri.
- Errore software o riavvio pianificato: l’RTO viene calcolato come il tempo di arresto dell’applicazione più il tempo di riavvio dell’applicazione su quel nodo specifico, durante il quale gli altri nodi della farm continuano a gestire tutto il traffico in entrata.
Questo meccanismo “attivo-attivo” garantisce che per i servizi stateless l’impatto sulla continuità aziendale sia quasi impercettibile per l’utente finale, poiché non è necessario inizializzare il servizio su un nuovo nodo standby.
Tabelle di confronto: RTO vs RPO
Definizione semantica: RTO vs. RPO
| Metrico | Acronimo | Definizione | Area di messa a fuoco |
|---|---|---|---|
| Obiettivo del tempo di recupero | RTO | La durata di tempo prevista per ripristinare un processo aziendale dopo un errore. | Disponibilità/Tempi di inattività |
| Obiettivo del punto di ripristino | RPO | La durata massima dei file che devono essere ripristinati dal backup affinché le operazioni possano riprendere. | Perdita/integrità dei dati |
Disponibilità elevata (HA) rispetto al backup standard
| Caratteristica | Soluzioni di backup | Alta disponibilità (SafeKit) |
|---|---|---|
| Automazione del recupero | Intervento manuale | Failover automatico |
| Obiettivo RTO | Ore a Giorni | Da secondi a ~1 minuto |
| Obiettivo RPO | > 0 (Ultimo punto di backup) | 0 (replica sincrona) |
Benchmark RTO e RPO per i cluster SafeKit
| Architettura | Caso d’uso | RTO (disponibilità) | RPO (perdita di dati) |
|---|---|---|---|
| Gruppo di specchi | Replica in tempo reale | ~1 minuto (battito cardiaco + riavvio) | 0 (nessuna perdita di dati) |
| Gruppo agricolo | Bilanciamento del carico di rete | Pochi secondi | N/D (apolide) |
Elevata disponibilità in azione: demo in tempo reale di RPO zero e RTO quasi zero
Video: raggiungimento di RPO zero e RTO basso in un cluster di mirror SafeKit (8:47)
Scopri come SafeKit gestisce un guasto critico. Questo video dimostra la replica sincrona che garantisce che non vengano persi dati (RPO 0) in un database SQL e il riavvio automatico dei servizi sul nodo secondario (RTO basso).
Capitoli
- 🎬 2 nodi con SQL Server (0:32)
- 🎬 Configura il cluster e il modulo mirror.safe (3:58)
- 🎬 Avvia e testa la replica SQL, la migrazione e il failover in caso di crash (4:17)
Video: raggiungimento di un RTO vicino allo zero in un cluster di aziende agricole SafeKit (5:03)
Guarda come SafeKit gestisce una web farm Apache per fornire scalabilità delle prestazioni e failover istantaneo.
Capitoli
- 🎬 Nodi 2 con Apache (0:13)
- 🎬 Configura il cluster e il modulo farm.safe (2:20)
- 🎬 Avvia e testa il bilanciamento del carico di rete, failover in caso di arresto anomalo (2:30)
Domande frequenti: ottimizzazione di RPO e RTO per la continuità aziendale
RPO e RTO possono essere pari a zero?
Sì. Raggiungere un RPO pari a zero significa nessuna perdita di dati, cosa possibile attraverso il mirroring sincrono dei dati. Un RTO prossimo allo zero si ottiene tramite un software di failover automatizzato come SafeKit, che rileva gli errori e riavvia le applicazioni su un nodo secondario in pochi secondi o minuti.
Cos’è più importante: RPO o RTO?
Nessuno dei due è intrinsecamente più importante; svolgono ruoli diversi. RPO (Recovery Point Objective) si concentra sulla perdita di dati: quanti dati puoi permetterti di perdere. RTO (Recovery Time Objective) si concentra sui tempi di inattività: quanto velocemente devi tornare online. Per le applicazioni mission-critical, entrambi devono essere ridotti al minimo.
Qual è la differenza in RPO e RTO tra SafeKit a livello di applicazione e a livello di VM?
Sebbene entrambi garantiscano un RPO pari a 0 tramite replica sincrona, differiscono nel tempo di ripristino:
- Livello applicazione: RTO più veloce (circa 1 minuto) perché solo i servizi applicativi si riavviano su un sistema operativo già in esecuzione. Rileva inoltre arresti anomali specifici di software/processi.
- Livello VM: RTO più elevato perché l’intera macchina virtuale deve essere riavviata sull’host secondario. Sebbene sia indipendente dall’applicazione, manca di un monitoraggio granulare dei processi applicativi stessi.
Qual è la differenza tra le soluzioni HA e quelle di backup in termini di RTO?
L’elevata disponibilità (HA) offre in genere un RTO molto inferiore (da secondi a minuti) perché gestisce automaticamente gli errori locali. Il ripristino di emergenza con soluzioni di backup (DR) solitamente ha un RTO più elevato (da ore a giorni) perché prevede il ripristino di dati e servizi in un sito geograficamente distante dopo una grave catastrofe.
Come posso ottenere il miglior RPO e RTO tra siti remoti?
Il raggiungimento di un RPO pari a zero e un RTO prossimo allo zero su siti remoti richiede una combinazione di replica sincrona e una LAN estesa (VLAN estesa):
- LAN estesa/VLAN estesa: Estendendo la stessa sottorete (Livello 2) su due data center, puoi spostare un’applicazione dal Sito A al Sito B senza modificarne l’indirizzo IP, evitando complessi aggiornamenti DNS.
- La soluzione SafeKit: SafeKit sfrutta questa funzionalità fornendo un IP virtuale definito dal software (VIP) che fluttua tra i siti. Reindirizza istantaneamente il traffico al sito secondario utilizzando Gratuitous ARP (GARP).
Ciò fornisce un RPO = 0 (mirroring in tempo reale) e un RTO minimo (failover in circa 1 minuto) senza intervento umano.
Perché la combinazione di alta disponibilità e backup è essenziale per ottimizzare RPO e RTO?
Combinare l’alta disponibilità (HA) con una soluzione di backup è l’unico modo per ottenere una strategia di ripristino “migliore di entrambi i mondi”. Sebbene vengano spesso discussi insieme, risolvono diverse parti dell’equazione RPO/RTO:
- Elevata disponibilità (tramite SafeKit): Ottimizza per RTO e RPO prossimi allo zero in caso di guasti hardware o software. Utilizzando la replica sincrona in tempo reale, il server secondario è sempre aggiornato. Se il primario fallisce, il servizio si riavvia immediatamente sul secondario senza perdita di dati.
- Soluzioni di backup: Proteggi dai problemi di integrità dei dati (come ransomware o cancellazione accidentale). Poiché HA replica le modifiche istantaneamente, replicherà “fedelmente” un virus o un record di database eliminato sul server di standby. Un backup consente di “tornare indietro nel tempo” a un punto precedente al verificarsi del danneggiamento.
- L’approccio ibrido: per la massima resilienza, le organizzazioni utilizzano un’architettura ibrida a 3 nodi. Ciò include un cluster locale a 2 nodi con replica sincrona per HA immediato e una terza copia remota (asincrona) per Disaster Recovery. Questa difesa a più livelli garantisce la disponibilità di una copia “attiva” per il ripristino immediato e di una copia “storica” per la sicurezza dei dati.
🔍 Hub di Navigazione SafeKit High Availability
Esplora SafeKit: Funzionalità, video tecnici, documentazione e prova gratuita
| Tipo di Risorsa | Descrizione | Link Diretto |
|---|---|---|
| Funzionalità Chiave | Perché scegliere SafeKit per un’alta disponibilità semplice ed economica? | Perché scegliere SafeKit per l’High Availability |
| Casi d’uso | Scopri come SafeKit garantisce l’alta affidabilità delle infrastrutture critiche | Vedi tutti i casi d’uso (Software OEM, Server Edge, SCADA e altro) |
| Modello di Distribuzione | HA SANless All-in-One: Clustering Software Shared-Nothing | Scopri SafeKit All-in-One SANless HA |
| Strategie HA | SafeKit: Alta disponibilità a livello di Infrastruttura (VM) vs. Applicazione | SafeKit HA e ridondanza: Livello VM vs. Applicativo |
| Specifiche Tecniche | Limitazioni tecniche per il Clustering SafeKit | Limitazioni SafeKit High Availability |
| Video | SafeKit: Demo di configurazione e failover in Alta Disponibilità | Tutorial Failover SafeKit |
| Architettura | Come funziona il Mirror Cluster SafeKit (Replica in tempo reale e Failover) | SafeKit Mirror Cluster: Replica in tempo reale e Failover |
| Architettura | Come funziona il Farm Cluster SafeKit (Bilanciamento del carico di rete e Failover) | SafeKit Farm Cluster: Bilanciamento del carico e Failover |
| Vantaggi Competitivi | Confronto: SafeKit vs. Cluster High Availability (HA) Tradizionali | Confronto SafeKit vs. Cluster HA Tradizionali |
| Risorse Tecniche | SafeKit High Availability: Documentazione, Download e Prova | Prova gratuita SafeKit HA e Documentazione Tecnica |
| Soluzioni Pre-configurate | Libreria Moduli Applicativi SafeKit: Soluzioni HA pronte all’uso | Moduli Applicativi SafeKit High Availability |
