---
title: "Che cosa sono RPO e RTO? Definizioni, esempi e strategie di alta disponibilità."
canonical: "https://safekit.eviden.com/it/best-practises/what-is-rpo-and-rto-with-examples/"
description: "Apprendete le definizioni di RPO (Recovery Point Objective) e RTO (Recovery Time Objective) con esempi chiari. Scoprite come SafeKit raggiunge l'assenza di perdita di dati (RPO=0) e il failover rapido per garantire la continuità operativa 24 ore su 24, 7 giorni su 7."
category: "best-practises"
lang: "it"
topics: "Riepilogo rapido: RPO vs. RTO, Indice, Come si calcolano RPO e RTO per una soluzione di alta disponibilità e continuità operativa?, Come si determinano RPO e RTO per una soluzione di backup e ripristino di emergenza?, Come fa un cluster SafeKit Mirror a raggiungere RPO zero e RTO basso?, Quali sono i benchmark RTO per un cluster SafeKit Farm con bilanciamento del carico?, Tabelle comparative: RTO vs RPO, Alta disponibilità in azione: dimostrazioni in tempo reale di RPO zero e RTO quasi zero, FAQ: Ottimizzazione di RPO e RTO per la continuità operativa"
---
# Che cosa sono RPO e RTO? Definizioni, esempi e strategie di alta disponibilità {#what-are-rpo-and-rto-definitions-examples-and-ha-strategies}
## Riepilogo rapido: RPO vs. RTO {#article-summary}
* **RPO (Recovery Point Objective):** Misura **la perdita di dati** . Definisce l'età massima dei file che devono essere recuperati affinché le operazioni possano riprendere.
* **RTO (Recovery Time Objective):** Misura **i tempi di inattività** . Rappresenta la durata di tempo entro la quale un processo aziendale deve essere ripristinato.
* **La differenza fondamentale:** RPO riguarda **l'archiviazione/i backup** , mentre RTO riguarda **la velocità di ripristino/failover** .
* **SafeKit Capacità:** Offre **0 RPO** (nessuna perdita di dati) e **basso RTO** (riavvio rapido) tramite replica sincrona e failover automatico.

**RPO vs. RTO: Confronto tra perdita di dati e tempo di ripristino in SafeKit**
## Indice {#table-of-contents}
* [ Come si calcolano RPO e RTO per una soluzione di alta disponibilità e continuità operativa? ](#calculate-rpo-rto-high-availability)
* [ Come si determinano RPO e RTO per una soluzione di backup e ripristino di emergenza? ](#calculate-rpo-rto-backup-solution)
* [ Come fa un cluster SafeKit Mirror a raggiungere RPO zero e RTO basso? ](#rpo-rto-safekit-mirror-cluster)
* [ Quali sono i benchmark RTO per un cluster SafeKit Farm con bilanciamento del carico? ](#rpo-rto-safekit-farm-cluster)
* [ Tabelle comparative: RTO vs RPO ](#rpo-vs-rto-comparison)
* [ Alta disponibilità in azione: dimostrazioni in tempo reale di RPO zero e RTO quasi zero ](#safekit-rpo-rto-video-demos)
* [ Domande frequenti su RPO e RTO ](#faq-rpo-rto)
* [ SafeKit Hub di navigazione ad alta disponibilità ](#hub)
## Come si calcolano RPO e RTO per una soluzione di alta disponibilità e continuità operativa? {#calculate-rpo-rto-high-availability}
### Che cos'è l'alta disponibilità? {#what-is-high-availability}
**Alta disponibilità (HA)** è un'architettura tecnica progettata per garantire che un sistema rimanga operativo e accessibile per una percentuale di tempo specificata (ad esempio, 99,99%).

Per raggiungere gli obiettivi RPO e RTO definiti in un **piano di continuità operativa** , l'alta disponibilità viene in genere implementata attraverso due architetture principali:
* Sistema di dischi condivisi **su SAN:** Un cluster tradizionale in cui 2 nodi sono collegati a una Storage Area Network (SAN) centrale. Se un nodo si guasta, l'altro subentra nell'accesso ai dati condivisi.
* Replica sincrona senza SAN: **Una moderna architettura "shared-nothing" implementata dal software [ SafeKit ]( "SafeKit High Availability Software") ,** cui i dati vengono replicati in tempo reale tra dischi locali di 2 nodi indipendenti, eliminando la necessità di una SAN.
### Qual è l'RPO di una soluzione ad alta disponibilità? {#what-is-rpo-high-availability}
**L'RPO (Recovery Point Objective)** definisce il volume massimo di perdita di dati tollerabile, misurato nel tempo. Per una vera **soluzione ad alta disponibilità** , l'RPO target è **pari a zero** .
Quando si implementa un cluster ad alta disponibilità con failover automatico, un RPO pari a zero **e un RPO pari a zero** garantiscono il riavvio dell'applicazione senza perdita di dati.
* Sistema **dischi condivisi** su SAN: **Poiché entrambi i nodi accedono agli stessi blocchi di dati fisici** , non vi è alcun "delta" o ritardo tra i nodi, garantendo la totale coerenza dei dati durante un failover.
* **Replica sincrona basata su software:** Un approccio SANless in cui ogni operazione di "scrittura" viene replicata in tempo reale sulla rete. L'applicazione riceve una **conferma di scrittura** solo dopo che i dati sono stati archiviati in modo sicuro su entrambi i nodi. Questo processo sincrono di "doppia scrittura" garantisce **zero perdita di dati** anche in caso di guasto del server primario.
### Qual è l'RTO di una soluzione ad alta disponibilità? {#what-is-rto-high-availability}
**RTO (Recovery Time Objective)** rappresenta la durata massima tollerabile del tempo di inattività dopo un'interruzione del servizio. Nel contesto di **alta disponibilità** , l'RTO dovrebbe essere minimo per garantire l'accesso continuo alle applicazioni critiche.
Per ottenere un RTO basso, una soluzione ad alta disponibilità utilizza **il failover automatico** per rilevare guasti hardware o software e riavviare immediatamente l'applicazione. In un tipico cluster ad alta disponibilità, l' **RTO è di circa un minuto** , calcolato come:
* **Tempo di rilevamento del guasto:** L'intervallo necessario al sistema per identificare una perdita di heartbeat di un nodo o di un'applicazione.
* Tempo di riavvio automatico **:** Il tempo necessario per l'inizializzazione dei servizi dell'applicazione sul nodo rimanente.
## Come si determinano RPO e RTO per una soluzione di backup e ripristino di emergenza? {#calculate-rpo-rto-backup-solution}
### Che cos'è una soluzione di backup? {#what-is-backup}
Una **soluzione di backup** è una strategia di protezione dei dati progettata per creare copie periodiche dei dati su un dispositivo di archiviazione secondario o sul cloud. A differenza dell'alta disponibilità, il backup si concentra sulla **conservazione dei dati a lungo termine** e sul ripristino in caso di danneggiamento dei dati o disastri che interessano l'intero sito.
Per raggiungere gli obiettivi RPO e RTO definiti in un **piano di ripristino d'emergenza** , il backup viene in genere implementato tramite due metodi principali:
* **Snapshot programmati:** un processo in cui vengono create copie dei dati in un determinato momento a intervalli fissi (ad esempio, giornalieri). Questo definisce l' **RPO** , poiché tutti i dati modificati tra l'ultimo snapshot e il momento in cui si verifica l'errore andranno persi.
* **Ripristino remoto o in cloud:** un'architettura in cui i dati vengono archiviati in una posizione fisica separata. Sebbene ciò garantisca la sopravvivenza dei dati, comporta un **RTO (Recovery Time Objective) più elevato** poiché i dati devono essere trasferiti e ripristinati prima che l'applicazione possa essere riavviata.
### Qual è l'RPO di una soluzione di backup? {#what-is-rpo-backup}
In un contesto di backup **, l'RPO (Recovery Point Objective)** definisce l'età dei file che devono essere ripristinati dalla memoria di archiviazione affinché le normali operazioni possano riprendere. A differenza dell'alta disponibilità, una **soluzione di backup** prevede in genere un RPO diverso da zero, che rappresenta il tempo trascorso dall'ultimo backup completato con successo.
La quantità di dati persi in una strategia di backup è determinata dalla **frequenza di backup** . A seconda dell'architettura, questo RPO (Recovery Point Objective) può variare da pochi minuti a 24 ore:
* **Snapshot incrementali:** Un metodo in cui vengono salvati solo i blocchi di dati modificati a intervalli prestabiliti. Se viene eseguito un backup ogni 4 ore, l' **massimo è** 4 ore, il che significa che tutti i dati creati tra l'ultimo snapshot e il crash del sistema vengono persi definitivamente.
* **Backup completi giornalieri:** un approccio tradizionale in cui viene creata una copia completa dei dati una volta al giorno (di solito durante la notte). Ciò si traduce in un **RPO di 24 ore** , che può essere accettabile per i dati non critici ma è spesso insufficiente per i database transazionali.
### Qual è l'RTO di una soluzione di backup? {#what-is-rto-backup}
Il tempo di **(RTO - Recovery Time Objective)** in una strategia di backup rappresenta la durata del tempo necessario per ripristinare i dati da un supporto di backup e riportare l'applicazione a uno stato operativo. A differenza dell'alta disponibilità, il tempo di ripristino (RTO) **per il backup** è significativamente più lungo perché implica processi di ripristino manuali o tramite script.
Per una soluzione di backup, l'RTO (Recovery Time **può variare da diverse ore a giorni, a** del volume dei dati e dell'architettura di ripristino. Il tempo di inattività totale viene calcolato come segue:
* **Tempo di trasferimento dati:** Il tempo necessario per spostare i dati dall'archivio di backup (dischi locali, nastri o cloud) al server di produzione.
* Tempo di riconfigurazione del sistema **:** L'intervallo necessario per importare i dati nell'applicazione, ricostruire gli indici e verificare l'integrità dei dati prima che gli utenti possano accedere nuovamente.
## Come fa un cluster SafeKit Mirror a raggiungere RPO zero e RTO basso? {#rpo-rto-safekit-mirror-cluster}
### Che cos'è il cluster SafeKit Mirror ? {#what-is-safekit-mirror-cluster}
Il cluster **SafeKit Mirror** è una soluzione di alta disponibilità basata su software che implementa un'architettura "shared-nothing". A differenza dei cluster tradizionali che richiedono una SAN costosa, SafeKit utilizza le risorse locali di due server standard per creare un ambiente altamente resiliente.
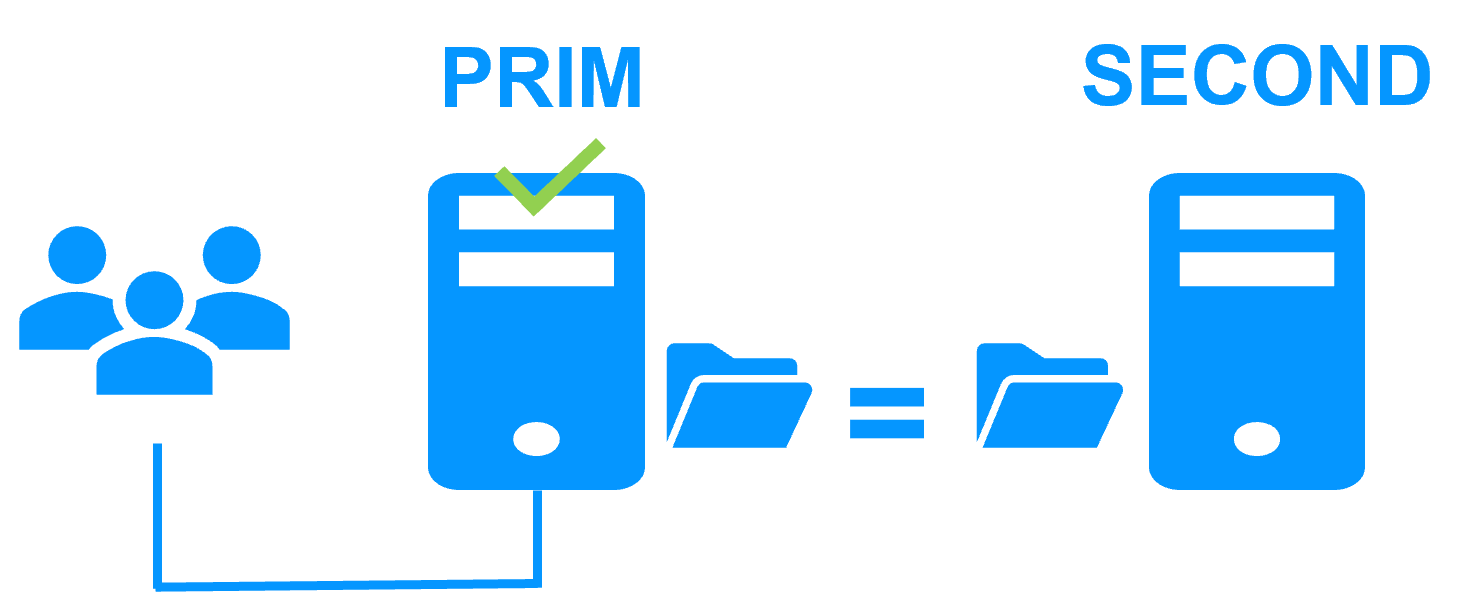
Per garantire la massima operatività e la protezione dei dati nell'ambito del vostro **Piano di Continuità Operativa** , il cluster SafeKit mirror opera tramite due meccanismi integrati:
* **Replica sincrona in tempo reale:** SafeKit replica i dati attraverso la rete tra i dischi locali dei nodi primario e secondario. Ciò garantisce che l'RPO sia pari a zero, poiché ogni byte di dati è protetto su entrambi i server prima che una transazione venga finalizzata.
* **Failover automatico di IP e applicazioni:** Se il nodo primario si guasta, SafeKit rileva automaticamente la perdita del heartbeat e ristabilisce l'applicazione e il suo indirizzo IP virtuale sul nodo secondario. Ciò si traduce in un RTO di circa un minuto, garantendo la continuità del servizio senza interruzioni.
### Qual è l'RPO di un cluster SafeKit Mirror ? {#rpo-safekit-example}
L'RPO **di un cluster SafeKit mirror è zero** perché la replica dei dati tra i nodi è [ sincrona e in tempo reale ]( "Synchronous vs Asynchronous Replication") .
Questa garanzia di assenza di perdita di dati viene ottenuta tramite un processo **di conferma di scrittura** : una scrittura su disco viene confermata all'applicazione solo dopo essere stata scritta correttamente sui dischi locali sia del nodo primario che di quello secondario.
Al contrario, con **la replica asincrona** , l'RPO è maggiore di zero. Poiché esiste un ritardo tra la scrittura primaria e l'aggiornamento secondario, un errore comporterà la perdita di dati durante il failover al server secondario. Per **la Business Continuity** mission-critical, la replica sincrona è l'unico modo per garantire che l'applicazione si riavvii con un'integrità dei dati del 100%.
### Qual è l'RTO di un cluster SafeKit Mirror ? {#what-is-rto-safekit}
In una configurazione standard, l' **RTO di un cluster SafeKit mirror è di circa un minuto** . SafeKit offre la flessibilità di implementare l'alta disponibilità a **livello di applicazione** o a **livello di macchina virtuale** , con un impatto diverso sul tempo di ripristino in entrambi i casi:
* **HA a livello di applicazione:** Questo è l'approccio SafeKit ottimizzato in cui il software monitora servizi applicativi specifici.
* Errore hardware **: RTO** = _timeout heartbeat_ (predefinito 30s) + _tempo di riavvio dell'applicazione_.
* Errore software **:** RTO = _tempo di arresto dell'applicazione_ + _tempo di riavvio dell'applicazione_.
* **Vantaggio chiave:** Poiché il sistema operativo è già in esecuzione sul nodo secondario, non vi è alcun ritardo di avvio del sistema operativo, con conseguente ripristino più rapido possibile per **Business Continuity** .
* **HA a livello di VM:** In questo scenario, SafeKit protegge l'intero ambiente della macchina virtuale.
* **Ripristino da errore:** RTO = _rilevamento errore_ \+ **Tempo di riavvio del sistema operativo** \+ _tempo di riavvio dell'applicazione_.
* **Compromesso tecnico:** L'RTO è naturalmente più lungo (diversi minuti) perché il nodo secondario deve eseguire un avvio a freddo completo del sistema operativo prima che l'applicazione possa anche solo iniziare l'inizializzazione.
Grazie all'utilizzo **dell'alta disponibilità a livello applicativo** , SafeKit elimina la "penalità di riavvio" tipica della virtualizzazione standard, garantendo che il **piano di continuità operativa** raggiunga il tempo di inattività più basso possibile.
## Quali sono i benchmark RTO per un cluster SafeKit Farm con bilanciamento del carico? {#rpo-rto-safekit-farm-cluster}
### Che cos'è il cluster SafeKit Farm ? {#what-is-safekit-farm-cluster}
Il **cluster SafeKit Farm** è una soluzione software ad alta disponibilità progettata per applicazioni stateless (come i server web) che richiedono sia **scalabilità** che **ridondanza** . A differenza di un cluster mirror , che si concentra sulla replica dei dati, un cluster farm distribuisce il traffico in entrata su più nodi attivi.
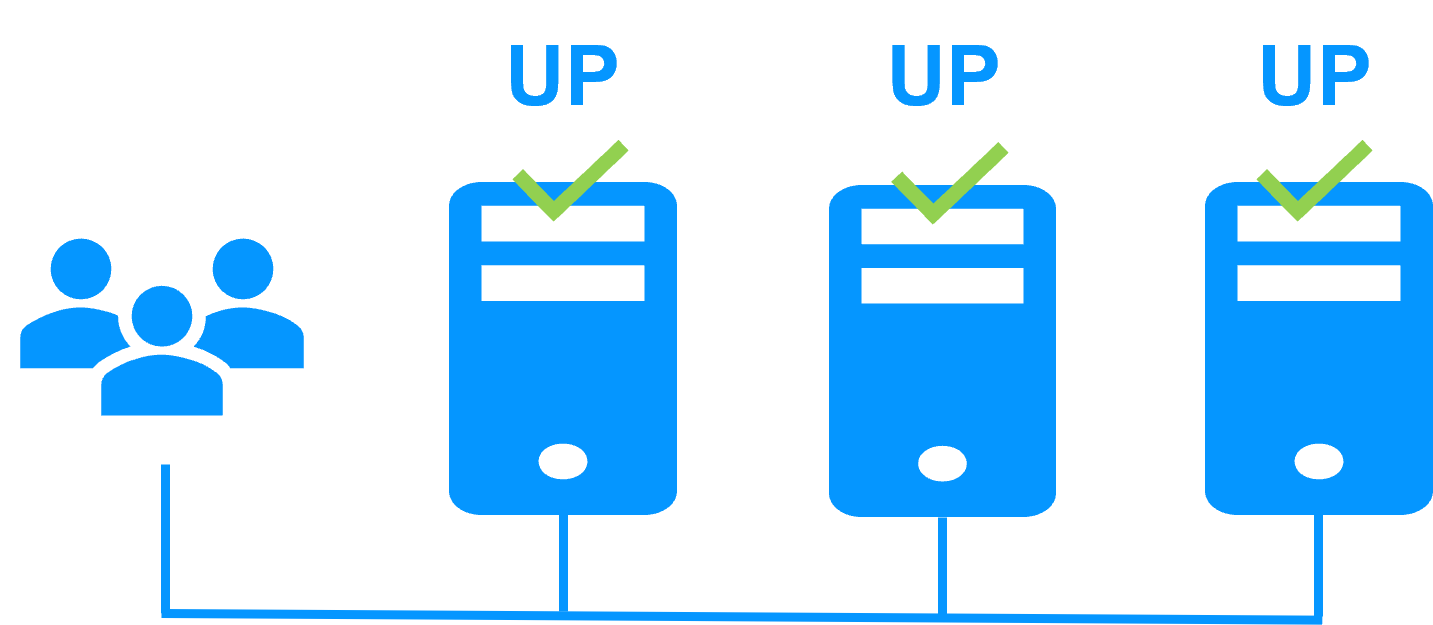
Per garantire **la continuità operativa** in ambienti ad alto traffico, il cluster SafeKit farm opera attraverso due meccanismi principali:
* Bilanciamento del carico di rete **:** SafeKit utilizza un indirizzo IP virtuale per distribuire il traffico di rete in entrata su un " farm " di più server attivi. Ciò garantisce che nessun singolo server venga sovraccaricato e massimizza le prestazioni dell'applicazione.
* **Rilevamento automatico dei guasti e riconfigurazione:** Se un nodo in farm si guasta, SafeKit rileva il guasto tramite heartbeat e ridistribuisce immediatamente il traffico tra i nodi rimanenti funzionanti. Ciò garantisce un RTO (Return to Operation) prossimo allo zero per l'intero servizio, poiché gli altri nodi sono già attivi e pronti ad assorbire il carico.
### Qual è l'RPO di un cluster SafeKit Farm ? {#what-is-rpo-safekit-farm}
L' **RPO (Recovery Point Objective)** per un **cluster SafeKit Farm** è generalmente considerato **non applicabile (N/A)** . Questo perché un cluster farm è specificamente progettato per **applicazioni stateless** in cui i dati non vengono memorizzati localmente sui nodi.
Poiché un cluster farm si concentra sul bilanciamento farm carico di rete **piuttosto che** sincronizzazione dei dati, non vi è replica dei dati tra i nodi all'interno del cluster stesso. In un tipico piano di continuità operativa **che coinvolge un'architettura** :
* Operazioni senza stato **:** Tutti i nodi in farm sono identici e non contengono dati persistenti; pertanto, non vi è alcuna "perdita di dati" da misurare durante un guasto di un nodo.
* **Archiviazione dati esterna:** Se l'applicazione richiede la persistenza dei dati, questa viene solitamente gestita da un backend separato **SafeKit Mirror Cluster** dove l'RPO sarebbe quindi zero.
### Qual è l'RTO di un cluster SafeKit Farm ? {#rto-example-safekit-farm-cluster}
In un'architettura farm , il RTO **si riduce a pochi secondi** perché tutti i nodi sono in genere attivi simultaneamente. Il tempo di ripristino è determinato dalla velocità con cui il cluster riconfigura la distribuzione del traffico:
* **Guasto hardware:** l'RTO è pari al _timeout di rilevamento del guasto_ su tutti i canali di monitoraggio (il valore predefinito è di pochi secondi). Una volta rilevata la perdita del battito cardiaco, i **filtri di bilanciamento del carico IP virtuale** vengono riconfigurati automaticamente per reindirizzare il traffico ai nodi rimanenti funzionanti.
* Errore software o riavvio pianificato **:** L'RTO viene calcolato come il _tempo di arresto dell'applicazione_ più il _tempo di riavvio dell'applicazione_ su quel nodo specifico, durante il quale gli altri nodi in farm continuano a gestire tutto il traffico in entrata.
Questo meccanismo "Active-Active" garantisce che, per i servizi stateless, l'impatto sulla **continuità operativa** sia pressoché impercettibile per l'utente finale, in quanto non è necessario inizializzare il servizio su un nuovo nodo di standby.
## Tabelle comparative: RTO vs RPO {#rpo-vs-rto-comparison}
Definizione semantica **: RTO vs. RPO**
Metrica | Acronimo | Definizione | Area di interesse
---|---|---|---
Obiettivo tempo di ripristino | RTO | Durata obiettivo del tempo per ripristinare un processo aziendale dopo un guasto. | Disponibilità / Tempo di inattività
Obiettivo del punto di ripristino | RPO | L'età massima dei file che devono essere ripristinati dal backup affinché le operazioni possano riprendere. | Perdita/integrità dei dati
**Alta disponibilità (HA) rispetto al backup standard**
Funzionalità | Soluzioni di backup | Alta disponibilità ( SafeKit )
---|---|---
Automazione del ripristino | Intervento manuale | Failover automatico
Tempo di ripristino target (RTO) | Ore in giorni | Secondi in circa 1 minuto
RPO di destinazione | > 0 (Ultimo punto di backup) | 0 (Replica sincrona)
Benchmark RTO e RPO **per i cluster SafeKit**
Architettura | Caso d'uso | RTO (Disponibilità) | RPO (Perdita di dati)
---|---|---|---
Cluster Mirror Replica in tempo reale | | ~1 min (Heartbeat + Riavvio) | 0 (Nessuna perdita di dati)
Cluster Farm Bilanciamento del carico di rete | | Alcuni secondi | N/D (Stateless)
## Alta disponibilità in azione: dimostrazioni in tempo reale di RPO zero e RTO quasi zero {#safekit-rpo-rto-video-demos}
### Video: Raggiungere RPO zero e RTO basso in un cluster SafeKit Mirror (8:47) {#demo-mirror-cluster-rpo-rto}
Scopri **SafeKit gestisce un errore critico. Questo video dimostra la replica sincrona** **garantisce l'assenza di perdita di dati (RPO 0) in un database SQL e il riavvio automatico** dei servizi sul nodo secondario (RTO basso).
#### Capitoli {#chapters}
1. 🎬 [ 2 nodi con SQL Server ]() (0:32)
2. 🎬 [ Configura il cluster e il modulo mirror.safe ]() (3:58)
3. 🎬 [ Avvia e testa la replica SQL, la migrazione, il failover in caso di arresto anomalo ]() (4:17)
[ Prova gratuita qui ]()
### Video: Raggiungere un RTO quasi nullo in un cluster SafeKit Farm (5:03) {#demo-farm-cluster-rpo-rto}
Guarda come SafeKit gestisce un server web Apache farm per fornire sia scalabilità delle prestazioni che failover istantaneo.
#### Capitoli {#chapters-1}
1. 🎬 [ 2 nodi con Apache ]() (0:13)
2. 🎬 [ Configura il cluster e il modulo farm.safe ]() (2:20)
3. 🎬 [ Avvia e testa il bilanciamento del carico di rete, failover in caso di arresto anomalo ]() (2:30)
[ Prova gratuita qui ]()
## FAQ: Ottimizzazione di RPO e RTO per la continuità operativa {#faq-rpo-rto}
### RPO e RTO possono essere pari a zero? {#can-rpo-rto-be-zero}
**Sì.** Raggiungere un **RPO zero** significa nessuna perdita di dati, possibile tramite mirroring sincrono dei dati. Un **RTO quasi zero** si ottiene tramite software di failover automatico come SafeKit , che rileva i guasti e riavvia le applicazioni su un nodo secondario in pochi secondi o minuti.
### Cosa è più importante: RPO o RTO? {#importance-rpo-vs-rto}
Nessuno dei due è intrinsecamente più importante; svolgono ruoli diversi. **RPO (Recovery Point Objective)** si concentra sulla perdita di dati, ovvero sulla quantità di dati che ci si può permettere di perdere. **RTO (Recovery Time Objective)** si concentra sul tempo di inattività, ovvero sulla rapidità con cui è necessario tornare online. Per le applicazioni mission-critical, entrambi devono essere ridotti al minimo.
### Qual è la differenza tra RPO e RTO tra SafeKit a livello di applicazione e a livello di macchina virtuale? {#safekit-application-vs-vm-level}
Sebbene entrambi garantiscano un RPO **di 0** tramite replica sincrona, differiscono nel tempo di ripristino:
* Livello applicazione **:** RTO più veloce (circa 1 min) perché solo i servizi dell'applicazione si riavviano su un sistema operativo già in esecuzione. Rileva anche arresti anomali specifici di software/processi.
* Livello VM **:** RTO più elevato perché l'intera macchina virtuale deve essere riavviata sull'host secondario. Pur essendo indipendente dall'applicazione, manca di un monitoraggio granulare dei processi dell'applicazione stessa.
### Qual è la differenza tra soluzioni HA e di backup in termini di RTO? {#ha-vs-backup-rto}
L'alta disponibilità (HA) offre in genere un RTO (Recovery Time Objective) molto più basso (da secondi a minuti) perché gestisce automaticamente i guasti locali. Il ripristino di emergenza con soluzioni di backup (DR) di solito ha un RTO più alto (da ore a giorni) perché prevede il ripristino di dati e servizi in un sito geograficamente distante dopo una grave catastrofe.
### Come posso ottenere i migliori valori di RPO e RTO tra siti remoti? {#rpo-rto-between-remote-sites}
Raggiungere un **zero RPO** E **RTO quasi zero** attraverso siti remoti richiede una combinazione di **replica sincrona** e un **LAN estesa (VLAN estesa)** :
* **LAN estesa / VLAN estesa:** Estendendo la stessa sottorete (Layer 2) su due data center, è possibile spostare un'applicazione dal Sito A al Sito B senza modificarne l'indirizzo IP, evitando complessi aggiornamenti DNS.
* **La soluzione SafeKit :** SafeKit sfrutta questo principio fornendo un **indirizzo IP virtuale (VIP) definito via software** che si sposta tra i siti. Reindirizza istantaneamente il traffico al sito secondario utilizzando il protocollo GARP (Gratuitous ARP).
Ciò garantisce un **RPO = 0** (mirroring in tempo reale) e un **RTO minimo** (failover in circa 1 minuto) senza intervento umano.
### Perché combinare Alta Disponibilità e Backup è essenziale per ottimizzare RPO e RTO? {#combining-ha-and-backup-for-rpo-rto}
Combinare l'alta disponibilità (HA) con una soluzione di backup è l'unico modo per ottenere una strategia di ripristino che offra il meglio di entrambi i mondi. Sebbene vengano spesso discusse insieme, risolvono aspetti diversi dell'equazione RPO/RTO:
* Alta disponibilità **(tramite SafeKit ):** Ottimizza per un RTO prossimo allo zero e un RPO pari a zero in caso di guasti hardware o software. Grazie alla replica sincrona in tempo reale, il server secondario è sempre aggiornato. In caso di guasto del server primario, il servizio si riavvia immediatamente sul server secondario senza perdita di dati.
* Soluzioni di backup **:** Protezione contro i problemi di integrità dei dati (come ransomware o cancellazione accidentale). Poiché l'alta disponibilità (HA) replica le modifiche istantaneamente, replicherà "fedelmente" un virus o un record di database eliminato sul server di standby. Un backup consente di "tornare indietro nel tempo" a un punto precedente al verificarsi del danneggiamento.
* **Approccio ibrido:** per la massima resilienza, le organizzazioni utilizzano **un'architettura ibrida a 3 nodi** . Questa include un cluster locale a 2 nodi con replica sincrona per l'alta disponibilità immediata e una terza copia remota (asincrona) per il ripristino di emergenza. Questa difesa a più livelli garantisce la presenza di una copia "attiva" per il ripristino immediato e di una copia "storica" per la sicurezza dei dati.