Gegevensreplicatietechnieken voor hoge beschikbaarheid: een volledige vergelijking
Gegevensreplicatie op database-, schijf- of bestandsniveau?
Overzicht
Dit artikel bespreekt de voor- en nadelen van gegevensreplicatie op database-, schijf- en bestandsniveau voor clusters met hoge beschikbaarheid. Daarbij kijken we naar failover, failback en implementatiegemak.
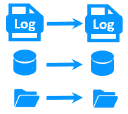
De volgende vergelijkingstabellen beschrijven de gegevensreplicatietechnieken van SafeKit, software voor hoge beschikbaarheid, in detail.
Wat houdt gegevensreplicatie op databaseniveau in?
Het databasebeheersysteem repliceert logbestanden tussen twee servers, zoals het SQL Server-transactielogboek.
Voor automatische failover is synchrone replicatie noodzakelijk. Anders zijn de laatst bevestigde transacties na een failover niet beschikbaar op de secundaire server.
Deze techniek repliceert een database, maar niet de overige applicatiegegevens. Voor failover van veel toepassingen moeten ook andere gegevens, zoals configuratiebestanden, worden gerepliceerd.
Als een server crasht en databasebestanden verliest, verloopt failback niet automatisch. Een ervaren DBA moet de database op de defecte server herstellen.
Wat houdt gegevensreplicatie op schijfniveau in?
Hierbij worden wijzigingen op schijven tussen twee servers gerepliceerd, bijvoorbeeld met DRBD.
Voor automatische failover zonder gegevensverlies is synchrone replicatie tussen de schijven noodzakelijk.
Deze techniek kan databases en andere bestanden repliceren, maar heeft veel invloed op de indeling van applicatiegegevens. Alle gegevens moeten op de gerepliceerde schijf staan. Dit kan onmogelijk zijn als te repliceren gegevens op de systeemschijf staan, omdat die schijf per server eigen moet blijven.
Er is specialistische kennis nodig om een gerepliceerde schijf met een bestandssysteem in te stellen en de applicatiegegevens daarop te plaatsen.
Wat houdt gegevensreplicatie op bestandsniveau in?
Hierbij worden bestandswijzigingen tussen twee servers gerepliceerd, bijvoorbeeld met SafeKit.
Voor automatische failover zonder gegevensverlies is synchrone replicatie in realtime nodig.
Deze techniek kan databases en andere bestanden repliceren zonder de indeling van applicatiegegevens te veranderen. Zelfs als een toepassing gegevens op de systeemschijf opslaat, werkt bestandsreplicatie in realtime.
De oplossing is eenvoudig te configureren: alleen de paden van de te repliceren mappen hoeven te worden opgegeven.
Vergelijkingstabellen van gegevensreplicatietechnieken
De juiste aanpak voor gegevensreplicatie kiezen is essentieel voor het waarborgen van bedrijfscontinuïteit. Deze vergelijking belicht de belangrijkste onderscheidende kenmerken van SafeKit’s mirror cluster met realtime bestandsreplicatie ten opzichte van traditionele alternatieven zoals replicatie op databaseniveau, schijfreplicatie, gedeelde schijfoplossingen en fouttolerante systemen.
SafeKit mirror cluster: voordelen ten opzichte van alternatieve replicatie- en clusterbenaderingen
| Kenmerk | SafeKit-voordeel | Beperking van alternatieven |
|---|---|---|
| 3 producten in 1 | Bespaart op Windows en Linux de kosten van externe gedeelde/gerepliceerde opslag, load balancing-apparatuur en enterprise-edities van besturingssystemen en databases. Bevat alle clusterfuncties: synchrone realtime bestandsreplicatie, storingsbewaking, automatische herstart, virtuele IP-failover. | Traditionele benaderingen vereisen afzonderlijke producten voor opslagreplicatie, load balancing en clustering — wat de kosten en complexiteit verhoogt. |
| Zeer eenvoudige configuratie | Configuratie via applicatiemodules. Nieuwe services en gerepliceerde mappen kunnen eenvoudig worden toegevoegd. Alles beheerd via een gecentraliseerde webconsole. Geen domeincontroller of Active Directory vereist. | Microsoft cluster en vergelijkbare oplossingen vereisen complexe Active Directory-configuratie en domeincontrollers. |
| Synchrone replicatie | Realtime replicatie is synchroon zonder gegevensverlies bij een storing (RPO = 0). | Asynchrone replicatie kan recente transacties verliezen die op het moment van de storing nog niet waren gerepliceerd. |
| Volledig geautomatiseerde failback | Na een storing, wanneer een server opnieuw opstart, is de replicatie-failback volledig automatisch. De uitgevallen server wordt opnieuw in het cluster opgenomen zonder de applicatie op de resterende server te stoppen. | De meeste replicatieoplossingen (vooral op databaseniveau) vereisen handmatige hersynchronisatie. De applicatie kan zelfs worden gestopt tijdens de failback. |
| Replicatie van elk type gegevens | Replicatie werkt voor databases en voor alle bestanden die gerepliceerd moeten worden. | Replicatie op databaseniveau beschermt alleen de database, niet de configuratiebestanden, logboeken of andere applicatiegegevens. |
| Bestandsreplicatie vs. schijfreplicatie | Replicatie is gebaseerd op bestandsmappen die overal kunnen worden geplaatst, zelfs op de systeemschijf. | Schijfreplicatie vereist een speciale schijfpartitie en speciale applicatieconfiguratie om gegevens daar op te slaan. |
| Bestandsreplicatie vs. gedeelde schijf | Servers kunnen op twee externe locaties worden ingezet zonder gedeelde infrastructuur. | Gedeelde schijfoplossingen vereisen fysieke nabijheid en kunnen geen externe locaties overspannen. |
| Externe locaties en virtueel IP | Alle clusterfuncties werken voor 2 servers op externe locaties. Extended LAN maakt laag-2 VIP-omleiding mogelijk. Voor verschillende IP-netwerken wordt VIP beheerd via een load balancer met SafeKit health check. | Veel clusteroplossingen ondersteunen geen failover naar externe locaties of vereisen complexe DNS-omleiding met onvoorspelbare hersteltijden. |
| Quorum en split brain | Werkt met slechts 2 servers. Een eenvoudige split brain-checker naar een router handelt netwerkisolatie tussen locaties af. | De meeste clusteroplossingen vereisen een 3e server voor quorumbeheer. |
| Actief/actief cluster | De secundaire server is niet toegewijd. Het cluster kan actief/actief draaien met 2 verschillende mirror-modules. | Fouttolerante systemen wijzen de secundaire server toe aan het uitvoeren van dezelfde applicatie, gesynchroniseerd op instructieniveau. |
| Uniforme HA-oplossing | SafeKit implementeert zowel mirror cluster (replicatie + failover) als farm cluster (load balancing + failover). Een N-tier architectuur kan met één oplossing op Windows en Linux hoogbeschikbaar worden gemaakt. | Typische architecturen mengen verschillende technologieën voor load balancing, replicatie en failover — wat de operationele complexiteit verhoogt. |
| RTO / RPO | Snelle herstart van de applicatie bij een storing: ongeveer 1 minuut of minder. Geen gegevensverlies (synchrone replicatie). | Volledige VM-replicatie (VMware HA, Hyper-V cluster) vereist het herstarten van het volledige besturingssysteem op een nieuwe hypervisor, wat leidt tot langere hersteltijden. |
Samengevat biedt SafeKit’s mirror cluster een uniforme, kosteneffectieve oplossing voor hoge beschikbaarheid die synchrone bestandsreplicatie, automatische failover en failback, load balancing en ondersteuning voor externe locaties combineert — allemaal zonder speciale hardware, gedeelde opslag of een derde quorumserver. Deze eenvoud maakt het bijzonder geschikt voor software-editors en organisaties die betrouwbare HA nodig hebben op standaard Windows- en Linux-servers.
🔍 SafeKit High Availability Navigatiehub
Ontdek SafeKit: Functies, technische video’s, documentatie en gratis proefversie
| Type bron | Beschrijving | Directe link |
|---|---|---|
| Belangrijkste kenmerken | Waarom kiezen voor SafeKit voor eenvoudige en kosteneffectieve High Availability? | Bekijk waarom kiezen voor SafeKit voor High Availability |
| Use Cases | Ontdek hoe SafeKit de hoge beschikbaarheid van kritieke infrastructuur waarborgt | Bekijk alle gebruiksscenario’s (OEM-software, Edge-servers, SCADA en meer) |
| Implementatiemodel | All-in-One SANless HA: Shared-Nothing Software Clustering | Bekijk SafeKit All-in-One SANless HA |
| HA-strategieën | SafeKit: Infrastructuur (VM) vs. High Availability op applicatieniveau | Bekijk SafeKit HA & Redundantie: VM vs. Applicatieniveau |
| Technische specificaties | Technische beperkingen voor SafeKit Clustering | Bekijk SafeKit High Availability beperkingen |
| Video’s | SafeKit: High Availability configuratie & failover demo’s | Bekijk SafeKit failover-tutorials |
| Architectuur | Hoe de SafeKit Mirror Cluster werkt (Realtime Replicatie & Failover) | Bekijk SafeKit Mirror Cluster: Realtime Replicatie & Failover |
| Architectuur | Hoe de SafeKit Farm Cluster werkt (Network Load Balancing & Failover) | Bekijk SafeKit Farm Cluster: Network Load Balancing & Failover |
| Concurrentievoordelen | Vergelijking: SafeKit vs. Traditionele High Availability (HA) Clusters | Bekijk de vergelijking tussen SafeKit en traditionele HA-clusters |
| Technische bronnen | SafeKit High Availability: Documentatie, downloads & proefversie | Bekijk de gratis SafeKit HA-proefversie & technische documentatie |
| Voorgeconfigureerde oplossingen | SafeKit Applicatiemodule-bibliotheek: Gebruiksklare HA-oplossingen | Bekijk SafeKit High Availability applicatiemodules |
