Synchrone versus asynchrone replicatie: hoe SafeKit zorgt voor nul gegevensverlies?
Gegevensverlies of niet bij failover van applicaties met synchrone of asynchrone replicatie?
Er is een aanzienlijk verschil tussen synchrone replicatie en asynchrone replicatie. Afhankelijk van de keuze kan er sprake zijn van gegevensverlies tijdens een failover van een applicatie.
- Synchrone replicatie, zoals geïmplementeerd door de SafeKit-software, is essentieel voor Hoge beschikbaarheid (HA). Het zorgt voor de failover van transactionele applicaties zonder ook maar één byte te verliezen: alle vastgelegde gegevens op de schijf van de primaire server zijn ook aanwezig op de schijf van de secundaire server.
- Asynchrone replicatie wordt doorgaans gebruikt voor Back-up en noodherstel (DR). Er bestaat een risico dat vastgelegde gegevens op de schijf van de primaire server verloren kunnen gaan in het geval van een storing, omdat deze nog niet naar de externe site zijn gekopieerd.
- Semisynchrone replicatie is een alternatieve oplossing waarbij vastgelegde gegevens de secundaire server bereiken, maar niet noodzakelijkerwijs naar de schijf worden geschreven.
Het is belangrijk om te begrijpen dat deze oplossingen complementair zijn. Terwijl de synchrone replicatie van SafeKit uw omgeving beschermt tegen hardware- of softwarefouten om 24/7 uptime te behouden, beveiligt een back-upoplossing uw historische gegevens tegen logische fouten en cyberbedreigingen zoals ransomware.
Om u te helpen de juiste beslissing te nemen bij het kiezen van de beste architectuur voor uw behoeften, leggen we hieronder de technische mechanismen en de impact op de failover van applicaties uit.
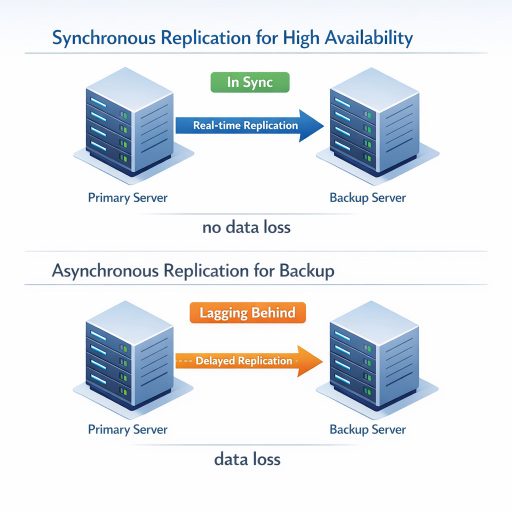
Vergelijking van de impact van synchrone en asynchrone replicatie op gegevensverlies tijdens failover van applicaties.
Inhoudsopgave
- Gegevensverlies of niet bij failover van applicatie met synchrone of asynchrone replicatie?
- Hoe asynchrone replicatie werkt?
- Hoe synchrone replicatie werkt?
- Hoe semi-synchrone replicatie werkt?
- Eindoordeel: de juiste replicatie kiezen voor hoge beschikbaarheid
- Vergelijkingstabel: synchroon versus asynchroon versus semi-synchronisch
- Videogids: Synchrone real-time replicatie en hoge beschikbaarheid configureren
- Veelgestelde vragen: replicatiestrategieën in clusters met hoge beschikbaarheid
- SafeKit Navigatiehub met hoge beschikbaarheid
Hoe asynchrone replicatie werkt?
Bij asynchrone replicatie bevestigt de primaire server schrijfbewerkingen onmiddellijk, waardoor replica’s later in geplande batches met vertraging worden bijgewerkt. Deze ontkoppeling overwint de latentieproblemen van replicatie over lange afstand , waardoor het een voorkeursstrategie wordt voor back-ups en noodherstel op externe locaties.
Deze efficiëntie introduceert echter de uitdaging van consistentie , waarbij de secundaire server verouderde informatie kan bevatten. Omdat de secundaire update plaatsvindt nadat het primaire schrijven is voltooid, zal elke storing van de primaire server resulteren in het verlies van in-flight gegevens.
Hoe synchrone replicatie werkt?
Met synchrone replicatie zoals geïmplementeerd door SafeKit, wanneer een schijf-I/O-bewerking wordt uitgevoerd door de applicatie of de cache van het bestandssysteem op de primaire server, zorgt het systeem voor gegevensconsistentie via een proces met dubbele bevestiging.
SafeKit wacht op de I/O-bevestiging van zowel de lokale schijf als de secundaire server voordat hij de definitieve bevestiging terugstuurt naar de applicatie of de cache van het bestandssysteem. Dit synchrone mechanisme is essentieel voor de failover van transactionele applicaties en zorgt ervoor dat transacties op beide knooppunten volledig beveiligd zijn voordat ze als vastgelegd worden beschouwd.
Hoe semi-synchrone replicatie werkt?
Semisynchrone replicatie dient als een hybride benadering van gegevensintegriteit. Net als bij synchrone replicatie wacht SafeKit op een bevestiging van zowel de primaire als de secundaire server voordat de I/O-bewerking naar de applicatie- of bestandssysteemcache wordt bevestigd.
Het cruciale verschil ligt in de responstijd van de secundaire server. In het semi-synchrone geval stuurt de secundaire server onmiddellijk na ontvangst van de gegevens in het geheugen een bevestiging naar de primaire server, waarna deze op schijf wordt vastgelegd. Bij synchrone replicatie moet de secundaire server daarentegen de I/O naar de fysieke schijf schrijven voordat de bevestiging wordt verzonden.
Eindoordeel: de juiste replicatie kiezen voor hoge beschikbaarheid
De keuze tussen synchrone versus asynchrone replicatie is een afweging tussen absolute gegevensintegriteit en netwerkprestaties. Voor bedrijfskritische infrastructuren bepaalt deze beslissing rechtstreeks uw Recovery Point Objective (RPO).
Samengevat:
- Asynchrone replicatie: de gouden standaard voor back-up, maar niet voor hoge beschikbaarheid. Hoewel het connectiviteit over lange afstanden ondersteunt, bestaat er een inherent risico op gegevensverlies omdat de gegevens van het secundaire knooppunt achterblijven bij de gegevens van het primaire knooppunt.
- Synchrone replicatie: De gouden standaard voor hoge beschikbaarheid maar niet voor back-up. Het zorgt ervoor dat de secundaire knooppuntbestanden een realtime kloon zijn van de primaire, wat garandeert dat failover zonder gegevensverlies.
- Semi-synchrone replicatie: Biedt een hoogwaardige middenweg voor hoge beschikbaarheid. Door gegevens op geheugenniveau te bevestigen vóór het schrijven naar de schijf, wordt de latentie geminimaliseerd, terwijl de superieure gegevensbescherming behouden blijft in vergelijking met asynchrone methoden.
⭐ SafeKit Aanbeveling: Geef voor kritieke applicaties altijd prioriteit aan synchrone of semi-synchrone replicatie om de bedrijfscontinuïteit te garanderen, de prestaties te maximaliseren en de risico’s te elimineren die gepaard gaan met inconsistente failover.
Vergelijkingstabel: synchroon versus asynchroon versus semi-synchronisch
| Functie | Synchronisch | Semi-synchronisch | Asynchroon |
|---|---|---|---|
| RPO (potentieel gegevensverlies) | Nul | Nul | Niet nul (gegevensverlies: hangt af van de laatste asynchrone kopie) |
| Externe I/O-bevestiging | Na schrijven op afstand | Na extern RAM-schrijven | Wacht niet op bevestiging |
| Prestatie-impact | Vereist een netwerk met lage latentie - Afhankelijk van de retourtijd (doorgaans RTT <5 ms) | Vereist een netwerk met lage latentie - Afhankelijk van de retourtijd (doorgaans RTT <5 ms) | Ondersteunt een netwerk met lage latentie |
| Afstandslimieten | Lokaal/uitgerekt VLAN | Lokaal/uitgerekt VLAN | Wide Area Netwerk (WAN) |
| Beste voor | Hoge beschikbaarheid (automatische failover) | Hoge beschikbaarheid (automatische failover) | Back-upoplossingen (handmatige failover) |
Videogids: Synchrone realtime replicatie en hoge beschikbaarheid configureren
SafeKit-video: Clustering op applicatieniveau (8:47)
Ontdek in deze video hoe SafeKit een mirror HA-cluster implementeert zonder de complexiteit van een SAN. Hoewel deze demonstratie Microsoft SQL Server gebruikt, werkt de oplossing op dezelfde manier voor andere databases en applicaties.
Hoofdstukken
- 🎬 2 knooppunten met SQL Server (0:32)
- 🎬 Configureer het cluster en de mirror.safe-module (3:58)
- 🎬 Start en test SQL-replicatie, migratie en failover bij crash (4:17)
Stapsgewijze implementatie
- 🛠️ Lees de handleiding over het instellen van een gespiegeld cluster op Windows
- 🛠️ Lees de handleiding over het instellen van een gespiegeld cluster op Linux
Veelgestelde vragen: replicatiestrategieën in clusters met hoge beschikbaarheid
Replicatietechnologie en mechanica
Verzendt SafeKit het volledige bestand over het netwerk telkens wanneer het wordt gewijzigd?
Nee. SafeKit maakt gebruik van replicatie op byteniveau. Het onderschept specifieke I/O-wijzigingen in bestanden en repliceert alleen de gewijzigde bytes, waardoor het netwerkverkeer wordt geminimaliseerd.
Wordt de replicatie geactiveerd telkens wanneer de toepassing naar de bestanden schrijft?
Nee. Replicatie vindt alleen plaats wanneer de toepassing een I/O-commit naar de lokale schijf aanvraagt. SafeKit zorgt ervoor dat deze gegevens worden bevestigd door de secundaire server voordat het schrijven wordt voltooid.
Vertraagt synchrone replicatie mijn applicatie?
De latentie is gekoppeld aan de Network Round Trip Time (RTT). Op een LAN is de impact verwaarloosbaar (vergelijkbaar met NAS/SAN-opslag). Op WAN’s met hoge latentie wordt vaak de voorkeur gegeven aan asynchrone modi om prestatieknelpunten te voorkomen en is een back-upoplossing (niet SafeKit) vereist.
Implementatiestrategie: HA versus back-up
Wanneer moet ik kiezen voor synchrone versus asynchrone replicatie?
Kies Synchroon voor Hoge beschikbaarheid (automatische failover, geen gegevensverlies). Kies Asynchroon voor Back-up/DR waarbij de afstand real-time synchronisatie verhindert en automatische failover niet vereist is.
Ondersteunt SafeKit asynchrone replicatie?
Nee. SafeKit is een HA-oplossing die geen gegevensverlies vereist voor automatische failover. Voor puur asynchrone behoeften zoekt u naar Backup-oplossingen.
Maakt High Availability een back-upoplossing overbodig?
Nee, hoge beschikbaarheid neemt de behoefte aan een uitgebreide back-upoplossing niet weg.
Hoewel realtime replicatieoplossingen zoals SafeKit continue bedrijfscontinuïteit bieden, dienen ze een ander doel dan back-ups. Real-time replicatie is ontworpen om bescherming te bieden tegen hardwarestoringen en serveruitval, maar biedt geen bescherming tegen cyberdreigingen zoals ransomware die beide knooppunten tegelijkertijd versleutelt. Alleen een back-upoplossing met een bewaarbeleid kan dit probleem oplossen.
Hoe kan ik synchrone en asynchrone replicatie combineren?
U kunt een hybride architectuur met drie knooppunten gebruiken: een lokaal cluster met twee knooppunten met synchrone replicatie voor HA, en een derde externe kopie via een back-upoplossing met asynchrone replicatie voor noodherstel.
Zie voor meer informatie: SafeKit Hoge beschikbaarheid en noodherstel (HADR)
🔍 SafeKit High Availability Navigatiehub
Ontdek SafeKit: Functies, technische video’s, documentatie en gratis proefversie
| Type bron | Beschrijving | Directe link |
|---|---|---|
| Belangrijkste kenmerken | Waarom kiezen voor SafeKit voor eenvoudige en kosteneffectieve High Availability? | Bekijk waarom kiezen voor SafeKit voor High Availability |
| Use Cases | Ontdek hoe SafeKit de hoge beschikbaarheid van kritieke infrastructuur waarborgt | Bekijk alle gebruiksscenario’s (OEM-software, Edge-servers, SCADA en meer) |
| Implementatiemodel | All-in-One SANless HA: Shared-Nothing Software Clustering | Bekijk SafeKit All-in-One SANless HA |
| HA-strategieën | SafeKit: Infrastructuur (VM) vs. High Availability op applicatieniveau | Bekijk SafeKit HA & Redundantie: VM vs. Applicatieniveau |
| Technische specificaties | Technische beperkingen voor SafeKit Clustering | Bekijk SafeKit High Availability beperkingen |
| Video’s | SafeKit: High Availability configuratie & failover demo’s | Bekijk SafeKit failover-tutorials |
| Architectuur | Hoe de SafeKit Mirror Cluster werkt (Realtime Replicatie & Failover) | Bekijk SafeKit Mirror Cluster: Realtime Replicatie & Failover |
| Architectuur | Hoe de SafeKit Farm Cluster werkt (Network Load Balancing & Failover) | Bekijk SafeKit Farm Cluster: Network Load Balancing & Failover |
| Concurrentievoordelen | Vergelijking: SafeKit vs. Traditionele High Availability (HA) Clusters | Bekijk de vergelijking tussen SafeKit en traditionele HA-clusters |
| Technische bronnen | SafeKit High Availability: Documentatie, downloads & proefversie | Bekijk de gratis SafeKit HA-proefversie & technische documentatie |
| Voorgeconfigureerde oplossingen | SafeKit Applicatiemodule-bibliotheek: Gebruiksklare HA-oplossingen | Bekijk SafeKit High Availability applicatiemodules |
