Wat zijn RPO en RTO? Definities, voorbeelden en HA-strategieën
Korte samenvatting: RPO versus RTO
- RPO (Recovery Point Objective): Meet gegevensverlies . Het definieert de maximale leeftijd van bestanden die moeten worden hersteld voordat de werking kan worden hervat.
- RTO (Recovery Time Objective): Meet downtime . Het is de tijdsduur waarbinnen een bedrijfsproces moet worden hersteld.
- Het belangrijkste verschil: RPO gaat over opslag/backups , terwijl RTO gaat over herstel-/failoversnelheid .
- SafeKit Mogelijkheid: Levert 0 RPO (geen gegevensverlies) en lage RTO (snelle herstart) door middel van synchrone replicatie en automatische failover.
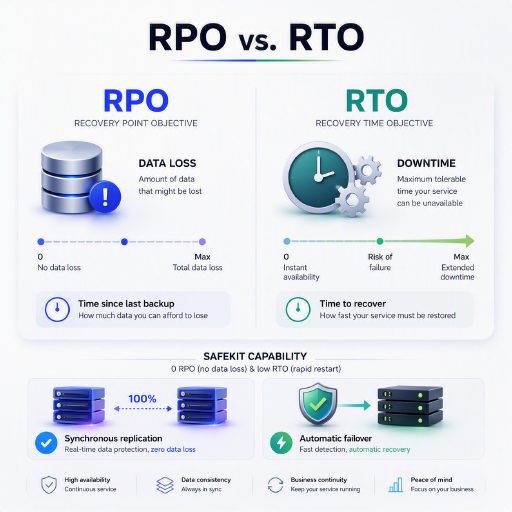
RPO versus RTO: Vergelijking van gegevensverlies en hersteltijd in SafeKit
Inhoudsopgave
- Hoe bereken ik RPO en RTO voor een oplossing voor hoge beschikbaarheid en bedrijfscontinuïteit?
- Hoe bepaal ik de RPO en RTO voor een back-up- en noodhersteloplossing?
- Hoe bereikt een SafeKit Mirror cluster een RPO van nul en een lage RTO?
- Wat zijn de RTO-benchmarks voor een SafeKit Farm -cluster met load balancing?
- Vergelijkingstabellen: RTO versus RPO
- Hoge beschikbaarheid in actie: realtime demonstraties van RPO van nul en RTO van bijna nul
- Veelgestelde vragen over RPO en RTO
- SafeKit Navigatiehub met hoge beschikbaarheid
Hoe bereken ik RPO en RTO voor een oplossing voor hoge beschikbaarheid en bedrijfscontinuïteit?
Wat is hoge beschikbaarheid?
Hoge beschikbaarheid (HA) is een technische architectuur die is ontworpen om ervoor te zorgen dat een systeem gedurende een bepaald percentage van de tijd (bijvoorbeeld 99,99%) operationeel en toegankelijk blijft.
Om de RPO- en RTO-doelstellingen van een bedrijfscontinuïteitsplan te behalen, wordt hoge beschikbaarheid doorgaans geïmplementeerd via twee primaire architecturen:
- Gedeeld schijfsysteem via een SAN: Een traditioneel cluster waarbij 2 knooppunten zijn verbonden met een centraal Storage Area Network (SAN). Als één knooppunt uitvalt, neemt het andere knooppunt de toegang tot de gedeelde gegevens over.
- SANloze synchrone replicatie: Een moderne “shared-nothing”-architectuur – geïmplementeerd door SafeKit software – waarbij gegevens in realtime worden gerepliceerd tussen lokale schijven van 2 onafhankelijke knooppunten, waardoor een SAN overbodig wordt.
Wat is de RPO van een oplossing met hoge beschikbaarheid?
RPO (Recovery Point Objective) definieert het maximaal toelaatbare volume aan gegevensverlies, gemeten in tijd. Voor een echte high availability-oplossing is de doel-RPO nul .
Bij het implementeren van een high availability-cluster met automatische failover zorgt een zero RPO ervoor dat de applicatie opnieuw opstart zonder gegevensverlies.
- Gedeeld schijfsysteem via een SAN: Omdat beide knooppunten toegang hebben tot exact dezelfde fysieke datablokken , is er geen “verschil” of vertraging tussen de knooppunten, waardoor volledige dataconsistentie tijdens een failover gegarandeerd is.
- Softwarematige synchrone replicatie: Een SAN-loze aanpak waarbij elke “schrijf”-bewerking in realtime over het netwerk wordt gespiegeld. De applicatie ontvangt pas een schrijfbevestiging zodra de gegevens veilig op beide knooppunten zijn opgeslagen. Dit synchrone “dubbele schrijf”-proces garandeert geen gegevensverlies zelfs als de primaire server uitvalt.
Wat is de RTO van een oplossing met hoge beschikbaarheid?
RTO (Recovery Time Objective) vertegenwoordigt de maximaal toelaatbare duur van downtime na een serviceonderbreking. In de context van hoge beschikbaarheid moet de RTO minimaal zijn om continue toegang tot kritieke applicaties te garanderen.
Om een lage RTO te bereiken, maakt een oplossing met hoge beschikbaarheid gebruik van… automatische failover om hardware- of softwarefouten te detecteren en de applicatie onmiddellijk opnieuw op te starten. In een typisch high availability-cluster is dit het geval. De RTO duurt ongeveer één minuut. , berekend als:
- Storingsdetectietijd: Het interval dat het systeem nodig heeft om een verlies van de heartbeat van een knooppunt of applicatie te detecteren.
- Automatische herstarttijd: De tijd die nodig is voor de applicatieservices om te initialiseren op het overgebleven knooppunt.
Hoe bepaal ik de RPO en RTO voor een back-up- en disaster recovery-oplossing?
Wat is een back-upoplossing?
Een -back-upoplossing is een strategie voor gegevensbescherming die is ontworpen om periodieke kopieën van gegevens te maken naar een secundair opslagapparaat of de cloud. In tegenstelling tot hoge beschikbaarheid richt back-up zich op langdurige gegevensretentie en herstel bij gegevenscorruptie of rampen die de hele organisatie treffen.
Om te voldoen aan de RPO- en RTO-doelstellingen die zijn vastgelegd in een Disaster Recovery Plan , wordt back-up doorgaans op twee manieren uitgevoerd:
- Geplande momentopnamen: een proces waarbij momentopnamen van gegevens op vaste intervallen (bijvoorbeeld dagelijks) worden gemaakt. Dit bepaalt de RPO (Recovery Point Objective), aangezien alle gegevens die tussen de laatste momentopname en de storing zijn gewijzigd, verloren gaan.
- Offsite of cloudherstel: een architectuur waarbij gegevens op een aparte fysieke locatie worden opgeslagen. Hoewel dit de continuïteit van de gegevens waarborgt, resulteert het in een hogere RTO (Recovery Time Objective) omdat de gegevens moeten worden overgedragen en hersteld voordat de applicatie opnieuw kan worden opgestart.
Wat is de RPO van een back-upoplossing?
In een back-upcontext definieert RPO (Recovery Point Objective) de leeftijd van de bestanden die moeten worden hersteld vanuit de opslag om de normale werking te hervatten. In tegenstelling tot hoge beschikbaarheid heeft een back-upoplossing meestal een RPO die niet nul is, en die de tijd aangeeft die is verstreken sinds de laatste succesvolle back-up is voltooid.
De mate van gegevensverlies bij een back-upstrategie wordt bepaald door de back-upfrequentie . Afhankelijk van de architectuur kan deze RPO (Recovery Point Objective) variëren van enkele minuten tot 24 uur.
- Incrementele snapshots: Een methode waarbij alleen gewijzigde datablokken met vaste intervallen worden opgeslagen. Als er elke 4 uur een back-up wordt gemaakt, is de maximale RPO (Recovery Point Objective) 4 uur , wat betekent dat alle gegevens die tussen de laatste snapshot en de systeemcrash zijn aangemaakt, permanent verloren gaan.
- Dagelijkse volledige back-ups: Een traditionele aanpak waarbij eenmaal per dag (meestal ’s nachts) een volledige kopie van de gegevens wordt gemaakt. Dit resulteert in een RPO van 24 uur , wat acceptabel kan zijn voor niet-kritieke gegevens, maar vaak onvoldoende is voor transactionele databases.
Wat is de RTO van een back-upoplossing?
De RTO (Recovery Time Objective) in een back-upstrategie is de tijdsduur die nodig is om gegevens van een back-upmedium te herstellen en de applicatie weer operationeel te maken. In tegenstelling tot hoge beschikbaarheid is de RTO voor back-ups aanzienlijk langer, omdat het handmatige of geautomatiseerde herstelprocessen omvat.
Voor een back-upoplossing kan de (Recovery Time Objective) variëren van enkele uren tot dagen, van de hoeveelheid gegevens en de herstelarchitectuur. De totale downtime wordt als volgt berekend:
- Gegevensoverdrachtstijd: De tijd die nodig is om gegevens van de back-upopslag (lokale schijven, tapes of cloud) terug naar de productieserver te verplaatsen.
- Systeemherconfiguratietijd: Het interval dat nodig is om de gegevens in de applicatie te laden, indexen opnieuw op te bouwen en de gegevensintegriteit te controleren voordat gebruikers weer kunnen inloggen.
Hoe bereikt een SafeKit Mirror cluster een RPO van nul en een lage RTO?
Wat is de SafeKit Mirror cluster?
Het SafeKit Mirror Cluster is een softwarematige oplossing voor hoge beschikbaarheid die een “shared-nothing”-architectuur implementeert. In tegenstelling tot traditionele clusters die een dure SAN vereisen, gebruikt SafeKit de lokale resources van twee standaardservers om een zeer veerkrachtige omgeving te creëren.
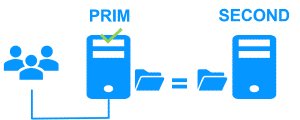
Om maximale beschikbaarheid en gegevensbescherming te garanderen binnen uw Business Continuity Plan , werkt het SafeKit mirror cluster via twee geïntegreerde mechanismen:
- Real-Time Synchronous Replication: SafeKit spiegelt gegevens over het netwerk tussen de lokale schijven van de primaire en secundaire knooppunten. Dit zorgt ervoor dat de RPO nul is, omdat elke byte aan gegevens op beide servers wordt beveiligd voordat een transactie wordt voltooid.
- Automatische IP- en applicatiefailover: Als het primaire knooppunt uitvalt, detecteert SafeKit automatisch het verlies van de heartbeat en herstelt de applicatie en het virtuele IP-adres op het secundaire knooppunt. Dit resulteert in een RTO van ongeveer één minuut, waardoor een naadloze servicecontinuïteit wordt gewaarborgd.
Wat is de RPO van een SafeKit Mirror cluster?
mirror van een SafeKit is omdat de datareplicatie tussen knooppunten en is.
Deze garantie van nul gegevensverlies wordt bereikt via een schrijfbevestigingsproces ): een schijfschrijfbewerking wordt pas aan de applicatie bevestigd nadat deze succesvol naar de lokale schijven van zowel het primaire als het secundaire knooppunt is geschreven.
Bij asynchrone replicatie is de RPO (Recovery Point Objective) daarentegen groter dan nul. Omdat er een vertraging is tussen de primaire schrijfbewerking en de secundaire update, zal een storing leiden tot gegevensverlies tijdens de failover naar de secundaire server. Voor bedrijfskritische bedrijfscontinuïteit is synchrone replicatie de enige manier om te garanderen dat de applicatie opnieuw opstart met 100% gegevensintegriteit.
Wat is de RTO van een SafeKit Mirror cluster?
In een standaardconfiguratie is de RTO (Recovery Time Objective) van een SafeKit mirror -cluster ongeveer één minuut . SafeKit biedt de flexibiliteit om hoge beschikbaarheid te implementeren op applicatieniveau of op VM-niveau , waarbij elk niveau een andere invloed heeft op de hersteltijd:
- HA op applicatieniveau: Dit is de geoptimaliseerde SafeKit aanpak waarbij de software specifieke applicatieservices bewaakt.
- Hardwarefout: RTO = heartbeat-time-out (standaard 30s) + herstarttijd van de applicatie.
- Softwarefout: RTO = tijdstip van applicatiestop + tijdstip van applicatieherstart.
- Belangrijkste voordeel: Omdat het besturingssysteem al op het secundaire knooppunt draait, is er geen opstartvertraging van het besturingssysteem, wat resulteert in het snelst mogelijke herstel voor Bedrijfscontinuïteit .
- HA op VM-niveau: In dit scenario beschermt SafeKit de volledige virtuele machineomgeving.
- Herstel na fout: RTO = foutdetectie + Herstarttijd besturingssysteem + tijd voor herstart van applicatie.
- Technische afweging: De RTO is vanzelfsprekend langer (enkele minuten) omdat het secundaire knooppunt een volledige koude herstart van het besturingssysteem moet uitvoeren voordat de applicatie kan beginnen met initialiseren.
Door gebruik te maken van hoge beschikbaarheid op applicatieniveau, en SafeKit wordt de “herstartvertraging” die inherent is aan standaard virtualisatie geëlimineerd, waardoor uw bedrijfscontinuïteitsplan de laagst mogelijke downtime bereikt.
Wat zijn de RTO-benchmarks voor een SafeKit Farm cluster met load balancing?
Wat is de SafeKit Farm cluster?
Het SafeKit Farm Cluster is een softwarematige oplossing voor hoge beschikbaarheid, ontworpen voor stateless applicaties (zoals webservers) die zowel schaalbaarheid als redundantie vereisen. In tegenstelling tot een mirror cluster, dat zich richt op datareplicatie, verdeelt een farm cluster het inkomende verkeer over meerdere actieve knooppunten.
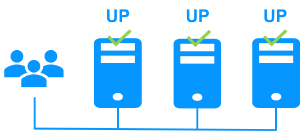
Om de bedrijfscontinuïteit in omgevingen met veel verkeer te waarborgen, werkt het SafeKit farm -cluster via twee kernmechanismen:
- Netwerkbelastingverdeling : SafeKit gebruikt een virtueel IP-adres om inkomend netwerkverkeer te verdelen over een " farm " van meerdere actieve servers. Dit zorgt ervoor dat geen enkele server overbelast raakt en maximaliseert de prestaties van de applicatie.
- Automatische foutdetectie en herconfiguratie: Als een knooppunt in de farm uitvalt, detecteert SafeKit de storing via heartbeats en herverdeelt het verkeer onmiddellijk over de resterende, gezonde knooppunten. Dit zorgt voor een bijna nul RTO (Recovery Time Objective) voor de gehele service, omdat andere knooppunten al actief zijn en klaar staan om de belasting op te vangen.
Wat is de RPO van een SafeKit Farm cluster?
De RPO (Recovery Point Objective) voor een SafeKit Farm cluster wordt over het algemeen als niet van toepassing (N/A) beschouwd. Dit komt omdat een farm -cluster specifiek is ontworpen voor stateless applicaties waarbij data niet lokaal op de nodes wordt opgeslagen.
Omdat een farm cluster zich richt op -netwerkbelastingverdeling in plaats van gegevenssynchronisatie, vindt er geen gegevensreplicatie plaats tussen de knooppunten binnen het cluster zelf. In een typisch bedrijfscontinuïteitsplan met een farm -architectuur:
- Stateless Operations: Alle knooppunten in de farm zijn identiek en bevatten geen permanente gegevens; daarom is er geen sprake van “gegevensverlies” tijdens een knooppuntstoring.
- Externe gegevensopslag: Als de applicatie gegevenspersistentie vereist, wordt dit meestal afgehandeld door een aparte backend SafeKit Mirror Cluster waar de RPO dan nul zou zijn.
Wat is de RTO van een SafeKit Farm cluster?
In een farm -architectuur wordt de RTO teruggebracht tot slechts enkele seconden omdat alle knooppunten doorgaans gelijktijdig actief zijn. De hersteltijd wordt bepaald door de snelheid waarmee het cluster de verkeersverdeling opnieuw configureert.
- Hardwarefout: De RTO is gelijk aan de time-out voor foutdetectie over alle monitoringkanalen (standaard enkele seconden). Zodra het verlies van de heartbeat wordt gedetecteerd, worden de virtuele IP-loadbalancingfilters automatisch opnieuw geconfigureerd om het verkeer om te leiden naar de resterende, gezonde knooppunten.
- Softwarefout of geplande herstart: De RTO wordt berekend als de tijd dat de applicatie stopt plus de tijd dat de applicatie opnieuw opstart op dat specifieke knooppunt, gedurende welke de andere knooppunten in de farm alle inkomende verkeer blijven verwerken.
Dit “Active-Active”-mechanisme zorgt ervoor dat voor stateless services de impact van Business Continuity vrijwel onmerkbaar is voor de eindgebruiker, omdat het niet nodig is de service op een nieuw standby-knooppunt te initialiseren.
Vergelijkingstabellen: RTO versus RPO
Semantische definitie: RTO versus RPO
| Metriek | Acroniem | Definitie | Focusgebied |
|---|---|---|---|
| Hersteltijddoelstelling | RTO | De beoogde tijdsduur om een bedrijfsproces te herstellen na een storing. | Beschikbaarheid / Uitvaltijd |
| Recovery Point Objective (RPO) | RPO | De maximale leeftijd van bestanden die vanuit een back-up moeten worden hersteld voordat de werkzaamheden kunnen worden hervat. | Gegevensverlies / Integriteit |
Hoge beschikbaarheid (HA) versus standaard back-up
| Functie | Back-upoplossingen | Hoge beschikbaarheid ( SafeKit ) |
|---|---|---|
| Herstelautomatisering | Handmatige interventie | Automatische failover |
| Doel-RTO | Uren tot dagen | Seconden tot ~1 minuut |
| Doel-RPO | > 0 (laatste back-uppunt) | 0 (synchrone replicatie) |
RTO- en RPO-benchmarks voor SafeKit -clusters
| Architectuur | Gebruiksscenario | RTO (Beschikbaarheid) | RPO (Gegevensverlies) |
|---|---|---|---|
| Mirror Cluster | Realtime replicatie | ~1 min (Heartbeat + Herstart) | 0 (Geen gegevensverlies) |
| Farm Cluster | Netwerktaakverdeling | Enkele seconden | N.v.t. (Stateless) |
Hoge beschikbaarheid in actie: realtime demonstraties van nul RPO en bijna nul RTO
Video: Het bereiken van nul RPO en een lage RTO in een SafeKit Mirror cluster (8:47)
Bekijk hoe SafeKit omgaat met een kritieke storing. Deze video demonstreert synchrone replicatie die ervoor zorgt dat er geen gegevens verloren gaan (RPO 0) in een SQL-database en de automatische herstart van services op het secundaire knooppunt (lage RTO).
Hoofdstukken
- 🎬 2 knooppunten met SQL Server (0:32)
- 🎬 Configureer het cluster en de mirror.safe module (3:58)
- 🎬 Start en test SQL-replicatie, migratie, failover bij crash (4:17)
Video: Het bereiken van een bijna nul RTO in een SafeKit Farm cluster (5:03)
Bekijk hoe SafeKit een Apache-webserver farm beheert om zowel prestatieschaalbaarheid als directe failover te bieden.
Hoofdstukken
- 🎬 2 knooppunten met Apache (0:13)
- 🎬 Configureer het cluster en de farm.safe module (2:20)
- 🎬 Start en test netwerkbelastingverdeling, failover bij crash (2:30)
Veelgestelde vragen: RPO en RTO optimaliseren voor bedrijfscontinuïteit
Kunnen RPO en RTO nul zijn?
Ja. Het behalen van een RPO van nul betekent geen gegevensverlies, wat mogelijk is door synchrone dataspiegeling. Een RTO van bijna nul wordt bereikt door geautomatiseerde failover-software zoals SafeKit , die storingen detecteert en applicaties binnen enkele seconden of minuten op een secundaire node herstart.
Wat is belangrijker: RPO of RTO?
Geen van beide is inherent belangrijker; ze vervullen verschillende rollen. RPO (Recovery Point Objective) richt zich op dataverlies – hoeveel data u zich kunt veroorloven te verliezen. RTO (Recovery Time Objective) richt zich op downtime – hoe snel u weer online moet zijn. Voor bedrijfskritische applicaties moeten beide tot een minimum worden beperkt.
Wat is het verschil in RPO en RTO tussen SafeKit op applicatieniveau en op VM-niveau?
Hoewel beide methoden een RPO van 0 garanderen via synchrone replicatie, verschillen ze in hersteltijd:
- Applicatieniveau: Snellere RTO (ongeveer 1 minuut) omdat alleen applicatieservices opnieuw worden opgestart op een reeds draaiend besturingssysteem. Het detecteert ook specifieke software-/procescrashes.
- VM-niveau: Hogere RTO omdat de volledige virtuele machine opnieuw moet opstarten op de secundaire host. Hoewel applicatie-onafhankelijk, ontbreekt gedetailleerde monitoring van de applicatieprocessen zelf.
Wat is het verschil tussen HA- en back-upoplossingen qua RTO?
Hoge beschikbaarheid (HA) biedt doorgaans een veel lagere RTO (seconden tot minuten) omdat lokale storingen automatisch worden afgehandeld. Rampenherstel met back-upoplossingen (DR) heeft meestal een hogere RTO (uren tot dagen) omdat het gaat om het herstellen van gegevens en services op een geografisch verafgelegen locatie na een grote ramp.
Hoe bereik ik de beste RPO en RTO tussen externe locaties?
Om een RPO van nul en een RTO van bijna nul te bereiken op verschillende externe locaties, is een combinatie van synchrone replicatie en een uitgebreid LAN (Stretched VLAN) vereist:
- Uitgebreid LAN / Uitgerekte VLAN: Door hetzelfde subnet (Layer 2) over twee datacenters uit te rekken, kunt u een applicatie van locatie A naar locatie B verplaatsen zonder het IP-adres te wijzigen, waardoor complexe DNS-updates worden vermeden.
- De SafeKit -oplossing: SafeKit maakt hier gebruik van door een softwarematig gedefinieerd virtueel IP-adres (VIP) te bieden dat tussen locaties wisselt. Het leidt verkeer direct om naar de secundaire locatie met behulp van Gratuitous ARP (GARP).
Dit levert een RPO van 0 (realtime mirroring) en een minimale RTO (failover in circa 1 minuut) op zonder menselijke tussenkomst.
Waarom is de combinatie van hoge beschikbaarheid en back-up essentieel voor het optimaliseren van RPO en RTO?
Het combineren van hoge beschikbaarheid (HA) met een back-upoplossing is de enige manier om een herstelstrategie te realiseren die het beste van beide werelden biedt. Hoewel ze vaak samen worden besproken, lossen ze verschillende onderdelen van de RPO/RTO-vergelijking op:
- Hoge beschikbaarheid (via SafeKit ): optimaliseert voor een bijna nul RTO en nul RPO bij hardware- of softwarefouten. Door gebruik te maken van realtime synchrone replicatie is de secundaire server altijd up-to-date. Als de primaire server uitvalt, wordt de service onmiddellijk op de secundaire server hervat zonder gegevensverlies.
- Back-upoplossingen: Beschermt tegen problemen met de gegevensintegriteit (zoals ransomware of per ongeluk verwijderen). Omdat HA wijzigingen direct repliceert, zal het een virus of een verwijderd databasebestand “betrouwbaar” repliceren naar de standbyserver. Een back-up stelt u in staat om “terug te gaan in de tijd” naar een punt voordat de corruptie plaatsvond.
- De hybride aanpak: voor maximale veerkracht gebruiken organisaties een hybride architectuur met drie knooppunten . Deze bestaat uit een lokaal cluster met twee knooppunten en synchrone replicatie voor directe hoge beschikbaarheid (HA), en een derde, externe kopie (asynchroon) voor noodherstel. Deze gelaagde beveiliging zorgt ervoor dat u een “live” kopie hebt voor direct herstel en een “historische” kopie voor gegevensbeveiliging.
🔍 Ontdek SafeKit
Vind informatie over de functies, architecturen, video’s, documentatie en de gratis proefversie van SafeKit.
| Hulpbron | Beschrijving | Link |
|---|---|---|
| Belangrijkste kenmerken | Ontdek waarom SafeKit een eenvoudige en kosteneffectieve oplossing voor hoge beschikbaarheid is. | Ontdek de belangrijkste kenmerken |
| Gebruiksscenario’s | Ontdek hoe SafeKit kritieke applicaties en infrastructuur beschikbaar houdt. | Ontdek de gebruiksscenario’s |
| Implementatiemodel | SafeKit biedt hoge beschikbaarheid zonder SAN of gedeelde opslag. | Het implementatiemodel verkennen |
| Strategieën voor hoge beschikbaarheid | Vergelijk hoge beschikbaarheid voor virtuele machines met hoge beschikbaarheid voor toepassingen. | Vergelijk de twee strategieën |
| Technische specificaties | Controleer de technische vereisten en beperkingen voor SafeKit-clusters. | Lees de technische specificaties |
| Video’s | Bekijk demonstraties van de SafeKit-configuratie en automatische failover. | Bekijk de technische video’s |
| Architectuur | Ontdek hoe het SafeKit mirror-cluster bestanden in realtime repliceert en failover afhandelt. | Verken de Mirror -architectuur |
| Architectuur | Ontdek hoe het SafeKit farm-cluster het netwerkverkeer in evenwicht brengt en failover afhandelt. | Verken de architectuur Farm |
| Productvergelijking | Vergelijk SafeKit met traditionele high-availability-clusters. | Vergelijk de oplossingen |
| Technische hulpmiddelen | Vind technische documentatie, download SafeKit en krijg toegang tot de gratis proefversie. | Krijg toegang tot de documentatie en de gratis proefversie |
| Applicatiemodules | Gebruik vooraf geconfigureerde SafeKit-modules om hoge beschikbaarheid voor uw applicaties in te stellen. | Verken de applicatiemodules |
