O que são RPO e RTO? Definições, exemplos e estratégias de HA
Resumo rápido: RPO vs. RTO
- RPO (objetivo de ponto de recuperação): Mede perda de dados. Ele define a idade máxima dos arquivos que devem ser recuperados para que as operações sejam retomadas.
- RTO (objetivo de tempo de recuperação): Mede tempo de inatividade. É o período de tempo dentro do qual um processo de negócios deve ser restaurado.
- A principal diferença: RPO trata de armazenamento/backups , enquanto RTO trata de velocidade de recuperação/failover.
- Capacidade SafeKit: oferece 0 RPO (sem perda de dados) e baixo RTO (reinicialização rápida) por meio de replicação síncrona e failover automático.
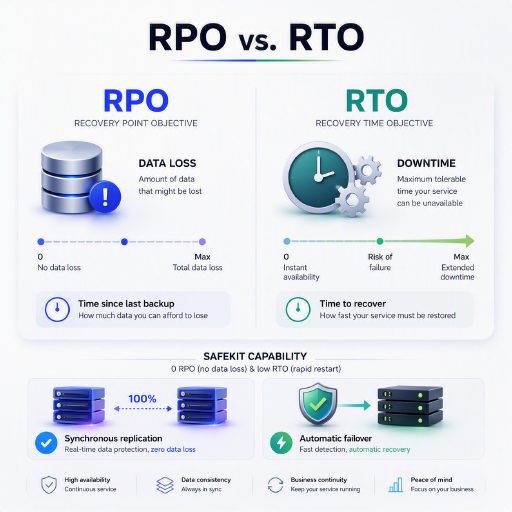
RPO vs. RTO: Comparando perda de dados e tempo de recuperação em SafeKit
Índice
- Como calculo o RPO e o RTO para uma solução de alta disponibilidade e continuidade de negócios?
- Como determino o RPO e o RTO para uma solução de backup e recuperação de desastres?
- Como um cluster de espelho SafeKit atinge zero RPO e baixo RTO?
- Quais são os benchmarks de RTO para um cluster de farm SafeKit com balanceamento de carga?
- Tabelas de comparação: RTO vs RPO
- Alta disponibilidade em ação: demonstrações em tempo real de zero RPO e quase zero RTO
- Perguntas frequentes sobre RPO e RTO
- SafeKit Hub de navegação de alta disponibilidade
Como calculo o RPO e o RTO para uma solução de alta disponibilidade e continuidade de negócios?
O que é alta disponibilidade?
Alta disponibilidade (HA) é uma arquitetura técnica projetada para garantir que um sistema permaneça operacional e acessível por um determinado percentual de tempo (por exemplo, 99,99%).
Para atingir as metas de RPO e RTO definidas em um Plano de Continuidade de Negócios , a alta disponibilidade normalmente é implementada por meio de duas arquiteturas principais:
- Sistema de disco compartilhado em uma SAN: um cluster tradicional onde dois nós estão conectados a uma rede de área de armazenamento (SAN) central. Se um nó falhar, o outro assumirá o acesso aos dados compartilhados.
- Replicação síncrona sem SAN: Uma arquitetura moderna “nada compartilhada” — implementada pelo software SafeKit — onde os dados são replicados em tempo real entre discos locais de 2 nós independentes, eliminando a necessidade de uma SAN.
Qual é o RPO de uma solução de alta disponibilidade?
RPO (Recovery Point Objective) define o volume máximo tolerável de perda de dados medido no tempo. Para uma verdadeira solução de alta disponibilidade , o RPO alvo é zero.
Ao implementar um cluster de alta disponibilidade com failover automático, um RPO zero garante que o aplicativo seja reiniciado sem perda de dados.
- Sistema de disco compartilhado em uma SAN: Como ambos os nós acessam exatamente os mesmos blocos físicos de dados , não há “delta” ou atraso entre os nós, garantindo consistência total dos dados durante um failover.
- Replicação síncrona baseada em software: Uma abordagem sem SAN em que cada operação de “gravação” é espelhada em tempo real na rede. O aplicativo só recebe uma reconhecimento de gravação quando os dados são armazenados com segurança em ambos os nós. Esse processo síncrono de “gravação dupla” garante zero perda de dados mesmo se o servidor primário falhar.
Qual é o RTO de uma solução de alta disponibilidade?
RTO (Recovery Time Objective) representa a duração máxima tolerável do tempo de inatividade após uma interrupção do serviço. No contexto de alta disponibilidade , o RTO deve ser mínimo para garantir acesso contínuo a aplicações críticas.
Para atingir um RTO baixo, uma solução de alta disponibilidade utiliza failover automático para detectar falhas de hardware ou software e reiniciar o aplicativo imediatamente. Em um cluster típico de alta disponibilidade, o RTO é de aproximadamente um minuto , calculado como:
- Tempo de detecção de falha: O intervalo necessário para o sistema identificar uma perda de pulsação de nó ou aplicativo.
- Tempo de reinicialização automática: O tempo necessário para que os serviços do aplicativo sejam inicializados no nó sobrevivente.
Como determino o RPO e o RTO para uma solução de backup e recuperação de desastres?
O que é uma solução de backup?
Uma Solução de Backup é uma estratégia de proteção de dados projetada para criar cópias periódicas de dados para um dispositivo de armazenamento secundário ou para a nuvem. Ao contrário da alta disponibilidade, o backup se concentra na retenção de dados de longo prazo e na recuperação de corrupção de dados ou desastres em todo o site.
Para atender às metas de RPO e RTO definidas em um Plano de recuperação de desastres , o backup normalmente é implementado por meio de dois métodos principais:
- Snapshots agendados: um processo em que cópias pontuais dos dados são feitas em intervalos fixos (por exemplo, diariamente). Isso define o RPO , pois todos os dados modificados entre o último instantâneo e a falha são perdidos.
- Recuperação externa ou na nuvem: Uma arquitetura onde os dados são armazenados em um local físico separado. Embora isso garanta a sobrevivência dos dados, resulta em um RTO mais alto porque os dados devem ser transferidos e restaurados antes que o aplicativo possa ser reiniciado.
Qual é o RPO de uma solução de backup?
RPO (Recovery Point Objective) em um contexto de backup define a idade dos arquivos que devem ser recuperados do armazenamento para que as operações normais sejam retomadas. Ao contrário da alta disponibilidade, uma solução de backup geralmente envolve um RPO diferente de zero, representando o tempo decorrido desde que o último backup foi concluído com êxito.
A quantidade de perda de dados em uma estratégia de backup é determinada pela frequência de backup. Dependendo da arquitetura, esse RPO pode variar de minutos a 24 horas:
- Instantâneos Incrementais: Um método em que apenas blocos de dados alterados são salvos em intervalos definidos. Se um backup for feito a cada 4 horas, o RPO máximo será de 4 horas , o que significa que todos os dados criados entre o último snapshot e a falha do sistema serão perdidos permanentemente.
- Backups diários completos: Uma abordagem tradicional em que uma cópia completa dos dados é feita uma vez por dia (geralmente durante a noite). Isso resulta em um RPO de 24 horas , que pode ser aceitável para dados não críticos, mas geralmente é insuficiente para bancos de dados transacionais.
Qual é o RTO de uma solução de backup?
RTO (Recovery Time Objective) em uma estratégia de backup é o tempo necessário para restaurar dados de uma mídia de backup e retornar o aplicativo a um estado operacional. Ao contrário da alta disponibilidade, o RTO para backup é significativamente mais longo porque envolve processos de restauração manuais ou com script.
Para uma solução de backup, o RTO pode variar de várias horas a dias , dependendo do volume de dados e da arquitetura de recuperação. O tempo de inatividade total é calculado como:
- Tempo de transferência de dados: O tempo necessário para mover dados do armazenamento de backup (discos locais, fitas ou nuvem) de volta ao servidor de produção.
- Tempo de reconfiguração do sistema: O intervalo necessário para extrair os dados para o aplicativo, reconstruir índices e verificar a integridade dos dados antes que os usuários possam fazer login novamente.
Como um cluster de espelho SafeKit atinge zero RPO e baixo RTO?
O que é o cluster de espelho SafeKit?
O SafeKit Mirror Cluster é uma solução de alta disponibilidade baseada em software que implementa uma arquitetura “nada compartilhada”. Ao contrário dos clusters tradicionais que exigem uma SAN cara, o SafeKit usa os recursos locais de dois servidores padrão para criar um ambiente altamente resiliente.
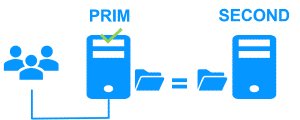
Para garantir o máximo tempo de atividade e proteção de dados dentro do seu Plano de Continuidade de Negócios, o cluster de espelhos SafeKit opera por meio de dois mecanismos integrados:
- Replicação síncrona em tempo real: SafeKit espelha dados na rede entre os discos locais dos nós primários e secundários. Isso garante que o RPO seja zero, pois cada byte de dados é protegido em ambos os servidores antes que uma transação seja finalizada.
- Failover automático de IP e aplicativo: Se o nó primário falhar, o SafeKit detecta automaticamente a perda de pulsação e restabelece o aplicativo e seu endereço IP virtual no nó secundário. Isso resulta em um RTO de aproximadamente um minuto, proporcionando continuidade de serviço contínua.
Qual é o RPO de um cluster de espelho SafeKit?
O RPO de um cluster de espelho SafeKit é zero porque a replicação de dados entre nós é síncrona e em tempo real.
Essa garantia de perda zero de dados é obtida por meio de um processo de reconhecimento de gravação: uma gravação em disco só é confirmada no aplicativo depois de ter sido gravada com êxito nos discos locais dos nós primário e secundário.
Por outro lado, com asynchronous replication , o RPO é maior que zero. Como há um atraso entre a gravação primária e a atualização secundária, uma falha resultará na perda de dados durante o failover para o servidor secundário. Para Business Continuity de missão crítica, a replicação síncrona é a única maneira de garantir que o aplicativo seja reiniciado com 100% de integridade dos dados.
Qual é o RTO de um cluster de espelho SafeKit?
Em uma configuração padrão, o RTO de um cluster de espelhos SafeKit é de aproximadamente um minuto. SafeKit oferece a flexibilidade para implementar alta disponibilidade no nível de aplicação ou no nível de VM , cada um impactando o tempo de recuperação de maneira diferente:
- HA em nível de aplicativo: Esta é a abordagem SafeKit otimizada em que o software monitora serviços de aplicativos específicos.
- Falha de hardware: RTO = tempo limite de pulsação (padrão 30s) + tempo de reinicialização do aplicativo.
- Falha de software: RTO = tempo de parada do aplicativo + tempo de reinicialização do aplicativo.
- Principal benefício: Como o sistema operacional já está em execução no nó secundário, não há atraso na inicialização do sistema operacional, resultando na recuperação mais rápida possível para Continuidade de negócios.
- HA em nível de VM: Neste cenário, SafeKit protege todo o ambiente da máquina virtual.
- Recuperação de falhas: RTO = detecção de falhas + Tempo de reinicialização do sistema operacional + tempo de reinicialização do aplicativo.
- Compensação técnica: O RTO é naturalmente mais longo (vários minutos) porque o nó secundário deve executar uma inicialização a frio completa do sistema operacional antes mesmo que o aplicativo possa começar a inicializar.
Ao utilizar alta disponibilidade em nível de aplicativo, o SafeKit elimina a “penalidade de reinicialização” inerente à virtualização padrão, garantindo que seu Plano de Continuidade de Negócios atinja o menor tempo de inatividade possível.
Quais são os benchmarks de RTO para um cluster de farm SafeKit com balanceamento de carga?
O que é o Cluster Agrícola SafeKit?
O SafeKit Farm Cluster é uma solução de alta disponibilidade baseada em software projetada para aplicativos sem estado (como servidores Web) que exigem escalabilidade e redundância. Ao contrário de um cluster espelho que se concentra na replicação de dados, um cluster farm distribui o tráfego de entrada entre vários nós ativos.
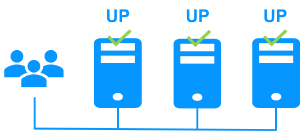
Para manter a Continuidade de Negócios em ambientes de alto tráfego, o cluster farm SafeKit opera por meio de dois mecanismos principais:
- Balanceamento de carga de rede: SafeKit usa um endereço IP virtual para distribuir o tráfego de rede de entrada em um “farm” de vários servidores ativos. Isso garante que nenhum servidor fique sobrecarregado e maximiza o desempenho do aplicativo.
- Detecção e reconfiguração automática de falhas: Se um nó do farm falhar, o SafeKit detecta a falha por meio de pulsações e redistribui imediatamente seu tráfego entre os nós íntegros restantes. Isto proporciona um RTO próximo de zero para o serviço geral, pois outros nós já estão ativos e prontos para absorver a carga.
Qual é o RPO de um cluster de farm SafeKit?
O RPO (objetivo de ponto de recuperação) para um SafeKit Farm Cluster é geralmente considerado Não aplicável (N/A). Isso ocorre porque um cluster de farm é projetado especificamente para aplicativos sem estado onde os dados não são armazenados localmente nos nós.
Como um cluster farm se concentra no balanceamento de carga de rede em vez da sincronização de dados, não há replicação de dados entre os nós dentro do próprio cluster. Em um Plano de Continuidade de Negócios típico envolvendo uma arquitetura de farm:
- Operações sem estado: todos os nós do farm são idênticos e não contêm dados persistentes; portanto, não há “perda de dados” a ser medida durante uma falha de nó.
- Armazenamento de dados externo: Se o aplicativo exigir persistência de dados, ele geralmente será tratado por um back-end separado SafeKit Mirror Cluster onde o RPO seria então zero.
Qual é o RTO de um cluster de farm SafeKit?
Em uma arquitetura de farm, o RTO é reduzido para apenas alguns segundos porque todos os nós normalmente estão ativos simultaneamente. O tempo de recuperação é determinado pela velocidade com que o cluster reconfigura sua distribuição de tráfego:
- Falha de hardware: O RTO é igual ao tempo limite de detecção de falha nos canais de monitoramento (o padrão é alguns segundos). Assim que a perda de pulsação for detectada, os filtros de balanceamento de carga de IP virtual serão automaticamente reconfigurados para redirecionar o tráfego para os nós íntegros restantes.
- Falha de software ou reinicialização planejada: O RTO é calculado como o tempo de parada do aplicativo mais o tempo de reinicialização do aplicativo nesse nó específico, durante o qual os outros nós do farm continuam a lidar com todo o tráfego de entrada.
Esse mecanismo “Ativo-Ativo” garante que, para serviços sem estado, o impacto da Continuidade de Negócios seja quase imperceptível para o usuário final, já que não há necessidade de inicializar o serviço em um novo nó em espera.
Tabelas de comparação: RTO vs RPO
Definição Semântica: RTO vs. RPO
| Métrica | Sigla | Definição | Área de foco |
|---|---|---|---|
| Objetivo de tempo de recuperação | RTO | A duração prevista para restaurar um processo de negócios após uma falha. | Disponibilidade/tempo de inatividade |
| Objetivo do ponto de recuperação | RPO | A idade máxima dos arquivos que devem ser recuperados do backup para que as operações sejam retomadas. | Perda/Integridade de Dados |
Alta disponibilidade (HA) versus backup padrão
| Recurso | Soluções de backup | Alta disponibilidade (SafeKit) |
|---|---|---|
| Automação de recuperação | Intervenção Manual | Failover automático |
| RTO alvo | Horas em Dias | Segundos a ~1 minuto |
| RPO alvo | > 0 (Último ponto de backup) | 0 (replicação síncrona) |
Benchmarks de RTO e RPO para clusters SafeKit
| Arquitetura | Caso de uso | RTO (disponibilidade) | RPO (perda de dados) |
|---|---|---|---|
| Cluster de espelhos | Replicação em tempo real | ~1 min (pulsação + reinicialização) | 0 (sem perda de dados) |
| Agrupamento Agrícola | Balanceamento de carga de rede | Alguns segundos | N/A (sem estado) |
Alta disponibilidade em ação: demonstrações em tempo real de RPO zero e RTO quase zero
Vídeo: Alcançando zero RPO e baixo RTO em um cluster de espelho SafeKit (8:47)
Veja como SafeKit lida com uma falha crítica. Este vídeo demonstra a replicação síncrona garantindo que nenhum dado seja perdido (RPO 0) em um banco de dados SQL e a reinicialização automática de serviços no nó secundário (baixo RTO).
Capítulos
- 🎬 Nós 2 com SQL Server (0:32)
- 🎬 Configure o cluster e o módulo mirror.safe (3:58)
- 🎬 Iniciar e testar replicação SQL, migração, failover em crash (4:17)
Vídeo: Alcançando RTO próximo de zero em um cluster agrícola SafeKit (5:03)
Veja como SafeKit gerencia um web farm Apache para fornecer escalabilidade de desempenho e failover instantâneo.
Capítulos
- 🎬 Nós 2 com Apache (0:13)
- 🎬 Configure o cluster e o módulo farm.safe (2:20)
- 🎬 Iniciar e testar balanceamento de carga de rede, failover em caso de falha (2:30)
Perguntas frequentes: Otimizando RPO e RTO para continuidade de negócios
O RPO e o RTO podem ser zero?
Sim. Alcançar um RPO zero significa nenhuma perda de dados, o que é possível por meio do espelhamento de dados síncrono. Um RTO próximo de zero é alcançado por meio de software de failover automatizado como o SafeKit, que detecta falhas e reinicia aplicativos em um nó secundário em segundos ou minutos.
O que é mais importante: RPO ou RTO?
Nenhum dos dois é inerentemente mais importante; eles desempenham funções diferentes. RPO (Recovery Point Objective) concentra-se na perda de dados: quantos dados você pode perder. RTO (Recovery Time Objective) concentra-se no tempo de inatividade: a rapidez com que você deve estar online novamente. Para aplicações de missão crítica, ambos devem ser minimizados.
Qual é a diferença em RPO e RTO entre SafeKit no nível do aplicativo e no nível da VM?
Embora ambos garantam um RPO de 0 por meio da replicação síncrona, eles diferem no tempo de recuperação:
- Nível de aplicativo: RTO mais rápido (aprox. 1 min) porque apenas os serviços de aplicativo são reiniciados em um sistema operacional já em execução. Ele também detecta falhas específicas de software/processo.
- Nível de VM: RTO mais alto porque toda a máquina virtual deve ser reinicializada no host secundário. Embora independente de aplicativos, falta monitoramento granular dos próprios processos de aplicativos.
Qual é a diferença entre HA e soluções de backup em termos de RTO?
A Alta Disponibilidade (HA) normalmente oferece um RTO muito mais baixo (segundos a minutos) porque trata falhas locais automaticamente. A recuperação de desastres com soluções de backup (DR) geralmente tem um RTO mais alto (horas ou dias) porque envolve a recuperação de dados e serviços em um local geograficamente distante após uma grande catástrofe.
Como consigo o melhor RPO e RTO entre sites remotos?
Alcançar um RPO zero e um RTO próximo de zero em locais remotos requer uma combinação de replicação síncrona e uma LAN estendida (VLAN estendida):
- LAN estendida/VLAN estendida: Ao estender a mesma sub-rede (camada 2) em dois data centers, você pode mover um aplicativo do site A para o site B sem alterar seu endereço IP, evitando atualizações complexas de DNS.
- A solução SafeKit: SafeKit aproveita isso fornecendo um IP virtual (VIP) definido por software que flutua entre sites. Ele redireciona instantaneamente o tráfego para o site secundário usando ARP gratuito (GARP).
Isso fornece um RPO = 0 (espelhamento em tempo real) e um RTO mínimo (failover em aproximadamente 1 minuto) sem intervenção humana.
Por que combinar alta disponibilidade e backup é essencial para otimizar RPO e RTO?
Combinar alta disponibilidade (HA) com uma solução de backup é a única maneira de obter uma estratégia de recuperação do tipo “melhor de dois mundos”. Embora sejam frequentemente discutidos em conjunto, eles resolvem diferentes partes da equação RPO/RTO:
- Alta disponibilidade (via SafeKit): Otimiza para RTO próximo de zero e RPO zero durante falhas de hardware ou software. Ao usar a replicação síncrona em tempo real, o servidor secundário está sempre atualizado. Se o primário falhar, o serviço será reiniciado imediatamente no secundário, sem perda de dados.
- Soluções de backup: proteja contra problemas de integridade de dados (como ransomware ou exclusão acidental). Como o HA replica as alterações instantaneamente, ele replicará “fielmente” um vírus ou um registro de banco de dados excluído para o servidor em espera. Um backup permite que você “volte no tempo” a um ponto anterior à ocorrência da corrupção.
- A abordagem híbrida: para obter resiliência máxima, as organizações usam uma arquitetura híbrida de três nós. Isso inclui um cluster local de 2 nós com replicação síncrona para HA imediata e uma terceira cópia remota (assíncrona) para recuperação de desastres. Essa defesa em camadas garante que você tenha uma cópia “ativa” para recuperação instantânea e uma cópia “histórica” para segurança dos dados.
🔍 Hub de Navegação de Alta Disponibilidade SafeKit
Explore o SafeKit: Recursos, vídeos técnicos, documentação e teste gratuito
| Tipo de Recurso | Descrição | Link Direto |
|---|---|---|
| Recursos Principais | Por que escolher o SafeKit para uma Alta Disponibilidade simples e econômica? | Veja por que escolher o SafeKit para Alta Disponibilidade |
| Casos de Uso | Descubra como o SafeKit garante a alta disponibilidade de infraestruturas críticas | Ver todos os casos de uso (Software OEM, Servidores Edge, SCADA e mais) |
| Modelo de Implantação | HA SANless Tudo-em-Um: Clustering de Software Shared-Nothing | Veja o SafeKit HA SANless Tudo-em-Um |
| Estratégias de HA | SafeKit: Infraestrutura (VM) vs. Alta Disponibilidade no Nível da Aplicação | Veja SafeKit HA & Redundância: VM vs. Nível de Aplicação |
| Especificações Técnicas | Limitações Técnicas para o Clustering SafeKit | Veja as Limitações de Alta Disponibilidade do SafeKit |
| Vídeos | SafeKit: Configuração de Alta Disponibilidade e Demos de Failover | Veja os Tutoriais de Failover do SafeKit |
| Arquitetura | Como funciona o Mirror Cluster do SafeKit (Replicação e Failover em Tempo Real) | Veja SafeKit Mirror Cluster: Replicação em Tempo Real e Failover |
| Arquitetura | Como funciona o Farm Cluster do SafeKit (Balanceamento de Carga de Rede e Failover) | Veja SafeKit Farm Cluster: Balanceamento de Carga de Rede e Failover |
| Vantagens Competitivas | Comparação: SafeKit vs. Clusters de Alta Disponibilidade (HA) Tradicionais | Veja a Comparação: SafeKit vs. Cluster de HA Tradicional |
| Recursos Técnicos | Alta Disponibilidade SafeKit: Documentação, Downloads e Teste | Veja Teste Gratuito e Documentação Técnica do SafeKit HA |
| Soluções Pré-configuradas | Biblioteca de Módulos de Aplicação SafeKit: Soluções de HA Prontas para Uso | Veja os Módulos de Aplicação de Alta Disponibilidade SafeKit |
