Alta Disponibilidade K3S com SafeKit: Instale o Módulo k3s.safe para Failover
Guia de Instalação Rápida de Alta Disponibilidade para Kubernetes
Este guia explica como configurar um cluster mirror para Kubernetes usando SafeKit, garantindo o failover automático e a replicação síncrona sem a necessidade de armazenamento compartilhado.
Para obter ajuda, você pode usar SafeKit AI 🤖.
1. Visão geral
- Arquitetura: utiliza um sistema de dois nós (primário/secundário).
- Proteção de dados: implementa a replicação síncrona em tempo real para perda zero de dados (RPO = 0).
2. Instalação
- Software: Instale o motor SafeKit em ambos os servidores.
- Módulo: Baixe o módulo de aplicativo pré-configurado
k3s.safe.
3. Configuração
- Console da Web: configure as pastas específicas que contêm os arquivos Kubernetes.
- Monitoramento: Inicie o monitoramento e a proteção do aplicativo Kubernetes.
Limitações SafeKit de Alta Disponibilidade
| Limite/Requisito | Motivo e Impacto | Alternativa recomendada |
|---|---|---|
| Tamanho da replicação: alguns TBs | Tempo de resincronização após falha (etapa 3): • Rede de 1 Gb/s ≈ 3 horas/TB • Rede de 10 Gb/s ≈ 1 hora/TB (dependendo do desempenho de gravação do disco) | • Usar armazenamento compartilhado externo (mais caro, mais complexo). |
| Contagem de arquivos: < 1.000.000 de arquivos | • Desempenho do tempo de resincronização após uma falha (etapa 3). • Tempo necessário para comparar cada arquivo entre os dois nós. | • Coloque os vários arquivos a serem replicados em um disco rígido virtual/máquina virtual. • Apenas os arquivos que representam o disco rígido virtual/máquina virtual serão replicados e resincronizados neste caso. |
| Capacidade de failover: ≤ 32 VMs | • Cada VM é executada em um módulo mirror independente. • Máximo de 32 módulos mirror em execução no mesmo cluster. | • Utilize um armazenamento compartilhado externo e outra solução de cluster de máquinas virtuais (mais cara e mais complexa). |
| Arquitetura de rede: rede LAN/VLAN entre locais remotos | • Failover automático do endereço IP virtual com 2 nós na mesma sub-rede. • Boa largura de banda para resincronização (passo 3). • Baixa latência para replicação síncrona: normalmente < 5 ms RTT; valores mais altos devem ser validados em relação à taxa de gravação do aplicativo. | • Se os dois nós estiverem em sub-redes diferentes (comum na nuvem), use outras opções de redirecionamento: um balanceador de carga, CLIs de provedor de nuvem, BGP ou redirecionamento de DNS. • Utilize soluções de backup com replicação assíncrona para redes com alta latência. |
Visão geral da solução SafeKit/Kubernetes
A solução é descrita aqui: 💡 Alta Disponibilidade Kubernetes K3s: Replicação Síncrona e Failover de 2 Nós
Instalação e configuração da solução SafeKit/Kubernetes no Linux (k3s.safe)
1. Baixar pacotes
- Baixe a versão gratuita do SafeKit 8.2 para Linux (safekitlinux_xx.bin)
- Baixe o módulo Linux k3s.safe
- Baixe o script k3sconfig.sh
- Documentação (pptx)
Observação: o script k3sconfig.sh instala K3S, MariaDB, NFS e SafeKit em 2 nós Linux Ubuntu 24.04.
2. Primeiro em ambos os nós
Em 2 nós Linux Ubuntu 24.04, como root:
- Certifique-se de que o nó tem acesso à internet (pode ser através de um proxy)
- Copie k3sconfig.sh, k3s.safe e o pacote safekit_xx.bin para um diretório e acesse-o com o comando cd
- Renomeie o arquivo .bin para “safekit.bin”
- Certifique-se de k3sconfig.sh e safekit.bin sejam executáveis.
- Edite o script k3sconfig.sh e personalize as variáveis de ambiente de acordo com o seu ambiente (incluindo um IP virtual)
- Execute em ambos os nós:
./k3sconfig.sh prereq
O script irá:
- Instale os pacotes Debian necessários: alien, nfs-kernel-server, nfs-common, mariadb-server
- Instalação segura do MariaDB
- Crie diretórios para a replicação de arquivos
- Prepare o servidor NFS para compartilhar diretórios replicados
- Instale SafeKit
3. No primeiro nó
Execute no primeiro nó: ./k3sconfig.sh first
O script irá:
- Crie o banco de dados de configuração K3S e o usuário k3s
- Crie o arquivo de volume de armazenamento replicado (arquivo esparso) e formate-o como um sistema de arquivos xfs
- Crie a configuração do cluster safekit e aplique-a
- Instale e configure o módulo k3s.safe no cluster
- Inicie o módulo k3s como “prim” no primeiro nó
- Baixe, instale e inicie o k3s
- Baixe e instale o gráfico Helm do nfs-subdir-external-provisioner
- Exibir o token K3S (a ser usado durante a segunda fase de instalação do nó)
4. No segundo nó
Execute no segundo nó: ./k3sconfig.sh second <token>
é a string exibida no final da execução do " k3sconfig.sh first" no primeiro nó
O script irá:
- Certifique-se de que o módulo k3s seja iniciado como prim no primeiro nó
- Instale o k3s no segundo nó
- Inicie o módulo k3s
5. Verifique se o módulo k3s SafeKit está em execução em ambos os nós
Verifique com este comando em ambos os nós: /opt/safekit/safekit –H "*" state
A resposta deve ser semelhante à imagem.
/opt/safekit/safekit –H "*" state
---------------- Servidor= http://10.0.0.20:9010 ----------------
Ação admin = executar
--------------------- Estado do k3s ---------------------

  Local (127.0.0.1): PRIM (Serviço: Disponível) (Cor: Verde)
Sucesso
---------------- Servidor= http://10.0.0.21:9010 ----------------
Ação admin = executar
--------------------- Estado do k3s ---------------------

  Local (127.0.0.1): SECOND (Serviço: Disponível) (Cor: Verde)
Sucesso
6. Inicie o console web SafeKit para administrar o cluster
- Conecte um navegador ao URL do console da web SafeKit
http://server0-IP:9010. - Você deve ver uma página semelhante à imagem.
- Verifique com as linhas de comando Linux se K3S é iniciado em ambos os nós (iniciado em
start_primestart_second) e se MariaDB é iniciado no nó primário (iniciado emstart_prim).

7. Testes
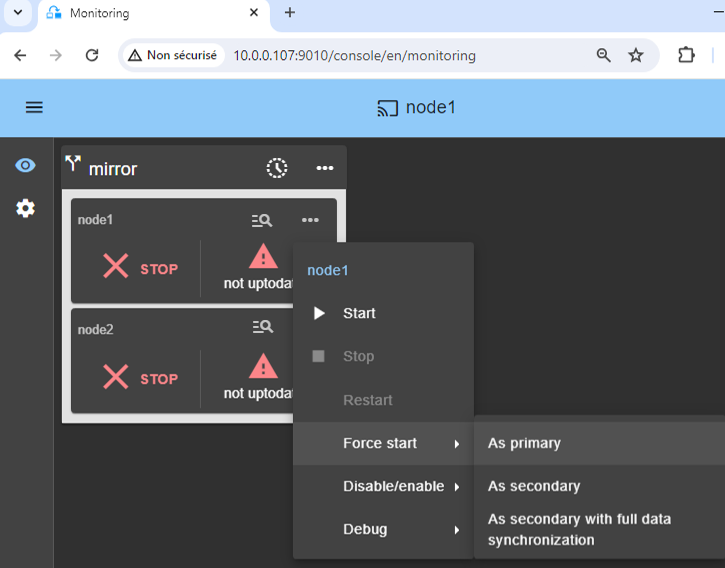
- Pare o nó PRIM rolando para baixo no menu contextual e clicando em
Stop. - Verifique se há um failover no SECOND nó, que deve ficar ALONE (verde).
- E com linhas de comando no Linux, verifique o failover dos serviços (parados no nó 1 no script
stop_prime iniciados no nó 2 no scriptstart_prim). MariaDB e K3S devem ser executados no node2.

Se ALONE (verde) não for atingido no node2, analise o motivo com o log do módulo do nó 2.
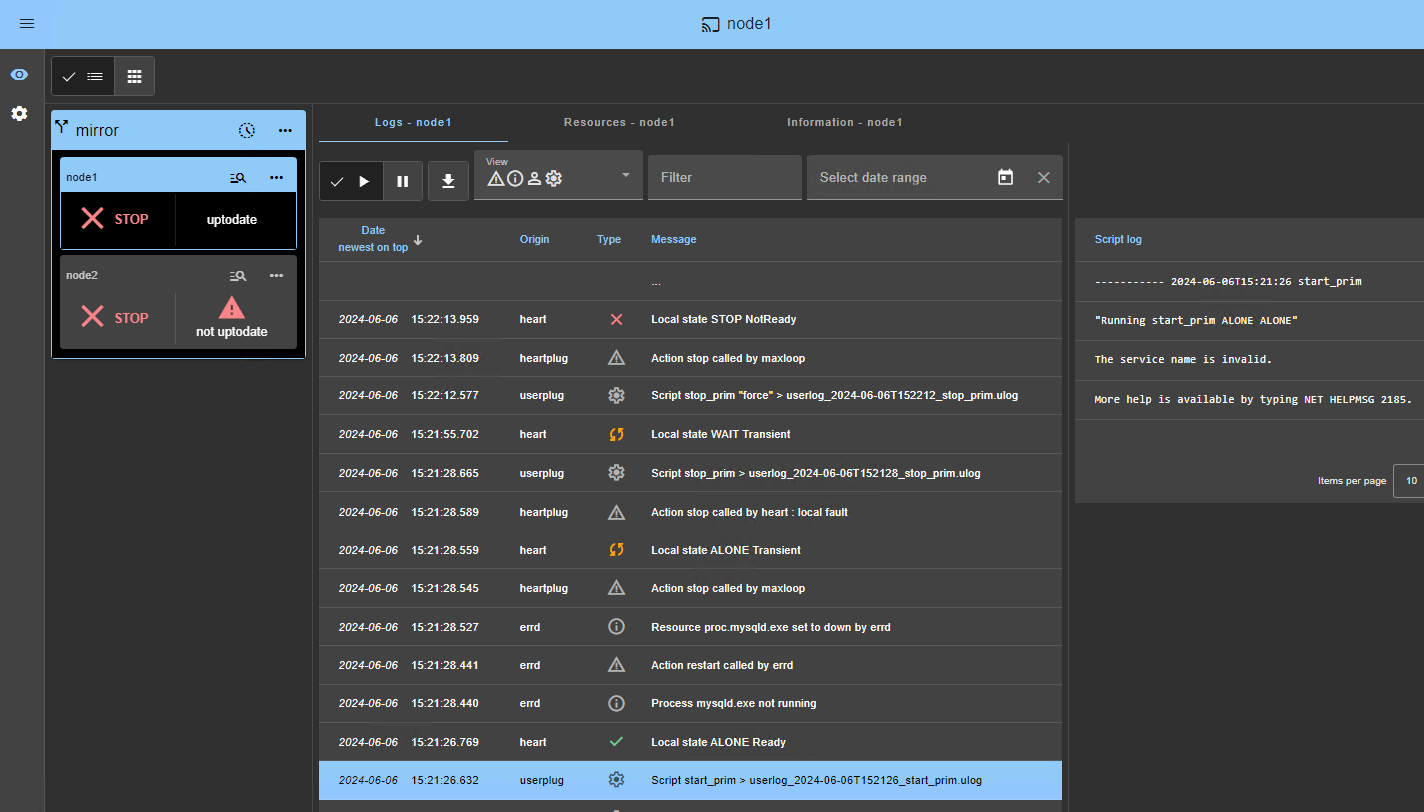
- Clique no
node2para exibir o log do módulo. - exemplo de um log de módulo SQL Server em que o nome do serviço em
start_primé inválido. O processo sqlserver.exe é monitorado, mas como não é iniciado, no final o módulo para.
Se tudo estiver bem, inicie o node1, que irá ressincronizar os diretórios replicados do node2.
Se as coisas derem errado, pare node2 e force o início como primário do node1, que será reiniciado com seus dados localmente íntegros no momento da parada.

🛠️ Mais informações sobre os testes no Guia do Usuário.

8. Experimente o cluster com um aplicativo Kubernetes, como o WordPress
Você tem o exemplo de uma instalação do WordPress na imagem: um portal da web com um banco de dados de backend implementado por pods.
Você pode implantar seu próprio aplicativo da mesma forma.
O WordPress é automaticamente altamente disponível:
- com os seus dados (PHP + base de dados) em volumes persistentes replicados em tempo real pelo SafeKit
- com um endereço IP virtual para acessar o site do WordPress para os usuários
- com failover automático e failback automático
Observações:
O gráfico do WordPress define um serviço de balanceamento de carga que escuta nas portas <service.port> e <service.httpsport>.
O WordPress está acessível através do URL:
http://<virtual-ip>:<service.port>.O IP virtual é gerenciado pelo SafeKit e é alterado automaticamente em caso de failover.
Por padrão, K3S implementa balanceadores de carga com o Klipper.
O Klipper escuta em
: <service.port> e roteia os pacotes TCP/IP para o endereço IP e a porta do pod do WordPress que ele selecionou. $ export KUBECONFIG= /etc/rancher/k3s/k3s.yaml $ helm repo add bitnami https://charts.bitnami.com/bitnami $ helm install my-release bitnami/wordpress –set global.storageClass=nfs-client –set service.ports.http=8099,service.ports.https=4439
O comando helm anterior deve baixar a imagem do WordPress do registry-1.docker.io. Você pode encontrar problemas de autenticação no registry-1.docker.io. Nesse caso, você deve:
Crie
/etc/rancher/k3s/registries.yamlem ambos os nós com o seguinte conteúdo:configs: "registry-1.docker.io": auth: username: your_user_name password: your_password tls: insecure_skip_verify: truepare e inicie o k3s para que ele seja levado em consideração, com
systemctl stop k3sesystemctl start k3s.Execute o
helm registry login -u your_user_name docker.ioe, em seguida, digite sua senha
9. Suporte
- Para obter suporte, faça 2
SnapshotsSafeKit (2 arquivos .zip), um para cada nó.
🛠️ Resolução de problemas no Guia do Usuário.

10. Se necessário, configure um checker split-brain
Consulte abaixo “Quais são os diferentes cenários em caso de isolamento de rede em um cluster?” para saber se você precisa configurar um checker split-brain.
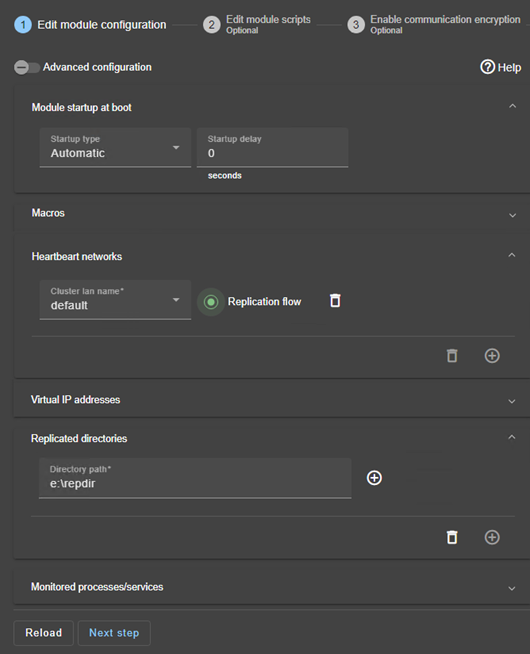
Na configuração do módulo, clique em
Advanced Configuration(veja a imagem) para editaruserconfig.xml.Declare o checker split-brain adicionando-o na seção
<check>douserconfig.xml:<service> ... <check> ... <splitbrain ident="witness" exec="ping" arg="witness IP"/> </check>Save and applya nova configuração para reimplantar o arquivo userconfig.xml modificado em ambos os nós (o módulo deve ser interrompido em ambos os nós para salvar e aplicar).
Parâmetros :
ident="witness"identifica a testemunha com um nome de recurso:splitbrain.witness. Você pode alterar esse valor para identificar a testemunha.exec="ping"faz referência ao código de ping a ser executado. Não altere esse valor.arg="witness IP"é um argumento para o ping. Altere este valor com o IP da testemunha (um elemento robusto, normalmente um roteador).
Quais são os diferentes cenários em caso de isolamento de rede em um cluster?
Uma única rede
Quando há um isolamento de rede, o comportamento padrão é:
- à medida que heartbeats são perdidas para cada nó, cada nó vai para ALONE e executa o aplicativo com seu endereço IP virtual (execução dupla do aplicativo modificando seus dados locais),
- quando o isolamento é reparado, um nó ALONE é forçado a parar e a ressincronizar seus dados com o outro nó,
- no final, o cluster é PRIM-SECOND (ou SECOND-PRIM, de acordo com a detecção de endereço IP virtual duplicado feita pelo Windows).
Duas redes com uma rede de replicação dedicada
Quando há um isolamento de rede, o comportamento com uma rede de replicação dedicada é:
- uma rede de replicação dedicada é implementada em uma rede privada,
- Heartbeats na rede de produção são perdidos (rede isolada),
- Heartbeats na rede de replicação estão funcionando (não na rede isolada),
- o cluster permanece no estado PRIM/SECOND.
Uma única rede e um checker split-brain
Quando há um isolamento de rede, o comportamento com um checker split-brain é:
- um checker split-brain foi configurado com o endereço IP de uma testemunha (normalmente um roteador),
- o checker split-brain opera quando um servidor passa de PRIM para ALONE ou de SECOND para ALONE,
- Em caso de isolamento de rede, antes de ir para ALONE, ambos os nós testam o endereço IP
- o nó que pode acessar o endereço IP vai para ALONE, o outro vai para WAIT,
- Quando o isolamento é reparado, o nó WAIT resincroniza seus dados e se torna SECOND.
Observação: se a testemunha estiver inativa ou desconectada, ambos os nós entram em WAIT e o aplicativo não está mais em execução. É por isso que você deve escolher uma testemunha robusta, como um roteador.
Demonstração da solução mirror SafeKit
Vídeo SafeKit: Agrupamento em nível de aplicativo (8:47)
Neste vídeo, descubra como SafeKit implementa um cluster de HA mirror sem a complexidade de uma SAN. Embora esta demonstração use Microsoft SQL Server, a solução funciona de forma idêntica para outros bancos de dados e aplicativos.
Capítulos
- 🎬 2 nós com SQL Server (0:32)
- 🎬 Configure o cluster e o módulo mirror.safe (3:58)
- 🎬 Inicie e teste a replicação, migração e failover do SQL em caso de falha (4:17)
Implementação passo a passo
- 🛠️ Leia o guia sobre como configurar um cluster mirror no Windows
- 🛠️ Leia o guia sobre como configurar um cluster mirror no Linux
🔍 Explore o SafeKit
Encontre informações sobre os recursos, as arquiteturas, os vídeos, a documentação e a avaliação gratuita do SafeKit.
| Recurso | Descrição | Link |
|---|---|---|
| Principais características | Saiba por que o SafeKit é uma solução de alta disponibilidade simples e econômica. | Descubra as principais funcionalidades |
| Casos de uso | Saiba como o SafeKit mantém as aplicações e a infraestrutura críticas disponíveis. | Explore os casos de uso |
| Modelo de implantação | O SafeKit oferece alta disponibilidade sem a necessidade de uma SAN ou armazenamento compartilhado. | Explore o modelo de implantação |
| Estratégias de alta disponibilidade | Compare a alta disponibilidade para máquinas virtuais com a alta disponibilidade para aplicativos. | Compare as duas estratégias |
| Especificações técnicas | Verifique os requisitos técnicos e as limitações dos clusters do SafeKit. | Leia as especificações técnicas |
| Vídeos | Assista a demonstrações da configuração do SafeKit e do failover automático. | Assista aos vídeos técnicos |
| Arquitetura | Saiba como o cluster mirror replica arquivos em tempo real e lida com o failover. | Explore a arquitetura Mirror |
| Arquitetura | Saiba como o cluster farm equilibra o tráfego de rede e lida com o failover. | Explore a arquitetura Farm |
| Comparação de produtos | Compare o SafeKit com os clusters de alta disponibilidade tradicionais. | Compare as soluções |
| Recursos técnicos | Encontre a documentação técnica, baixe o SafeKit e acesse a versão de teste gratuita. | Acesse a documentação e a versão de teste gratuita |
| Módulos de aplicação | Use os módulos pré-configurados do SafeKit para configurar alta disponibilidade para seus aplicativos. | Explore os módulos do aplicativo |