Alta disponibilidade do PostgreSQL com SafeKit: Instale o módulo postgresql.safe para failover
Guia de instalação rápida de alta disponibilidade para PostgreSQL
Este guia explica como configurar um cluster de espelhos para PostgreSQL usando SafeKit, garantindo failover automático e replicação síncrona sem a necessidade de armazenamento compartilhado.
Para obter ajuda, você pode usar SafeKit AI 🤖.
1. Visão geral
- Arquitetura: Usa um sistema de dois nós (Primário/Secundário).
- Proteção de dados: Implementa replicação síncrona em tempo real para zero perda de dados (RPO=0).
2. Instalação
- Programas: Instale o mecanismo SafeKit em ambos os servidores.
- Módulo: Baixe o pré-configurado
postgresql.safe.safemódulo de aplicação.
3. Configuração
- Consola Web: Configure as pastas específicas que contêm os arquivos PostgreSQL.
- Monitoramento: Comece a monitorar e proteger o aplicativo PostgreSQL.
Limitações de Alta Disponibilidade do SafeKit
| Limite / Requisito | Motivo e Impacto | Alternativa Recomendada |
|---|---|---|
| Tamanho da replicação: Alguns TBs | Tempo de ressynchronização após uma falha (etapa 3): • Rede de 1 Gb/s ≈ 3 horas / TB • Rede de 10 Gb/s ≈ 1 hora / TB (dependendo do desempenho de gravação em disco) | • Usar armazenamento compartilhado externo (mais caro, mais complexo). |
| Contagem de arquivos: < 1.000.000 arquivos | • Desempenho do tempo de ressynchronização após uma falha (etapa 3). • Tempo necessário para verificar cada arquivo entre ambos os nós. | • Colocar os vários arquivos a serem replicados em um disco rígido virtual / máquina virtual. • Nesse caso, apenas os arquivos que representam o disco rígido virtual / a máquina virtual serão replicados e ressynchronizados. |
| Capacidade de failover: ≤ 32 VMs | • Cada VM é executada em um módulo de espelhamento independente. • Máximo de 32 módulos de espelhamento em execução no mesmo cluster. | • Usar um armazenamento compartilhado externo e outra solução de clustering de VMs (mais caro, mais complexo). |
| Arquitetura de rede: Rede LAN/VLAN entre sites remotos | • Failover automático do endereço IP virtual com 2 nós na mesma sub-rede. • Boa largura de banda para ressynchronização (etapa 3). • Baixa latência para replicação síncrona: tipicamente < 5 ms de RTT; valores superiores devem ser validados em relação à taxa de gravação da aplicação. | • Usar um balanceador de carga para o endereço IP virtual se os 2 nós estiverem em 2 sub-redes diferentes (suportado pelo SafeKit, especialmente na nuvem). • Usar soluções de backup com replicação assíncrona para redes de alta latência. |
Visão geral da solução SafeKit/PostgreSQL
A solução é descrita aqui: 💡A alta disponibilidade mais simples do PostgreSQL: replicação síncrona e failover de 2 nós.
Instalação da solução SafeKit/PostgreSQL em Windows e Linux (postgresql.safe)
Pré-requisitos
- Você precisa do PostgreSQL instalado em 2 nós (máquinas virtuais ou servidores físicos).
Instalação do pacote em Windows
- Baixe e instale a versão gratuita do SafeKit em 2 nós Windows.
Nota: a versão gratuita inclui todos os recursos do SafeKit. No final da avaliação, você poderá ativar chaves de licença permanentes sem desinstalar o pacote. - Ao concluir a instalação do pacote, selecione Set console credentials and firewall rules now e configure uma senha para o admin usuário do console SafeKit.
Defina a mesma senha em todos os nós. - Excluir das verificações antivírus C:/safekit/ (o diretório de instalação padrão) e todas as pastas replicadas que você vai definir.
Os antivírus podem enfrentar desafios de detecção com o SafeKit devido à sua estreita integração com o sistema operacional, mecanismos de IP virtual, replicação em tempo real e reinicialização de serviços críticos.
Instalação do módulo em Windows
- Baixe o módulo postgresql.safe. O módulo é gratuito. Ele contém os arquivos userconfig.xml e os scripts de reinicialização.
- Colocar postgresql.safe sob C:/safekit/Application_Modules/generic.
Baixar postgresql.safe (Windows) >
Instalação do pacote em Linux
- Instale a versão gratuita do SafeKit em 2 nós Linux. Observação: a avaliação gratuita inclui todos os recursos do SafeKit. No final da avaliação, você poderá ativar chaves de licença permanentes sem desinstalar o pacote.
- Após o download do pacote safekit_xx.bin, execute-o para extrair o script rpm e safekitinstall e então execute o safekitinstall roteiro
- Resposta sim para configuração automática do firewall
- Defina a senha do console web e o usuário padrão admin. Defina a mesma senha em todos os nós.
Instalação do módulo em Linux
- Baixe o módulo postgresql.safe.
O módulo é gratuito. Ele contém os arquivos userconfig.xml e os scripts de reinicialização. - Colocar postgresql.safe sob /opt/safekit/Application_Modules/generic/.
Baixar postgresql.safe (Linux) >
Configuração passo a passo da solução SafeKit/PostgreSQL
Pré-requisitos
- Aplicativo PostgreSQL instalado em 2 nós.
- Total de dados replicados limitado a alguns terabytes — além disso, o tempo de ressincronização torna-se significativo.
- Interconexão mínima de 1 Gb/s entre nós (10 Gb/s recomendados para ressincronização mais rápida).
- O failover IP requer ambos os nós no mesmo LAN ou LAN estendido (L2) — redes L3 roteadas não suportadas (exceto com 🛠️ balanceadores de carga em nuvem).
1. Inicie o console SafeKit
- Inicie o console da web em um navegador em um nó do cluster conectando-se ao
http://localhost:9010. - Digite
admincomo nome de usuário e senha definidos durante a instalação.
Também é possível executar o console em um navegador em uma estação de trabalho externa ao cluster.
⚠️ A configuração do SafeKit é feita em ambos os nós a partir de um único navegador.
ℹ️ Para proteger o console da web, consulte 🛠️ 11. Protegendo o serviço da web SafeKit no Guia do usuário.
2. Configure endereços de nós
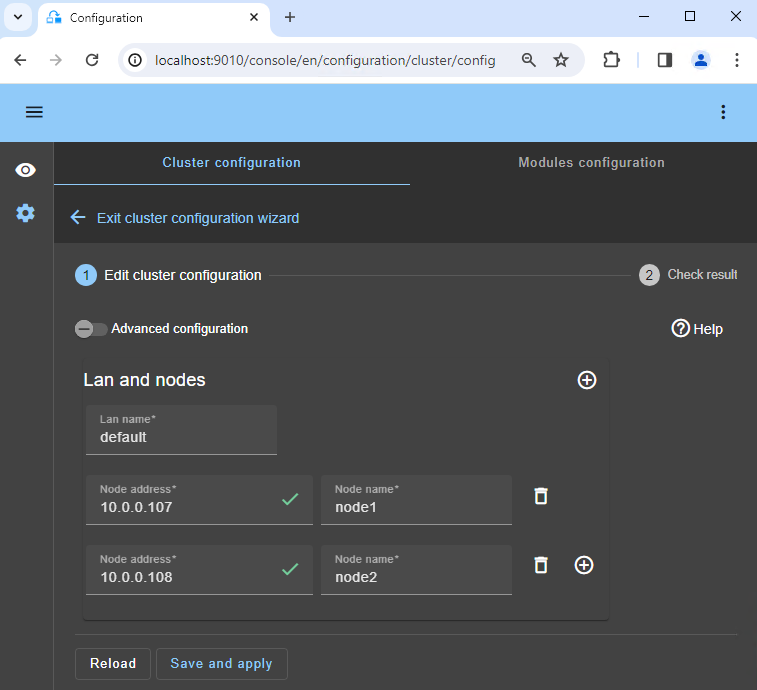
- Insira os endereços dos nós IP, pressione
Tab keypara verificar a conectividade e preencher os nomes dos nós. Se node1 ou node2 tiver uma cor vermelha, verifique a conectividade do navegador com ambos os nós e verifique o firewall em ambos os nós para 🛠️ solução de problemas. - Em seguida, clique em
Save and applypara salvar a configuração. - Verifique a mensagem
Success✅ em ambos os nós. - Se a configuração
Failure❌ ocorrer em um nó, abra o acordeão ▼ desse nó e revise as mensagens. Observe que você pode usar SafeKit AI 🤖 para obter assistência.
ℹ️ Se desejar, você pode adicionar um novo LAN and nodes (primeiro ➕) para criar uma segunda pulsação e uma rede de replicação dedicada.
ℹ️ Se você clicar em Advanced configuration, o arquivo cluster.xml será exibido. Este arquivo é preenchido automaticamente pelo console e implementado nos nós.
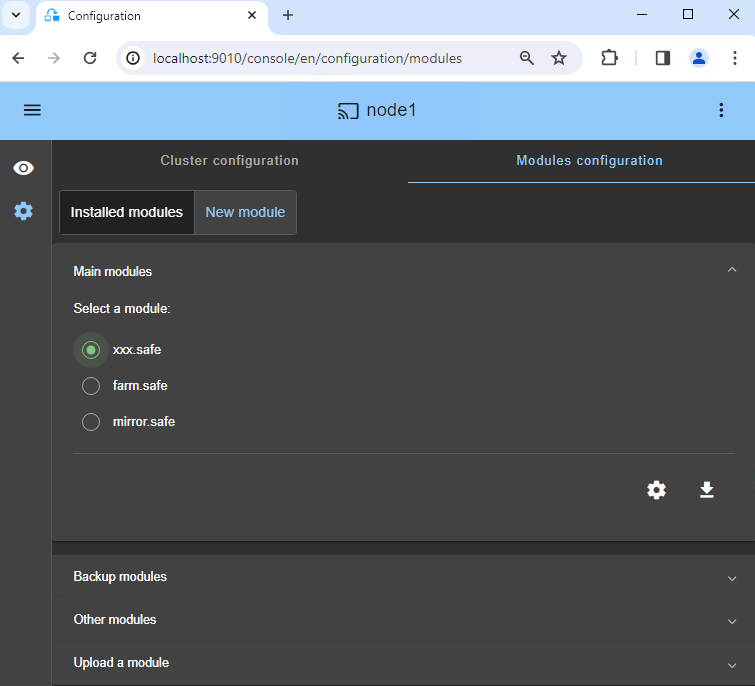
3. Selecione um módulo
- Em
New module, clique no módulopostgresql.safe.
ℹ️ No banner azul na parte superior, 🛜 node1 representa o nó de conexão do console. Este nó retransmite solicitações para node2 quando necessário.
ℹ️ O console procura xxx.safe no diretório Application_Modules/generic/ no nó de conexão (node1) se você colocou um módulo lá durante a instalação.
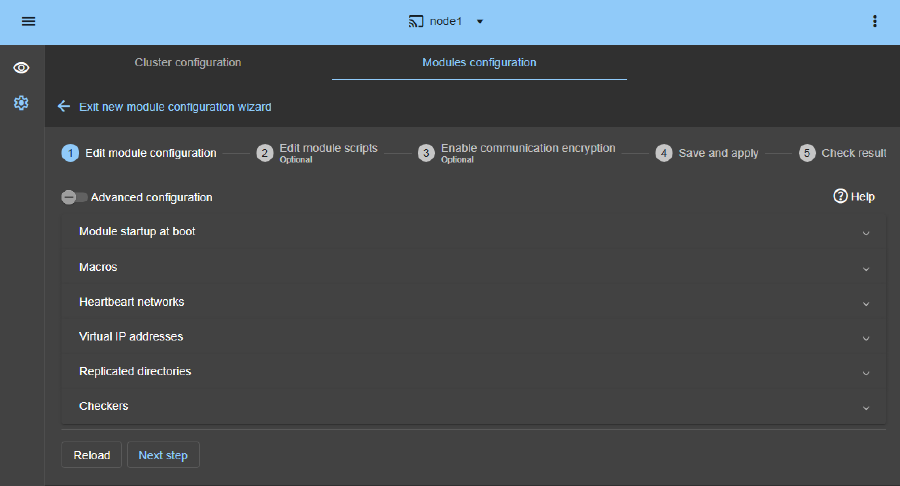
4. Configure o módulo
- Em
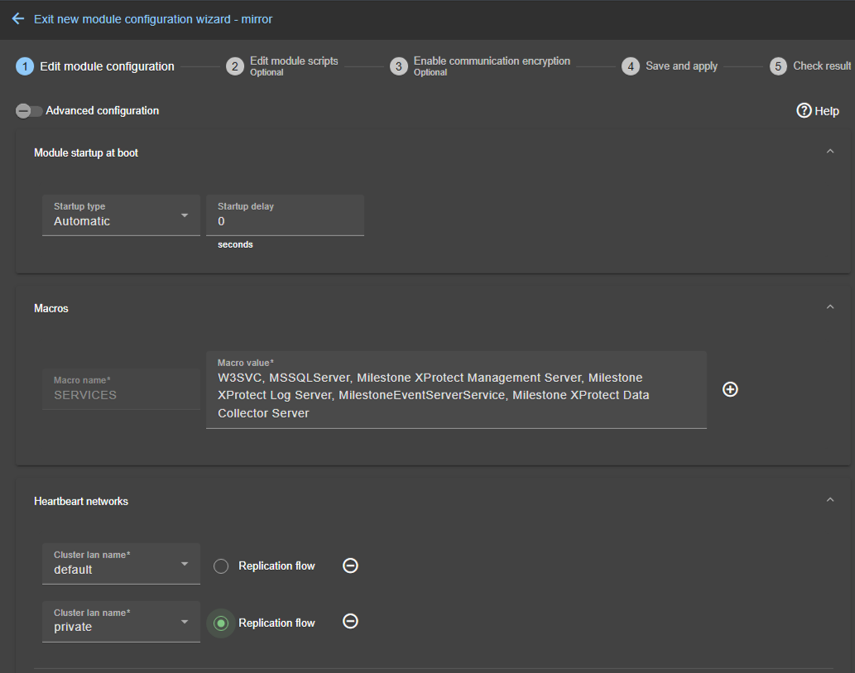
Module startup at boot, escolha um início automático do módulo na inicialização sem demora. - Em
Macros/SERVICES, insira os nomes dos serviços da sua aplicação, na ordem de inicialização, separados por vírgulas. Veja esta captura de tela para obter um exemplo visual dos serviços Milestone XProtect 🖼️. - Em
Heartbeat networks, você deve ter uma rede de pulsação única na qual a replicação é feita. Se você adicionou um LAN privado na etapa 2, poderá configurar duas pulsações com o fluxo de replicação no LAN privado. - Em
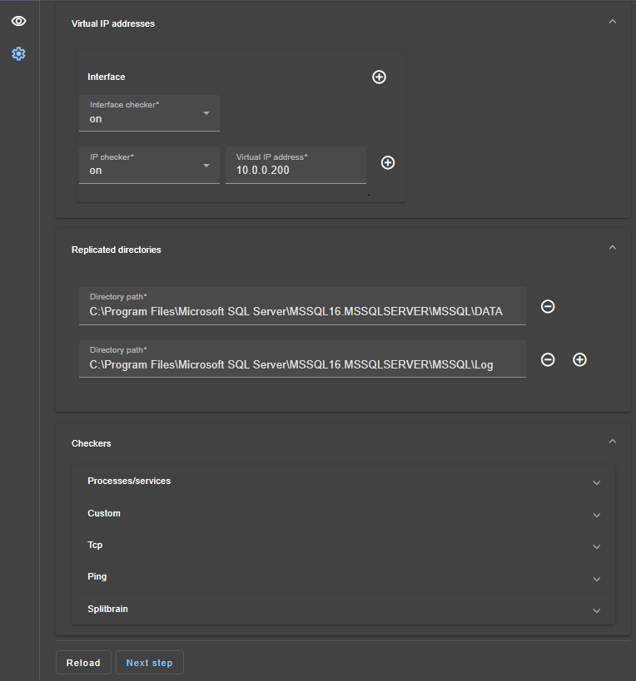
Virtual IP addresses, insira um endereço IP virtual. Um endereço IP virtual é um endereço IP padrão na mesma rede IP (mesma sub-rede) que os endereços IP de ambos os nós.
Os clientes aplicativos devem ser configurados com o endereço IP virtual (ou o nome DNS associado ao endereço IP virtual).
O endereço virtual IP é alternado automaticamente em caso de falha. - Em
Replicated directories, defina os caminhos dos diretórios para replicar. Verifique se eles existem em ambos os nós e contêm os dados do aplicativo.
A replicação de dados e logs é essencial para um banco de dados.
Você pode criar diretórios replicados adicionais conforme necessário.
Veja esta captura de tela para obter um exemplo visual da replicação Milestone XProtect SQL 🖼️. - No
Checkers, você poderá configurar verificadores, se necessário, como monitoramento de processos, verificadores personalizados, TCP, ping ou verificadores de cérebro dividido.
Por exemplo, se um nome de processo for exibido emMonitored processes/services, ele será monitorado com uma ação de reinicialização em caso de falha. Configurar um nome de processo incorreto fará com que o módulo pare logo após seu início.
ℹ️ Se você clicar em Advanced configuration, o arquivo userconfig.xml será exibido. Esse arquivo é preenchido automaticamente pelo console e implementado nos nós com os scripts de reinicialização.
ℹ️ Em uma implantação na nuvem, você não precisa configurar um endereço IP virtual em SafeKit. O IP virtual é gerenciado no nível do balanceador de carga de nuvem 🛠️ .
ℹ️ Quando você aplica a configuração SafeKit, o startup type dos serviços é automaticamente definido como Manual nos serviços Windows. Isso garante que os serviços não sejam iniciados automaticamente quando o sistema for inicializado, mas, em vez disso, sejam iniciados somente quando o próprio módulo for iniciado (o mesmo se aplica ao Linux).
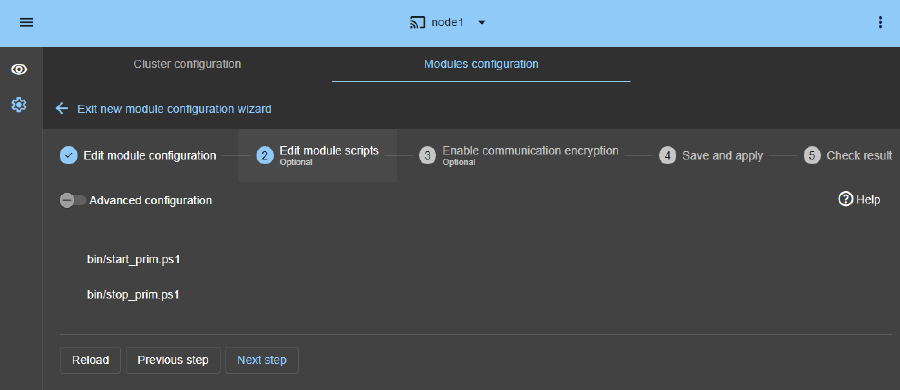
5. Edite scripts (opcional)
- Esta etapa é opcional e pode ser ignorada na maioria dos casos, pois os scripts de reinicialização já estão pré-configurados para reiniciar os serviços definidos na etapa anterior.
- Então, clique diretamente em
Next step. start_prim.ps1inicia todos os serviços na ordem especificada na listaSERVICES, enquantostop_prim.ps1interrompe todos os serviços na ordem inversa.- Além disso,
start_prim.ps1verifica a inicialização de cada serviço e interrompe o módulo se algum serviço não iniciar corretamente.
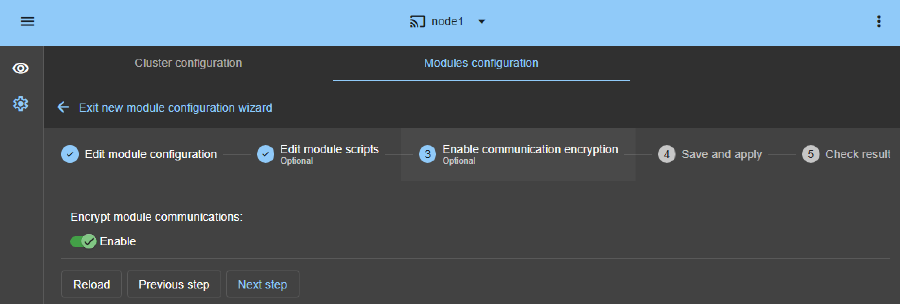
6. Criptografia de comunicação (opcional)
- Mantenha a criptografia da comunicação entre os nós.
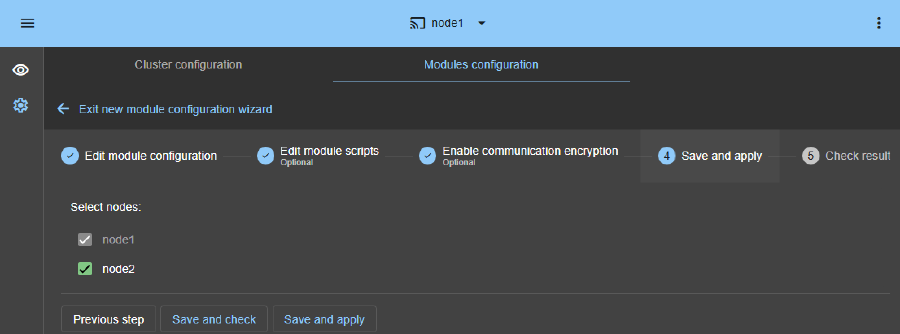
7. Salve e aplique
Save and applya configuração e os scripts em ambos os nós.
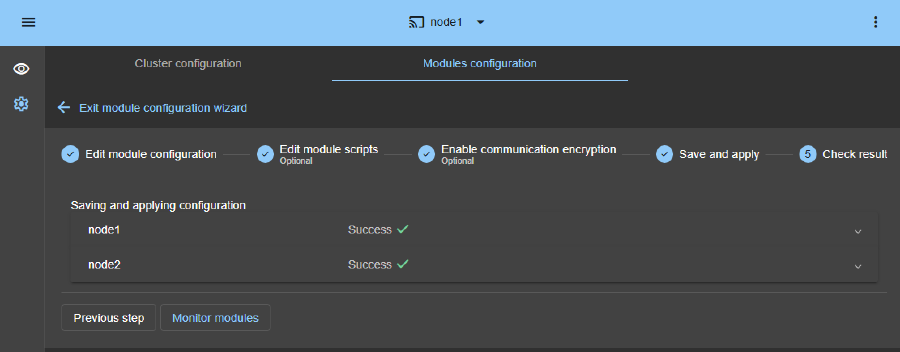
8. Verifique a configuração bem-sucedida
- Verifique a mensagem
Success✅ em ambos os nós e clique emMonitor modules. - Se a configuração
Failure❌ ocorrer em um nó, abra o acordeão ▼ desse nó e revise as mensagens. Observe que você pode usar SafeKit AI 🤖 para obter assistência.
⚠️ Em Linux, você pode receber um erro nesta etapa se os diretórios replicados forem pontos de montagem.🛠️ Consulte SK-0030 para resolver o problema.
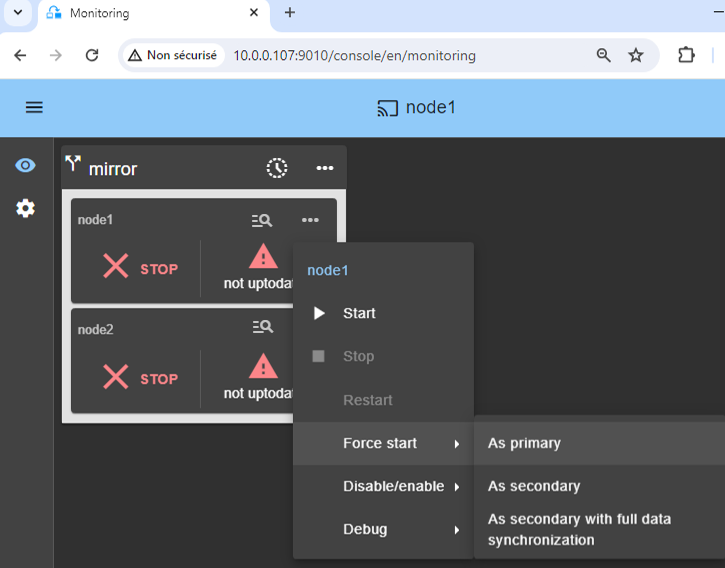
9. Inicie o nó com dados atualizados
- Se o nó 1 tiver diretórios replicados atualizados, selecione-o e ⋯
Force start▶As primary.
Quando o nó 2 for iniciado, todos os dados serão copiados do nó 1 para o nó 2.
⚠️ Se você fizer a escolha errada, corre o risco de sincronizar dados desatualizados em ambos os nós.
⚠️ Supõe-se também que a aplicação PostgreSQL seja parada no nó 1 para que SafeKit instale os mecanismos de replicação e então inicie a aplicação no script start_prim.
⚠️ Use Start para inicializações subsequentes: SafeKit mantém o servidor mais atualizado. A inicialização do As primary é uma inicialização especial na primeira vez ou durante operações excepcionais.
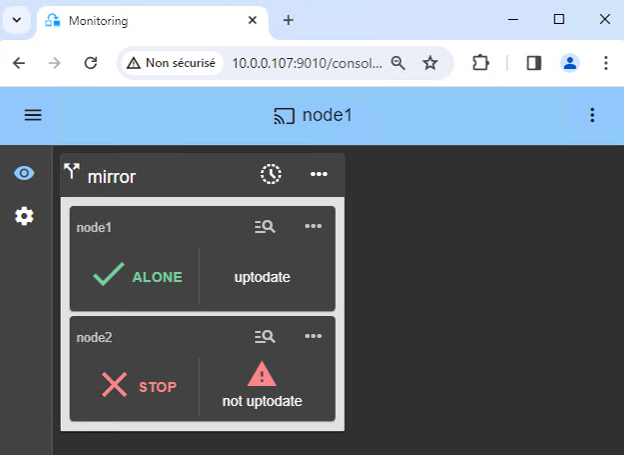
10. Aguarde a transição para ALONE (verde)
- O nó 1 deve atingir o estado ALONE (verde), o que significa que o IP virtual está configurado e que o script
start_primfoi executado no nó 1.
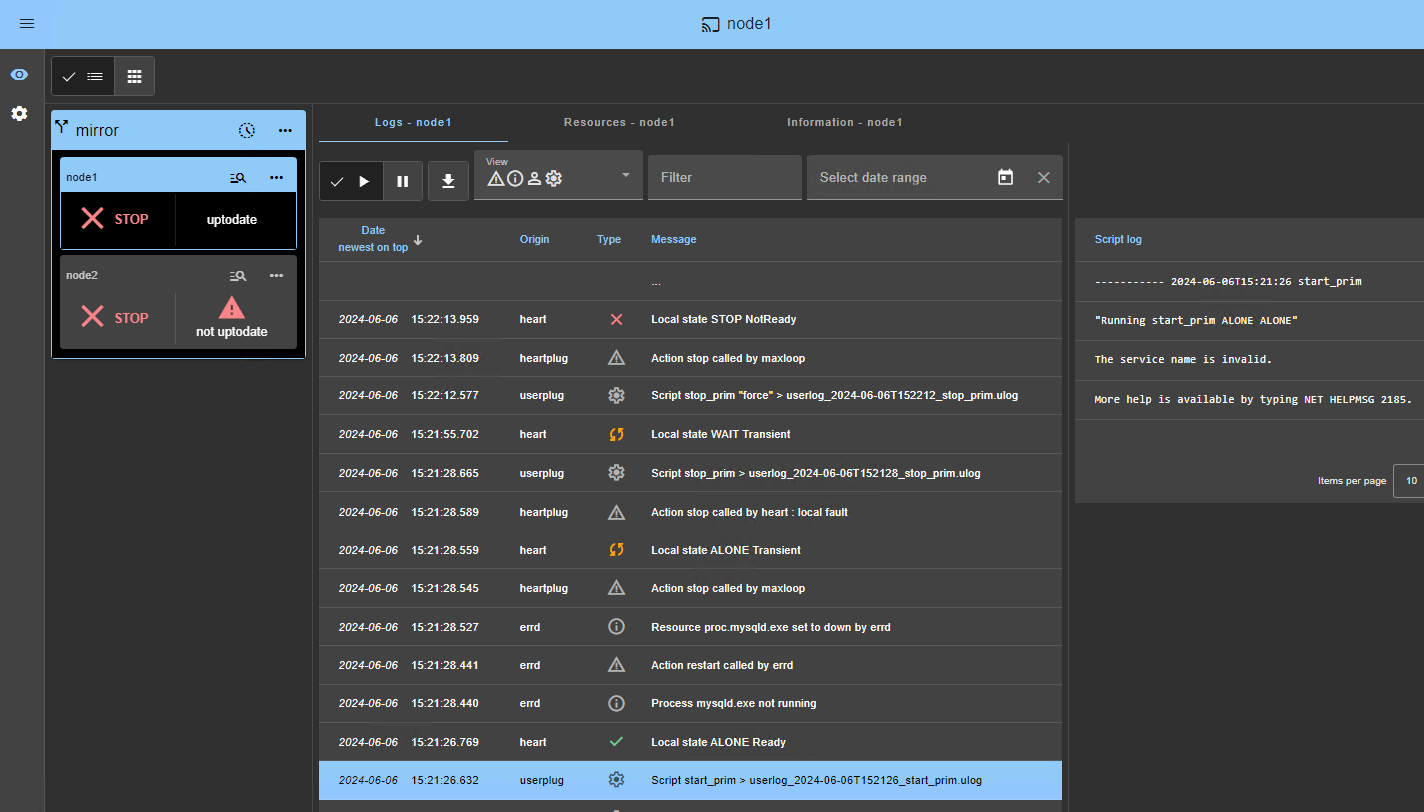
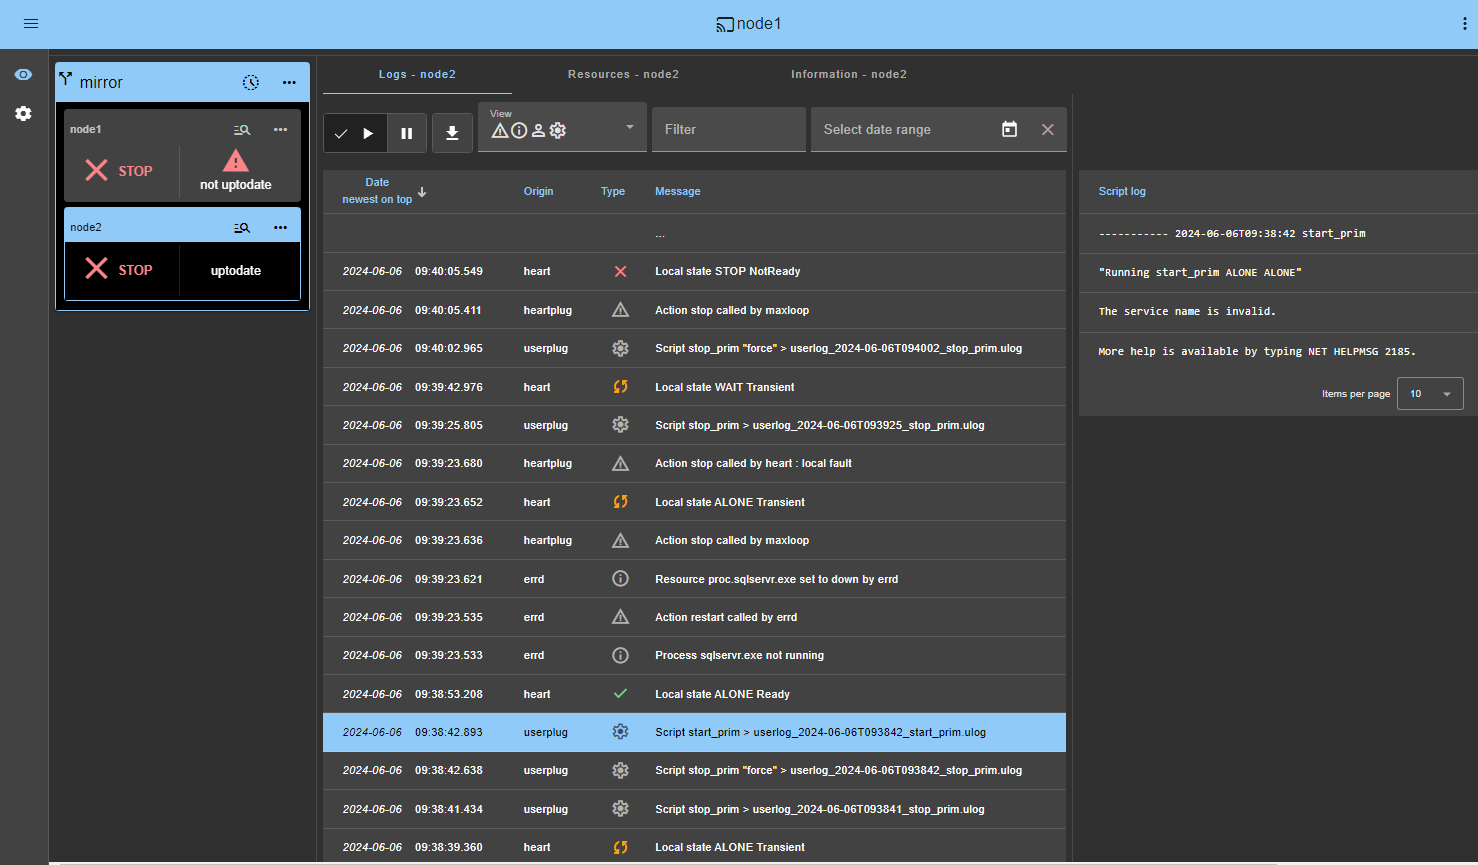
⚠️ Se ALONE (verde) não for alcançado ou se a aplicação não for iniciada, analise o porquê com o log do módulo 🖼️ do nó 1.
- Clique no ícone 🔍 log de
node1para abrir o log do módulo e procurar mensagens de erro, como um verificador detectando um erro e interrompendo o módulo. - Clique em
start_primno log: as mensagens de saída do script são exibidas à direita e erros podem ser detectados, como um serviço iniciado incorretamente. - Use SafeKit AI 🤖 para obter assistência com mensagens de log.
⚠️ Se o cluster estiver no estado WAIT (red) not uptodate, STOP (red) not uptodate, pare o nó WAIT e force seu início como primário 🖼️.
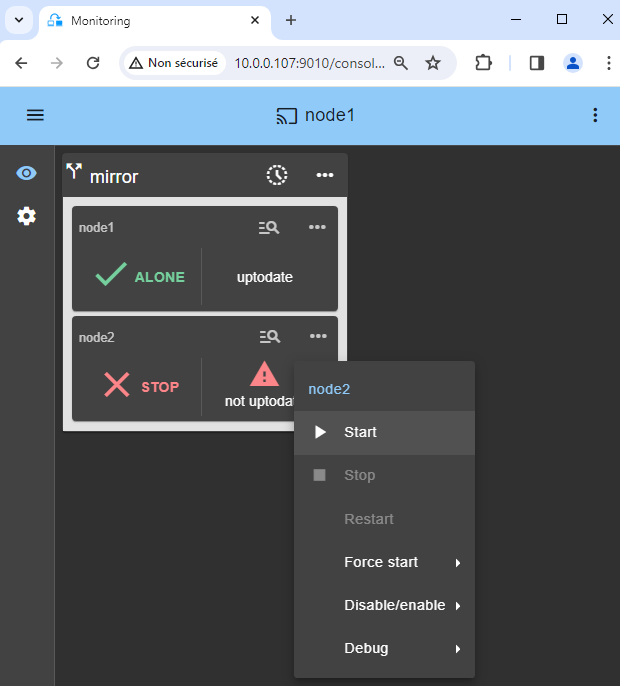
11. Iniciar nó 2
- ⋯ Nó
Start2 com seu menu contextual. - Aguarde o estado SECOND (verde).
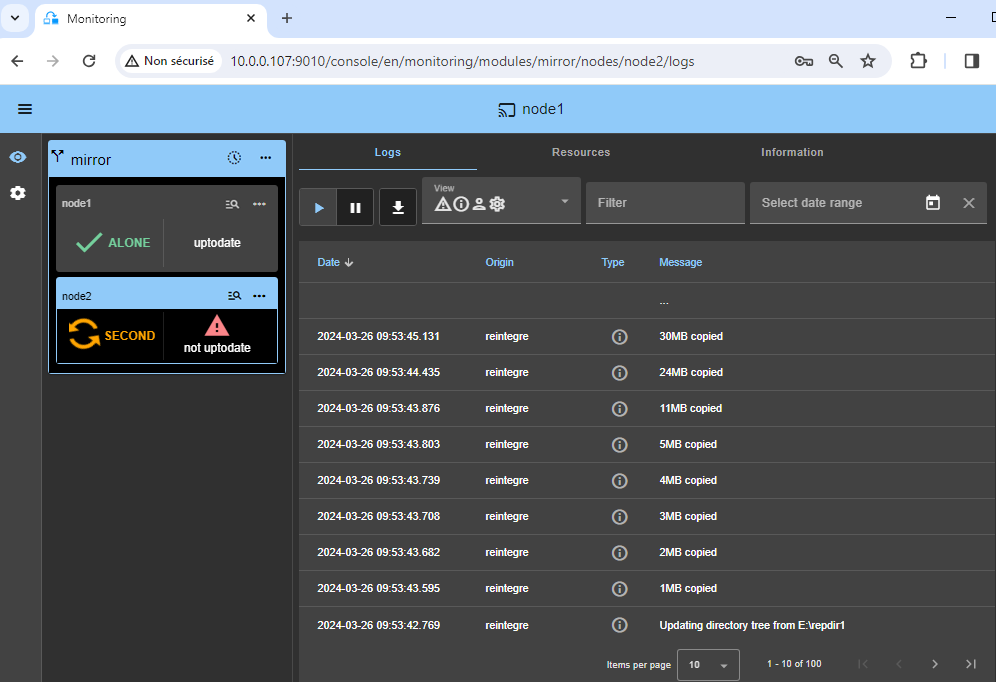
ℹ️ O nó 2 permanece no estado SECOND (laranja) enquanto ressincroniza os diretórios replicados (copia do nó 1 para o nó 2).
- Isso pode demorar um pouco, dependendo do tamanho dos arquivos a serem ressincronizados nos diretórios replicados e da largura de banda da rede.
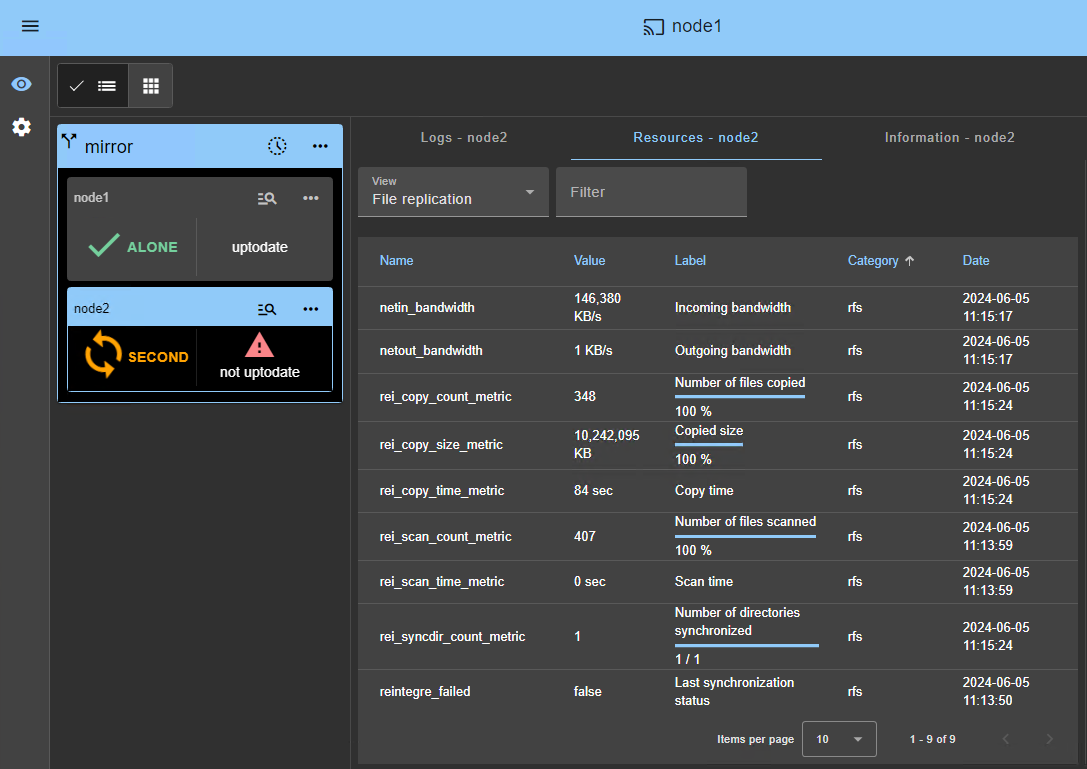
- Para ver o progresso da cópia, consulte o log do módulo 🖼️ e os recursos de replicação 🖼️ do nó 2. Use o SafeKit AI 🤖 para obter assistência com mensagens de log.
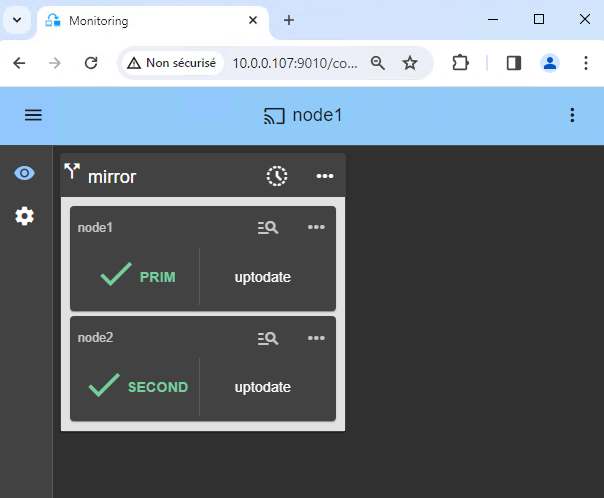
12. Verifique se o cluster está operacional
- Verifique se o cluster está verde/verde com serviços PostgreSQL em execução no nó PRIM e não em execução no nó SECOND.
Somente as alterações dentro dos arquivos são replicadas em tempo real neste estado.
⚠️ Os componentes clientes dos serviços PostgreSQL devem ser configurados com o endereço virtual IP. A configuração pode ser feita com um nome DNS (caso um nome DNS tenha sido criado e associado ao endereço virtual IP).
13. Teste
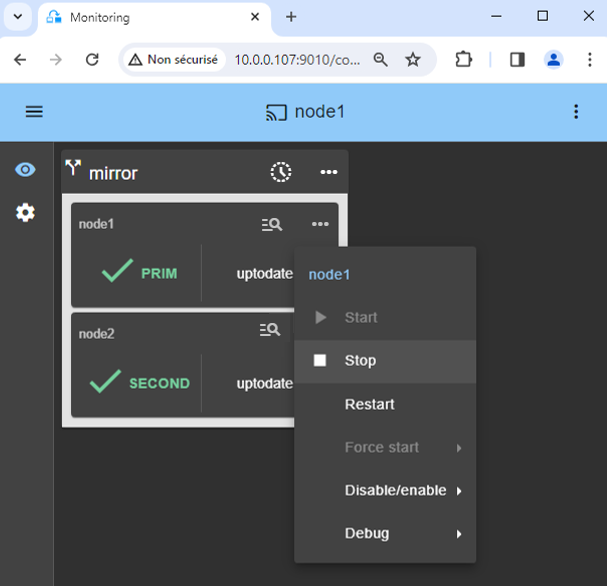
- Pare o nó PRIM rolando para baixo em seu menu contextual e clicando em
Stop. - Verifique se há um failover no nó SECOND que deve se tornar ALONE (verde).
- E com o Microsoft Management Console (MMC) em Windows ou com linhas de comando em Linux, verifique o failover dos serviços PostgreSQL (interrompido no nó 1 no script
stop_prime iniciado no nó 2 no scriptstart_prim).
⚠️ Se ALONE (verde) não for alcançado em node2 ou se a aplicação não for iniciada, analise o porquê com o log do módulo 🖼️ do nó 2.
- Clique no ícone 🔍 log de
node2para abrir o log do módulo e procurar mensagens de erro, como um verificador detectando um erro e interrompendo o módulo. - Clique em
start_primno log: as mensagens de saída do script são exibidas à direita e erros podem ser detectados, como um serviço iniciado incorretamente. - Use SafeKit AI 🤖 para obter assistência com mensagens de log.
⚠️
- Se tudo estiver bem, inicie node1, que irá ressincronizar os diretórios replicados de node2.
- Se algo der errado, pare node2 e force o início como 🖼️ primário de node1, que será reiniciado com seus dados localmente íntegros no momento da parada.
ℹ️ Encontre mais detalhes, junto com vídeos, no Treinamento Online SafeKit.
14. Suporte
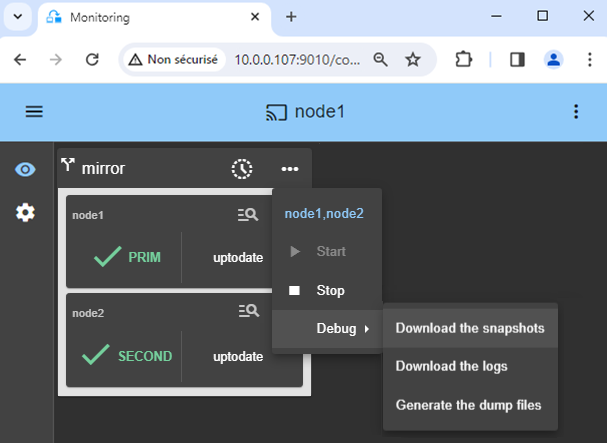
- Para obter suporte, leve 2 SafeKit
Snapshots(2 arquivos .zip), um para cada nó.
ℹ️ Mais informações sobre suporte aqui.
Demonstração da solução de espelho SafeKit
Vídeo SafeKit: Clustering em nível de aplicativo (8:47)
Neste vídeo, descubra como o SafeKit implementa um cluster de alta disponibilidade espelhado sem a complexidade de uma SAN. Embora esta demonstração utilize o Microsoft SQL Server, a solução funciona de forma idêntica para outros bancos de dados e aplicativos.
Capítulos
- 🎬 2 nós com SQL Server (0:32)
- 🎬 Configure o cluster e o módulo mirror.safe (3:58)
- 🎬 Iniciar e testar replicação SQL, migração e failover em caso de falha (4:17)
Implementação passo a passo
- 🛠️ Leia o guia sobre como configurar um cluster espelhado no Windows
- 🛠️ Leia o guia sobre como configurar um cluster espelhado no Linux
🔍 Hub de Navegação de Alta Disponibilidade SafeKit
Explore o SafeKit: Recursos, vídeos técnicos, documentação e teste gratuito
| Tipo de Recurso | Descrição | Link Direto |
|---|---|---|
| Recursos Principais | Por que escolher o SafeKit para uma Alta Disponibilidade simples e econômica? | Veja por que escolher o SafeKit para Alta Disponibilidade |
| Casos de Uso | Descubra como o SafeKit garante a alta disponibilidade de infraestruturas críticas | Ver todos os casos de uso (Software OEM, Servidores Edge, SCADA e mais) |
| Modelo de Implantação | HA SANless Tudo-em-Um: Clustering de Software Shared-Nothing | Veja o SafeKit HA SANless Tudo-em-Um |
| Estratégias de HA | SafeKit: Infraestrutura (VM) vs. Alta Disponibilidade no Nível da Aplicação | Veja SafeKit HA & Redundância: VM vs. Nível de Aplicação |
| Especificações Técnicas | Limitações Técnicas para o Clustering SafeKit | Veja as Limitações de Alta Disponibilidade do SafeKit |
| Vídeos | SafeKit: Configuração de Alta Disponibilidade e Demos de Failover | Veja os Tutoriais de Failover do SafeKit |
| Arquitetura | Como funciona o Mirror Cluster do SafeKit (Replicação e Failover em Tempo Real) | Veja SafeKit Mirror Cluster: Replicação em Tempo Real e Failover |
| Arquitetura | Como funciona o Farm Cluster do SafeKit (Balanceamento de Carga de Rede e Failover) | Veja SafeKit Farm Cluster: Balanceamento de Carga de Rede e Failover |
| Vantagens Competitivas | Comparação: SafeKit vs. Clusters de Alta Disponibilidade (HA) Tradicionais | Veja a Comparação: SafeKit vs. Cluster de HA Tradicional |
| Recursos Técnicos | Alta Disponibilidade SafeKit: Documentação, Downloads e Teste | Veja Teste Gratuito e Documentação Técnica do SafeKit HA |
| Soluções Pré-configuradas | Biblioteca de Módulos de Aplicação SafeKit: Soluções de HA Prontas para Uso | Veja os Módulos de Aplicação de Alta Disponibilidade SafeKit |