Técnicas de replicação de dados para alta disponibilidade: uma comparação completa
Técnicas de replicação de dados ao nível da base de dados, do disco ou do ficheiro?
Visão geral
Este artigo analisa as vantagens e desvantagens das técnicas de replicação de dados ao nível da base de dados, do disco e do ficheiro para clusters de alta disponibilidade. São considerados o failover, o failback e a simplicidade de implementação.
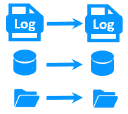
As tabelas comparativas seguintes explicam detalhadamente as técnicas de replicação de dados implementadas pelo SafeKit, um produto de software de alta disponibilidade.
O que é a técnica de replicação de dados ao nível da base de dados?
É a replicação de ficheiros de registo entre dois servidores, efectuada pelo sistema de gestão de bases de dados, como o registo de transacções do SQL Server.
Para que o failover seja automático, é obrigatória a replicação síncrona; caso contrário, as últimas transacções confirmadas não estarão disponíveis no servidor secundário após o failover.
Esta técnica replica uma base de dados, mas não os restantes dados da aplicação. O failover de muitas aplicações também requer a replicação de outros dados, como ficheiros de configuração.
Se um servidor falhar e perder ficheiros da base de dados, o failback não é automático. Um DBA experiente tem de restaurar a base de dados no servidor avariado.
O que é a técnica de replicação de dados ao nível do disco?
É a replicação das alterações nos discos entre dois servidores, como no DRBD.
Para obter failover automático sem perda de dados, é necessária a replicação síncrona entre os discos.
Esta técnica pode replicar bases de dados e outros ficheiros, mas afecta significativamente a organização dos dados da aplicação. Todos os dados têm de estar no disco replicado. Isso pode ser impossível se alguns dados estiverem no disco do sistema, que tem de ser específico de cada servidor.
São necessários conhecimentos especializados para configurar um disco replicado com um sistema de ficheiros e colocar nele os dados da aplicação.
O que é a técnica de replicação de dados ao nível do ficheiro?
É a replicação das alterações nos ficheiros entre dois servidores, como no SafeKit.
Para obter failover automático sem perda de dados, é necessária a replicação síncrona em tempo real.
Esta técnica pode replicar bases de dados e outros ficheiros sem afectar a organização dos dados da aplicação. Por exemplo, a replicação de ficheiros em tempo real funciona mesmo que uma aplicação armazene os seus dados no disco do sistema.
A solução é muito simples de configurar: basta indicar os caminhos dos directórios a replicar.
Tabelas comparativas das técnicas de replicação de dados
Escolher a abordagem correta de replicação de dados é fundamental para garantir a continuidade do negócio. Esta comparação destaca os principais diferenciadores do cluster espelho SafeKit com replicação de ficheiros em tempo real face às alternativas tradicionais, como a replicação ao nível da base de dados, a replicação de disco, as soluções de disco partilhado e os sistemas tolerantes a falhas.
Cluster espelho SafeKit: vantagens sobre abordagens alternativas de replicação e clustering
| Característica | Vantagem SafeKit | Limitação das alternativas |
|---|---|---|
| 3 produtos em 1 | Poupa no Windows e Linux o custo de armazenamento externo partilhado/replicado, equipamentos de balanceamento de carga e edições enterprise de sistemas operativos e bases de dados. Inclui todas as funcionalidades de clustering: replicação síncrona de ficheiros em tempo real, monitorização de falhas, reinício automático, failover de IP virtual. | As abordagens tradicionais exigem produtos separados para replicação de armazenamento, balanceamento de carga e clustering — aumentando custos e complexidade. |
| Configuração muito simples | Configuração através de módulos de aplicação. Novos serviços e diretórios replicados podem ser adicionados facilmente. Tudo gerido por uma consola web centralizada. Nenhum controlador de domínio ou Active Directory necessário. | Microsoft cluster e soluções semelhantes exigem configuração complexa de Active Directory e controladores de domínio. |
| Replicação síncrona | A replicação em tempo real é síncrona sem perda de dados em caso de falha (RPO = 0). | A replicação assíncrona pode perder transações recentes que ainda não foram replicadas no momento da falha. |
| Failback totalmente automatizado | Após uma falha, quando um servidor reinicia, o failback de replicação é totalmente automático. O servidor que falhou é reintegrado no cluster sem parar a aplicação no servidor restante. | A maioria das soluções de replicação (especialmente ao nível da base de dados) exige ressincronização manual. A aplicação pode mesmo ser parada durante o failback. |
| Replicação de qualquer tipo de dados | A replicação funciona para bases de dados e para quaisquer ficheiros que precisem de ser replicados. | A replicação ao nível da base de dados protege apenas a base de dados, não ficheiros de configuração, registos ou outros dados da aplicação. |
| Replicação de ficheiros vs. replicação de disco | A replicação baseia-se em diretórios de ficheiros que podem estar localizados em qualquer sítio, inclusive no disco do sistema. | A replicação de disco exige uma partição dedicada e configuração especial da aplicação para armazenar os dados. |
| Replicação de ficheiros vs. disco partilhado | Os servidores podem ser implementados em dois locais remotos sem infraestrutura partilhada. | As soluções de disco partilhado exigem proximidade física e não conseguem abranger locais remotos. |
| Locais remotos e IP virtual | Todas as funcionalidades de clustering funcionam para 2 servidores em locais remotos. A LAN estendida permite o reencaminhamento VIP de nível 2. Para redes IP diferentes, o VIP é gerido por um balanceador de carga com health check do SafeKit. | Muitas soluções de clustering não suportam failover entre locais remotos ou exigem redirecionamento DNS complexo com tempos de recuperação imprevisíveis. |
| Quórum e split brain | Funciona com apenas 2 servidores. Um verificador simples de split brain para um router gere o isolamento de rede entre os locais. | A maioria das soluções de clustering exige um 3.º servidor para gestão do quórum. |
| Cluster ativo/ativo | O servidor secundário não é dedicado. O cluster pode operar em modo ativo/ativo com 2 módulos espelho diferentes. | Os sistemas tolerantes a falhas dedicam o secundário à execução da mesma aplicação sincronizada ao nível das instruções. |
| Solução HA uniforme | O SafeKit implementa tanto o cluster espelho (replicação + failover) como o cluster farm (balanceamento de carga + failover). Uma arquitetura N-camadas pode ser tornada altamente disponível com uma única solução no Windows e Linux. | Arquiteturas típicas misturam tecnologias diferentes para balanceamento de carga, replicação e failover — aumentando a complexidade operacional. |
| RTO / RPO | Reinício rápido da aplicação em caso de falha: cerca de 1 minuto ou menos. Zero perda de dados (replicação síncrona). | A replicação completa de VM (VMware HA, Hyper-V cluster) exige o reinício de todo o sistema operativo num novo hipervisor, resultando em tempos de recuperação mais longos. |
Em resumo , o cluster espelho SafeKit oferece uma solução de alta disponibilidade unificada e económica que combina replicação síncrona de ficheiros, failover e failback automáticos, balanceamento de carga e suporte a locais remotos — tudo sem exigir hardware dedicado, armazenamento partilhado ou um terceiro servidor de quórum. Esta simplicidade torna-o particularmente adequado para editores de software e organizações que necessitam de HA fiável em servidores Windows e Linux padrão.
🔍 Hub de Navegação de Alta Disponibilidade SafeKit
Explore o SafeKit: Funcionalidades, vídeos técnicos, documentação e teste gratuito
| Tipo de Recurso | Descrição | Link Direto |
|---|---|---|
| Funcionalidades Chave | Porquê escolher o SafeKit para uma Alta Disponibilidade simples e económica? | Veja porquê escolher o SafeKit para Alta Disponibilidade |
| Casos de Uso | Descubra como o SafeKit garante a alta disponibilidade de infraestruturas críticas | Ver todos os casos de utilização (Software OEM, Servidores Edge, SCADA e mais) |
| Modelo de Implementação | HA SANless Tudo-em-Um: Clustering de Software Shared-Nothing | Veja o SafeKit HA SANless Tudo-em-Um |
| Estratégias de HA | SafeKit: Infraestrutura (VM) vs. Alta Disponibilidade ao Nível da Aplicação | Veja SafeKit HA & Redundância: VM vs. Nível da Aplicação |
| Especificações Técnicas | Limitações Técnicas para o Clustering SafeKit | Veja as Limitações de Alta Disponibilidade do SafeKit |
| Vídeos | SafeKit: Configuração de Alta Disponibilidade & Demos de Failover | Veja os Tutoriais de Failover do SafeKit |
| Arquitetura | Como funciona o Mirror Cluster do SafeKit (Replicação em Tempo Real & Failover) | Veja SafeKit Mirror Cluster: Replicação em Tempo Real & Failover |
| Arquitetura | Como funciona o Farm Cluster do SafeKit (Balanceamento de Carga de Rede & Failover) | Veja SafeKit Farm Cluster: Balanceamento de Carga de Rede & Failover |
| Vantagens Competitivas | Comparação: SafeKit vs. Clusters de Alta Disponibilidade (HA) Tradicionais | Veja a Comparação SafeKit vs. Cluster de HA Tradicional |
| Recursos Técnicos | Alta Disponibilidade SafeKit: Documentação, Downloads & Teste | Veja o Teste Gratuito & Documentação Técnica do SafeKit HA |
| Soluções Pré-configuradas | Biblioteca de Módulos de Aplicação SafeKit: Soluções de HA Prontas a Usar | Veja os Módulos de Aplicação de Alta Disponibilidade SafeKit |
