Replicação síncrona versus assíncrona: como é que o SafeKit garante a perda de dados nula?
Perda de dados ou não no failover de aplicações com replicação síncrona ou assíncrona?
Existe uma diferença significativa entre replicação síncrona e replicação assíncrona. Dependendo da escolha, poderá sofrer perda de dados durante um failover da aplicação.
- A replicação síncrona, tal como implementada pelo software SafeKit, é essencial para a Alta disponibilidade (HA). Garante o failover de aplicações transacionais sem perder um único byte: todos os dados confirmados no disco do servidor primário também estão presentes no disco do servidor secundário.
- A replicação assíncrona é normalmente utilizada para Backup e recuperação de desastres (DR). Existe o risco de que os dados confirmados no disco do servidor primário possam ser perdidos no caso de uma falha porque ainda não foram copiados para o site remoto.
- A replicação semissíncrona é uma solução alternativa em que os dados confirmados chegam ao servidor secundário, mas não são necessariamente gravados no seu disco.
É importante compreender que estas soluções são complementares. Embora a replicação síncrona do SafeKit proteja o seu ambiente contra falhas de hardware ou software para manter o tempo de atividade 24 horas por dia, 7 dias por semana, uma solução de cópia de segurança protege os seus dados históricos contra erros lógicos e ciberameaças como o ransomware.
Para o ajudar a tomar a decisão certa ao escolher a melhor arquitetura para as suas necessidades, explicamos abaixo os mecanismos técnicos e o impacto no failover de aplicações.
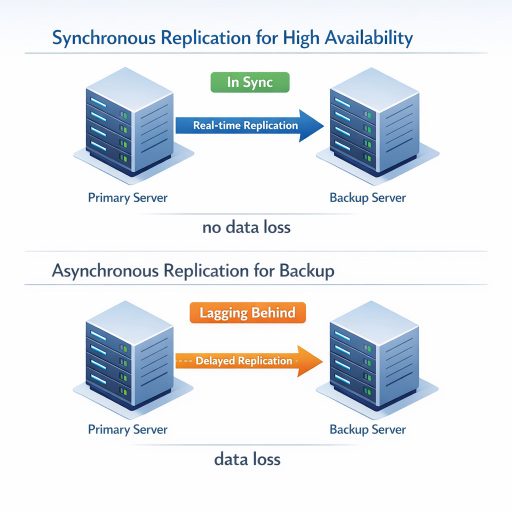
Comparação do impacto da replicação síncrona e assíncrona na perda de dados durante o failover de aplicações.
Índice
- Perda de dados ou não em failover de aplicação com replicação síncrona ou assíncrona?
- Como funciona a replicação assíncrona?
- Como funciona a replicação síncrona?
- Como funciona a replicação semi-síncrona?
- Veredicto final: Escolha da replicação correta para alta disponibilidade
- Tabela de comparação: síncrono vs. assíncrono vs. semi-síncrono
- Guia de vídeo: configurar a replicação síncrona em tempo real e alta disponibilidade
- FAQ: estratégias de replicação em clusters de alta disponibilidade
- SafeKit Hub de navegação de alta disponibilidade
Como funciona a replicação assíncrona?
Na replicação assíncrona , o servidor primário reconhece as operações de escrita imediatamente, atualizando as réplicas posteriormente em lotes agendados com atraso. Esta dissociação ultrapassa os problemas de latência da replicação de longa distância , tornando-a uma estratégia preferencial para backups e recuperação de desastres em locais remotos.
No entanto, esta eficiência introduz o desafio da consistência , onde o servidor secundário pode conter informação desatualizada. Uma vez que a atualização secundária ocorre após a conclusão da gravação primária, qualquer falha do servidor primário resultará na perda de dados em trânsito.
Como funciona a replicação síncrona?
Com a replicação síncrona implementada pelo SafeKit, quando uma operação de E/S de disco é executada pela aplicação ou pela cache do sistema de ficheiros no servidor primário, o sistema garante a consistência dos dados através de um processo de confirmação dupla.
SafeKit aguarda o reconhecimento de E/S do disco local e do servidor secundário antes de enviar a confirmação final de volta para a aplicação ou para a cache do sistema de ficheiros. Este mecanismo síncrono é essencial para o failover de aplicações transacionais , garantindo que as transações são totalmente seguras em ambos os nós antes de serem consideradas confirmadas.
Como funciona a replicação semissíncrona?
A replicação semissíncrona serve como uma abordagem híbrida para a integridade dos dados. Tal como a replicação síncrona, o SafeKit aguarda uma confirmação dos servidores primário e secundário antes de confirmar a operação de E/S para a cache da aplicação ou do sistema de ficheiros.
A diferença crítica está no tempo de resposta do servidor secundário. No caso semi-síncrono, o servidor secundário envia uma confirmação ao primário imediatamente após receber os dados em memória , enviando-os posteriormente para o disco. Por outro lado, a replicação síncrona exige que o servidor secundário escreva a E/S no disco físico antes de enviar a confirmação.
Veredicto final: Escolher a replicação correta para alta disponibilidade
A escolha entre replicação síncrona ou assíncrona é uma compensação entre a integridade absoluta dos dados e o desempenho da rede. Para infraestruturas de missão crítica, esta decisão determina diretamente o seu Recovery Point Objective (RPO).
Em síntese:
- Replicação assíncrona: o padrão de ouro para backup, mas não para alta disponibilidade. Embora suporte conectividade de longa distância, existe um risco inerente de perda de dados porque os dados do nó secundário ficam atrás dos dados do nó primário.
- Replicação síncrona: o padrão de ouro para alta disponibilidade, mas não para backup. Garante que os ficheiros do nó secundário são um clone em tempo real do primário, garantindo failover sem perda de dados.
- Replicação semissíncrona: fornece um meio-termo de alto desempenho para alta disponibilidade. Ao confirmar os dados ao nível da memória antes da escrita no disco, minimiza a latência, mantendo uma proteção de dados superior em comparação com os métodos assíncronos.
⭐ Recomendação SafeKit: Para aplicações críticas, dê sempre prioridade à replicação síncrona ou semi-síncrona para garantir a continuidade do negócio, maximizar o desempenho e eliminar os riscos associados ao failover inconsistente.
Tabela de comparação: síncrono vs. assíncrono vs. semi-síncrono
| Recurso | Síncrono | Semi-síncrono | Assíncrono |
|---|---|---|---|
| RPO (perda potencial de dados) | zero | zero | Diferente de zero (perda de dados: depende da última cópia assíncrona) |
| Reconhecimento de E/S Remota | Após gravação remota no disco | Após gravação remota na RAM | Não espera reconhecimento |
| Impacto no desempenho | Requer uma rede de baixa latência - Depende do tempo de ida e volta (normalmente RTT<5ms) | Requer uma rede de baixa latência - Depende do tempo de ida e volta (normalmente RTT<5ms) | Suporta rede de baixa latência |
| Limites de distância | VLAN local/estendida | VLAN local/estendida | Rede de longa distância (WAN) |
| Melhor para | Alta disponibilidade (failover automático) | Alta disponibilidade (failover automático) | Soluções de backup (failover manual) |
Guia de vídeo: configurar a replicação síncrona em tempo real e alta disponibilidade
Vídeo SafeKit: Clustering ao nível da aplicação (8:47)
Neste vídeo, descubra como o SafeKit implementa um cluster de alta disponibilidade espelhado sem a complexidade de uma SAN. Embora esta demonstração utilize o Microsoft SQL Server, a solução funciona de forma idêntica para outras bases de dados e aplicações.
Capítulos
- 🎬 2 nós com SQL Server (0:32)
- 🎬 Configure o cluster e o módulo mirror.safe (3:58)
- 🎬 Iniciar e testar a replicação SQL, migração e failover em caso de falha (4:17)
Implementação passo a passo
- 🛠️ Leia o guia sobre como configurar um cluster espelhado no Windows
- 🛠️ Leia o guia sobre como configurar um cluster espelhado no Linux
Perguntas frequentes: estratégias de replicação em clusters de alta disponibilidade
Tecnologia e mecânica de replicação
O SafeKit envia o ficheiro completo pela rede sempre que é modificado?
Não. SafeKit utiliza replicação ao nível do byte. Interceta modificações específicas de E/S dentro de ficheiros e replica apenas os bytes alterados, minimizando o tráfego de rede.
A replicação é acionada sempre que a aplicação grava nos seus ficheiros?
Não. A replicação ocorre apenas quando a aplicação solicita um comprometimento de E/S para o disco local. SafeKit garante que estes dados são reconhecidos pelo servidor secundário antes de concluir a gravação.
A replicação síncrona torna a minha aplicação mais lenta?
A latência está ligada ao Tempo de ida e volta da rede (RTT). Numa LAN, o impacto é insignificante (semelhante ao armazenamento NAS/SAN). Em WAN de alta latência, os modos assíncronos são frequentemente preferidos para evitar estrangulamentos de desempenho e é necessária uma solução de cópia de segurança (não SafeKit).
Estratégia de implementação: HA vs. Backup
Quando devo escolher a replicação síncrona ou assíncrona?
Escolha Síncrono para alta disponibilidade (failover automático, zero perda de dados). Escolha Assíncrono para Backup/DR, em que a distância impede a sincronização em tempo real e o failover automático não é necessário.
O SafeKit suporta replicação assíncrona?
Não. SafeKit é uma solução de alta disponibilidade que requer zero perda de dados para failover automático. Para necessidades puramente assíncronas, procure soluções de Backup.
A alta disponibilidade elimina a necessidade de uma solução de cópia de segurança?
Não, a alta disponibilidade não elimina a necessidade de uma solução de cópia de segurança abrangente.
Embora as soluções de replicação em tempo real, como o SafeKit, proporcionem uma continuidade contínua do negócio, têm uma finalidade diferente dos backups. A replicação em tempo real foi concebida para proteger contra falhas de hardware e tempo de inatividade do servidor, mas não pode proteger contra ameaças cibernéticas, como o ransomware que encripta ambos os nós em simultâneo. Apenas uma solução de cópia de segurança com política de retenção pode resolver este problema.
Como posso combinar a replicação síncrona e assíncrona?
Pode utilizar uma arquitetura híbrida de 3 nós: um cluster local de 2 nós com replicação síncrona para HA e uma terceira cópia remota através de uma solução de cópia de segurança com replicação assíncrona para recuperação de desastres.
Consulte para mais informações: SafeKit Alta disponibilidade e recuperação de desastres (HADR)
🔍 Hub de Navegação de Alta Disponibilidade SafeKit
Explore o SafeKit: Funcionalidades, vídeos técnicos, documentação e teste gratuito
| Tipo de Recurso | Descrição | Link Direto |
|---|---|---|
| Funcionalidades Chave | Porquê escolher o SafeKit para uma Alta Disponibilidade simples e económica? | Veja porquê escolher o SafeKit para Alta Disponibilidade |
| Casos de Uso | Descubra como o SafeKit garante a alta disponibilidade de infraestruturas críticas | Ver todos os casos de utilização (Software OEM, Servidores Edge, SCADA e mais) |
| Modelo de Implementação | HA SANless Tudo-em-Um: Clustering de Software Shared-Nothing | Veja o SafeKit HA SANless Tudo-em-Um |
| Estratégias de HA | SafeKit: Infraestrutura (VM) vs. Alta Disponibilidade ao Nível da Aplicação | Veja SafeKit HA & Redundância: VM vs. Nível da Aplicação |
| Especificações Técnicas | Limitações Técnicas para o Clustering SafeKit | Veja as Limitações de Alta Disponibilidade do SafeKit |
| Vídeos | SafeKit: Configuração de Alta Disponibilidade & Demos de Failover | Veja os Tutoriais de Failover do SafeKit |
| Arquitetura | Como funciona o Mirror Cluster do SafeKit (Replicação em Tempo Real & Failover) | Veja SafeKit Mirror Cluster: Replicação em Tempo Real & Failover |
| Arquitetura | Como funciona o Farm Cluster do SafeKit (Balanceamento de Carga de Rede & Failover) | Veja SafeKit Farm Cluster: Balanceamento de Carga de Rede & Failover |
| Vantagens Competitivas | Comparação: SafeKit vs. Clusters de Alta Disponibilidade (HA) Tradicionais | Veja a Comparação SafeKit vs. Cluster de HA Tradicional |
| Recursos Técnicos | Alta Disponibilidade SafeKit: Documentação, Downloads & Teste | Veja o Teste Gratuito & Documentação Técnica do SafeKit HA |
| Soluções Pré-configuradas | Biblioteca de Módulos de Aplicação SafeKit: Soluções de HA Prontas a Usar | Veja os Módulos de Aplicação de Alta Disponibilidade SafeKit |
