什么是 RPO 和 RTO?定义、示例和高可用性策略
快速总结:RPO 与 RTO
- RPO(恢复点目标):衡量数据丢失 。它定义了恢复操作所需文件的最大保留期限。
- RTO(恢复时间目标):衡量停机时间 。它是业务流程必须恢复所需的时间。
- 主要区别: RPO 指的是存储/备份 ,而 RTO 指的是恢复/故障转移速度 。
- SafeKit功能:通过同步复制和自动故障转移实现0 RPO (无数据丢失)和低 RTO (快速重启)。
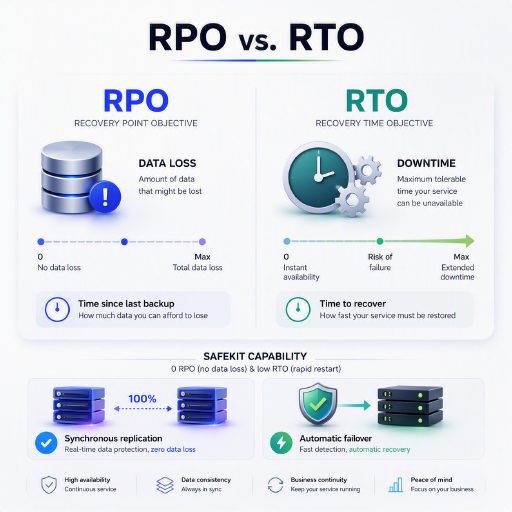
RPO 与 RTO:比较SafeKit中的数据丢失和恢复时间
目录
- 如何计算高可用性和业务连续性解决方案的恢复点目标 RPO) 和恢复时间目标 RTO)?
- ](#calculate-rpo-rto-backup-solution)确定备份和灾难恢复解决方案的[和 RTO?
- 如何实现SafeKit Mirror集群的零 RPO 和低 RTO?
- 启用负载均衡的SafeKit Farm集群的 RTO 基准是什么?
- 对比表:RTO 与 RPO
- 高可用性实战:零 RPO 和近零 RTO 实时演示
- 关于 RPO 和 RTO ](#faq-rpo-rto)常见问题[
- SafeKit高可用性导航中心
计算高可用性和业务连续性解决方案的 RPO 和 RTO?
什么是高可用性?
**高可用性 (HA)**是一种技术架构,旨在确保系统在指定的百分比时间内保持运行和可访问性(例如,99.99%)。
为了实现业务连续性计划中定义的 RPO 和 RTO 目标,高可用性通常通过以下两种主要架构来实现:
- **基于 SAN 的共享磁盘系统:**传统集群,其中两个节点连接到中央存储区域网络 (SAN)。如果一个节点发生故障,另一个节点将接管对共享数据的访问。
- **无 SAN 同步复制:**一种现代的“无共享”架构——由 SafeKit软件实现——其中数据在 2 个独立节点的本地磁盘之间实时复制,无需 SAN。
高可用性解决方案的恢复点目标 (RPO) 是什么?
恢复点目标 (RPO)定义了在一定时间内可容忍的最大数据丢失量。对于真正的高可用性解决方案,目标 RPO为零。
在实施具有自动故障转移的高可用性集群时, 零 RPO可确保应用程序在不丢失数据的情况下重新启动。
- 通过 SAN 共享磁盘系统:因为两个节点访问完全相同的物理数据块 ,因此节点之间没有“差值”或延迟,从而确保故障转移期间数据的完全一致性。
- 软件复制:一种无需存储区域网络 SAN) 的方法,其中每个“写入”操作都会在网络中实时镜像应用程序只有在数据安全地存储在两个节点上后才会收到确认。这种同步“双写”过程保证零数据丢失即使主服务器发生故障。
高可用性解决方案的恢复时间目标 (RTO) 是多少?
恢复时间目标 (RTO)表示服务中断后可接受的最大停机时间。在高可用性环境下,RTO 应尽可能短,以确保关键应用程序的持续访问。
为了实现低恢复时间目标 (RTO),高可用性解决方案利用自动转移来检测硬件或软件故障并立即重启应用程序。在典型的高可用性集群中, **约为一分钟,**方法如下:
- **故障检测时间:**系统识别节点或应用程序心跳丢失所需的时间间隔。
- **自动重启时间:**应用程序服务在幸存节点上初始化所需的时间。
如何确定备份和灾难恢复解决方案的 RPO 和 RTO?
什么是备份解决方案?
解决方案是一种数据保护策略旨在定期将数据副本保存到辅助存储设备或云端。与高可用性不同,备份于长期数据保留从数据损坏或全站灾难中恢复。
为了达到灾难恢复计划中定义的 RPO 和 RTO 目标,备份通常通过以下两种主要方法实施:
- 计划快照:一种按固定时间间隔(例如,每天)创建数据特定时间点副本的过程。这决定了恢复点目标 (RPO ),因为在上次快照和故障之间修改的任何数据都会丢失。
- 异地或云恢复:一种将数据存储在独立物理位置的架构。虽然这可以确保数据完整性,但由于必须先传输和恢复数据,应用程序才能重新启动,因此会导致更高的恢复时间目标 (RTO) 。
备份解决方案的 RPO 是什么?
在备份环境中,**恢复点目标 (RPO)**定义了为恢复正常运行必须从存储中恢复的文件的“年龄”。与高可用性不同,备份解决方案通常具有非零的 RPO,表示自上次成功完成备份以来经过的时间。
备份策略中的数据丢失量取决于备份频率。根据架构的不同,恢复点目标 (RPO) 的范围可以从几分钟到 24 小时不等:
- **快照:**方法仅按设定的时间间隔保存已更改的数据块。如果每 4 小时进行一次备份, **最大恢复点目标 (RPO) 为 4 小时,**意味着在上次快照和系统崩溃之间创建的任何数据都将永久丢失。
- 每日完整备份:一种传统方法,每天(通常在夜间)创建一份完整的数据副本。这种方法的恢复点目标 (RPO) 为 24 小时,对于非关键数据来说或许可以接受,但对于事务型数据库而言通常不够。
备份解决方案的恢复时间目标 (RTO) 是多少?
备份策略中的**恢复时间目标 (RTO)**是指从备份介质恢复数据并将应用程序恢复到运行状态所需的时间。与高可用性不同,备份的 RTO要长得多,因为它涉及手动或脚本化的恢复过程。
对于备份解决方案, 恢复时间目标 (RTO) 可能从几小时到几天 ,具体取决于数据量和恢复架构。总停机时间计算如下:
- **数据传输时间:**将数据从备份存储(本地磁盘、磁带或云)移动回生产服务器所需的时间。
- **系统重新配置时间:**将数据拉入应用程序、重建索引并验证数据完整性所需的时间间隔,之后用户才能重新登录。
SafeKit Mirror集群如何实现零 RPO 和低 RTO?
SafeKit Mirror集群是什么?
SafeKit Mirror集群和是一种基于软件的高可用性解决方案,它采用了一种“无共享”架构。与需要昂贵 SAN 的传统集群不同, SafeKit利用两台标准服务器的本地资源来创建一个高弹性的环境。
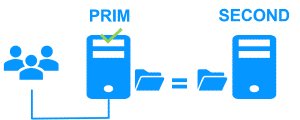
为确保业务连续性计划的最大正常运行时间和数据保护, SafeKit mirror集群通过两种集成机制运行:
- 实时同步复制: SafeKit在主节点和辅助节点的本地磁盘之间通过网络镜像数据。这确保了恢复点目标 (RPO) 为零,因为在事务最终完成之前,每个字节的数据都会在两个服务器上得到保护。
- **自动 IP 和应用故障转移:**如果主节点发生故障, SafeKit会自动检测心跳丢失,并在备用节点上重新建立应用及其虚拟 IP 地址。这可实现约一分钟的恢复时间目标 (RTO),从而确保服务的无缝连续性。
SafeKit Mirror的 RPO 分别是多少?
**SafeKit mirror集群的 RPO 为零,**因为节点之间的数据复制是同步和实时的 。
通过写入确认过程实现零数据丢失保证:只有当磁盘写入成功写入主节点和辅助节点的本地磁盘后,才会向应用程序确认磁盘写入。
相比之下,异步复制的恢复点目标 (RPO) 大于零。由于主服务器写入和辅助服务器更新之间存在延迟,因此在故障转移到辅助服务器期间,一旦发生故障,就会造成数据丢失。对于关键业务连续性而言,同步复制是确保应用程序重启后数据完整性达到 100% 的唯一方法。
SafeKit Mirror的 RTO 是多少?
在标准配置中,集群的恢复时间目标RTO SafeKit约为一分钟。提供了在层 机层实现高可用性的灵活性mirror两种SafeKit对恢复时间的影响各不相同:
- **应用级高可用性:**这是优化的SafeKit方法,其中软件监控特定的应用程序服务。
- 硬件故障: RTO = 心跳超时(默认 30 秒)+ 应用程序重启时间。
- 软件故障: RTO = 应用程序停止时间 + 应用程序重新启动时间。
- 主要优势:由于操作系统已经在辅助节点上运行,因此没有操作系统启动延迟,从而实现了业务连续性的最快恢复。
- **VM级HA:**在此场景中, SafeKit保护整个虚拟机环境。
- 故障恢复: RTO = 故障检测 + 操作系统重启时间 + 应用程序重启时间。
- 技术权衡: RTO 自然会更长(几分钟),因为辅助节点必须先对操作系统进行完整的冷启动,应用程序才能开始初始化。
通过利用应用级高可用性 、 SafeKit ,消除了标准虚拟化中固有的“重启惩罚”,确保您的业务连续性计划实现尽可能低的停机时间。
具有负载均衡功能的SafeKit Farm集群的 RTO 基准是什么?
SafeKit Farm集群是什么?
SafeKit Farm集群是一种基于软件的高可用性解决方案,专为需要可扩展性可扩展性和冗余性无状态应用程序(例如 Web 服务器)而设计。与专注于数据复制的mirror集群不同, farm集群将传入流量分布到多个活动节点上。
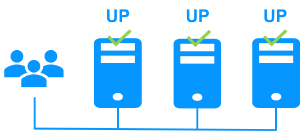
为了在高流量环境下维持业务连续性 , SafeKit farm集群通过两种核心机制运行:
- 网络负载均衡: SafeKit使用虚拟 IP 地址将传入的网络流量分配到多个活动服务器( farm )上。这确保了单个服务器不会过载,并最大限度地提高了应用程序的性能。
- 自动故障检测与重配置:如果中的一个节点发生故障, SafeKit会通过心跳机制检测farm该故障,并立即将流量重新分配到其余健康节点。由于其他节点已处于活动状态并准备好承担负载,因此这使得整个服务的恢复时间目标 (RTO) 接近于零。
SafeKit Farm的 RPO 分别是多少?
对于SafeKit Farm集群,**其恢复点目标 (RPO)通常被认为不适用 (N/A) 。这是因为farm集群专为无状态应用程序**而设计,这类应用程序的数据不存储在节点本地。
由于farm集群侧重于网络负载均衡而非数据同步,因此集群内部节点之间不存在数据复制。在一个典型的业务连续性计划中,涉及farm架构:
- 无状态操作: farm中的所有节点都是相同的,并且不保存持久数据;因此,在节点故障期间不会出现“数据丢失”的情况。
- 外部数据存储:如果应用程序需要数据持久性,则通常由单独的后端SafeKit Mirror集群处理,此时 RPO 将为零。
SafeKit Farm的 RTO 是多少?
在farm架构中,由于所有节点通常同时处于活动状态, RTO 会缩短至仅几秒 。恢复时间取决于集群重新配置其流量分配的速度:
- **硬件故障:**恢复时间超时 (RTO) 等于监控通道的故障检测超时时间(默认值为几秒)。一旦检测到心跳丢失, 虚拟 IP 负载均衡过滤器将自动重新配置,以将流量重定向到其余健康节点。
- 软件故障或计划重启: RTO 的计算方法是在该特定节点上应用停止时间加上应用重启时间,在此期间, farm中的其他节点将继续处理所有传入流量。
这种“主动-主动”机制确保对于无状态服务, 业务连续性影响对最终用户几乎是不可察觉的,因为无需在新备用节点上初始化服务。
对比表:RTO 与 RPO
语义定义:RTO 与 RPO
| 指标 | 缩写 | 定义 | 重点领域 |
|---|---|---|---|
| 恢复时间目标 (RTO) | 在故障后恢复业务流程的目标时间。 | /停机时间 | |
| 恢复点目标 | RPO | 要恢复操作,必须从备份中恢复的文件的最大保存期限。 | 数据丢失/完整性 |
高可用性 (HA) 与标准备份
| 功能 | 备份解决方案 | 高可用性 ( SafeKit ) |
|---|---|---|
| 恢复自动化 | 手动干预 | 自动故障转移 |
| 目标RTO(回购期限)为 | 小时至天 | 秒至约1分钟。 |
| 目标 RPO | > 0(上次备份点) | 0(同步复制) |
集群的 RTO 和 RPO 基准测试(适用于SafeKit集群集群)
| 架构 | 用例 | RTO(可用性) | RPO(数据丢失) |
|---|---|---|---|
| Mirror集群 | 实时复制 | ~1 分钟(心跳 + 重启) | 0(无数据丢失) |
| Farm集群 | 网络负载均衡 | 几秒钟 | 不适用(无状态) |
高可用性实战:零 RPO 和近零 RTO 的实时演示
视频:在SafeKit Mirror集群中实现零 RPO 和低 RTO (8:47)
了解SafeKit如何处理严重故障。本视频演示了同步复制如何确保 SQL 数据库中的数据不丢失(RPO 0),以及如何自动重启辅助节点上的服务(低 RTO)。
章节
- 🎬 2 个节点,包含SQL Server和 (0:32)
- 🎬 配置集群和mirror.safe模块 (3:58)
- 🎬 启动并测试 SQL 复制、迁移和崩溃时故障转移 (4:17)
视频:在SafeKit Farm集群中实现近零 RTO (5:03)
观看SafeKit如何管理 Apache Web farm ,以提供性能扩展和即时故障转移。
章节
- 🎬 2 个节点,Apache (0:13)
- 🎬 配置集群和farm.safe模块 (2:20)
- 🎬 启动并测试网络负载均衡、崩溃时故障转移 (2:30)
常见问题解答:优化 RPO 和 RTO 以实现业务连续性
RPO 和 RTO 可以为零吗?
是的。实现零 RPO意味着零数据丢失,这可以通过同步数据镜像来实现。接近零 RTO则可以通过像SafeKit这样的自动故障转移软件来实现,该软件能够检测故障并在几秒或几分钟内将应用程序重启到备用节点上。
RPO 和 RTO 哪个更重要?
两者本身**孰轻孰重之分,它们各自扮演着不同的角色。**点目标 (RPO) 侧重于数据丢失——即您可以承受的数据丢失量。 **时间目标 (RTO)**于停机时间——即您必须多快恢复在线。对于关键任务型应用而言,两者都必须尽可能缩短。
应用层和虚拟机层(VM)的SafeKit与的 RPO 和 RTO 有何区别?
虽然两者都通过同步复制确保**为 0,**它们的恢复时间有所不同:
- **应用层:**更快的恢复时间目标 (RTO)(约 1 分钟),因为在已运行的操作系统上,仅重启应用程序服务。它还能检测特定的软件/进程崩溃。
- **虚拟机级别:**更高的恢复时间目标 (RTO),因为整个虚拟机必须在辅助主机上重启。虽然它与应用程序无关,但缺乏对应用程序进程本身的细粒度监控。
HA 解决方案和备份解决方案在 RTO 方面有什么区别
高可用性 (HA) 通常能提供更短的恢复时间目标 (RTO)(几秒到几分钟),因为它能自动处理本地故障。而灾难恢复 (DR) 的备份解决方案通常需要更长的 RTO(几小时到几天),因为它需要在重大灾难发生后,从地理位置遥远的站点恢复数据和服务。
如何实现远程站点间最佳的 RPO 和 RTO?
要在远程站点实现零 RPO和接近零 RTO,需要结合同步复制和扩展 LAN(扩展 VLAN) :
- **扩展 LAN / 扩展 VLAN:**通过在两个数据中心之间扩展同一子网(第 2 层),您可以将应用程序从站点 A 迁移到站点 B,而无需更改其 IP 地址,从而避免复杂的 DNS 更新。
- 解决方案: SafeKit利用此功能提供了一个可在站点间浮动软件定义虚拟 IP (VIP) 。它使用免费 ARP (GARP) 将流量立即重新路由SafeKit辅助站点。
这样,无需人工干预即可实现RPO = 0 (实时镜像)和最小 RTO (大约 1 分钟内发生故障转移)。
为什么将高可用性和备份相结合对于优化恢复点目标 (RPO) 和恢复时间(RTO) 至关重要?
将高可用性 (HA) 与备份解决方案相结合,是实现“两全其美”恢复策略的唯一途径。虽然它们经常被放在一起讨论,但它们解决的是 RPO/RTO 等式中的不同部分:
- **高可用性(通过SafeKit ):**可优化硬件或软件故障期间的近零恢复时间目标 (RTO) 和零恢复点目标 (RPO)。通过使用实时同步复制,辅助服务器始终保持最新状态。如果主服务器发生故障,服务将立即在辅助服务器上重启,且不会丢失任何数据。
- **备份解决方案:**可防止数据完整性问题(例如勒索软件或意外删除)。由于 HA 会即时复制更改,因此它可以将病毒或已删除的数据库记录“忠实地”复制到备用服务器。备份允许您“回溯”到损坏发生之前的状态。
- 方案:为了实现最大程度的弹性,企业采用三节点架构。该包含一个双节点本地集群采用同步复制以实现即时高可用性,以及一个用于灾难恢复的远程副本(异步)。这种分层防御机制确保您拥有一个用于即时恢复的“实时”副本和一个用于数据安全的“历史”副本。
🔍 探索 SafeKit
查找有关 SafeKit 功能、架构、视频、文档和免费试用的信息。
| 资源 | 描述 | 链接 |
|---|---|---|
| 主要功能 | 了解 SafeKit 为何是一种简单且经济高效的高可用性解决方案。 | 探索主要功能 |
| 用例 | 了解 SafeKit 如何保持关键应用程序和基础设施的可用性。 | 探索用例 |
| 部署模型 | SafeKit 无需 SAN 或共享存储即可提供高可用性。 | 探索部署模型 |
| 高可用性策略 | 比较虚拟机的可用性与应用程序的可用性。 | 比较这两种策略 |
| 技术规格 | 查看 SafeKit 集群的技术要求和限制。 | 阅读技术规格 |
| 视频 | 观看 SafeKit 配置和自动故障转移的演示。 | 观看技术视频 |
| 架构 | 了解 SafeKit mirror 集群如何实时复制文件并处理故障转移。 | 探索 Mirror 架构 |
| 架构 | 了解 SafeKit farm 集群如何平衡网络流量并处理故障转移。 | 探索 Farm 架构 |
| 产品对比 | 将 SafeKit 与传统的高可用性集群进行比较。 | 比较解决方案 |
| 技术资源 | 查找技术文档、下载 SafeKit 并访问免费试用版。 | 访问文档和免费试用版 |
| 应用模块 | 使用预配置的 SafeKit 模块为您的应用程序设置高可用性。 | 探索应用模块 |
