---
title: "Kubernetes K3s ad alta disponibilità: replica sincrona e failover a 2 nodi"
canonical: "https://safekit.eviden.com/it/solutions/kubernetes-k3s-the-simplest-high-availability-cluster-with-synchronous-replication-and-failover-between-two-redundant-servers/"
description: "Ottieni l’alta disponibilità di K3s su 2 nodi senza storage esterno o quorum etcd. Scopri come SafeKit fornisce la replica senza perdita di dati e il failover automatico."
category: "solutions"
lang: "it"
topics: "Semplificare l’alta disponibilità di K3s: perché scegliere SafeKit invece di MetalLB e Longhorn?, Indice, Come implementa il software SafeKit un cluster Kubernetes K3s ad alta disponibilità?, Come funziona il cluster mirror SafeKit con Kubernetes K3S?, Limitazioni SafeKit High Availability, Confronto: SafeKit vs. stack K3s standard (MetalLB e Longhorn), Guida video: configurazione di un cluster mirror SafeKit HA"
translation: "translate_md 2026-11-08.3 | glossaire 2026-11-08.8 | Translation LLM | 24 expressions"
---
# Kubernetes K3s ad alta disponibilità: replica sincrona e failover a 2 nodi {#kubernetes-k3s-high-availability-2-node-synchronous-replication--failover}
## Semplificare l’alta disponibilità di K3s: perché scegliere SafeKit invece di MetalLB e Longhorn? {#safekit-k3s-ha-introduction}
Mentre lo stack open-source standard (MetalLB + Longhorn) per K3s è potente per i grandi data center, introduce una complessità eccessiva per i siti on-premise a 2 nodi. **SafeKit** semplifica l’ambiente K3s sostituendo gli strumenti di rete e di archiviazione standalone con un unico motore HA consolidato.
### Perché usare SafeKit per l’alta disponibilità (HA) di K3s a 2 nodi? {#why-use-safekit-for-2-node-k3s-high-availability-ha}
* **Vera alta disponibilità a 2 nodi:** SafeKit fornisce una ridondanza completa con soli **2 nodi**, eliminando il requisito di 3 nodi per il quorum *etcd*.
* **Perdita di dati pari a zero (RPO = 0):** sostituisce l’archiviazione a blocchi ad alto sovraccarico con **la replica sincrona a livello di byte** per prestazioni SSD locali.
* **Protezione flessibile a livello di file:** SafeKit esegue la replica basata sull’host a livello di file, il che è completamente trasparente per l’applicazione. Protegge non solo i database, ma anche tutte le cartelle e i dati associati. È possibile replicare le cartelle esistenti esattamente dove sono installate, anche sul **disco di sistema**.
* **IP virtuale (VIP) integrato:** gestisce nativamente l’IP del cluster a livello di kernel, eliminando la necessità di configurazioni **MetalLB** separate.
* **Failover e failback automatici:** attiva una transizione immediata al nodo secondario in caso di errore; una volta che il nodo primario è integro, SafeKit esegue **la risincronizzazione automatica dei dati** senza intervento manuale.
* **Overhead ultra-basso:** SafeKit funziona senza il pesante overhead di gestione dei pod di archiviazione (CSI/Longhorn) e dei pod di rete (CNI/MetalLB) richiesti dagli stack standard, liberando RAM e CPU critiche per le tue applicazioni.
* **Adatto ai generalisti IT:** sostituisce la complessa **infrastruttura YAML** per il networking e lo storage con una **semplice GUI web** e script di distribuzione automatizzati, lasciandoti concentrare solo sulle tue applicazioni.

**Alta disponibilità (HA) senza condivisione per cluster K3s a 2 nodi**
⚡ Guida rapida all’installazione di un cluster Kubernetes HA >
## Indice {#toc}
* [Come implementa il software SafeKit un cluster Kubernetes K3s ad alta disponibilità?](#safekit-mirror-k3s-cluster)
* [Come funziona il cluster mirror SafeKit con Kubernetes K3S?](#safekit-mirror-cluster)
* [Limitazioni SafeKit High Availability](#safekit-ha-limitations)
* [Confronto: SafeKit vs. stack K3s standard (MetalLB e Longhorn)](#safekit-k3s-ha-comparison)
* [Guida video: configurazione di un cluster HA mirror SafeKit](#videoguide-safekit-mirror-cluster)
* [🔍 Esplora SafeKit](#hub)
## Come implementa il software SafeKit un cluster Kubernetes K3s ad alta disponibilità? {#safekit-mirror-k3s-cluster}
### Come si implementa l’alta disponibilità per un cluster Kubernetes K3s a 2 nodi? {#how-do-i-implement-high-availability-for-a-2-node-kubernetes-k3s-cluster}
È possibile implementare l’alta disponibilità (HA) per un cluster Kubernetes K3s a 2 nodi utilizzando il **modulo mirror SafeKit k3s.safe**. Questa soluzione consente di implementare un ambiente ridondante senza la necessità di storage NFS esterno, di un database di configurazione esterno dedicato o di competenze specialistiche Kubernetes.
### Perché usare K3s per l’edge computing e l’IoT? {#why-use-k3s-for-edge-and-iot-computing}
[K3s]() è il motore Kubernetes preferito per **l’IoT e l’edge computing** perché è una distribuzione certificata e leggera, progettata per ambienti con risorse limitate. Semplifica il sovraccarico operativo di Kubernetes standard, mantenendo al contempo la piena compatibilità.
### Quali sono le caratteristiche principali del modulo mirror k3s.safe? {#what-are-the-key-features-of-the-k3ssafe-mirror-module}
Il modulo k3s.safe fornisce uno stack HA completo per K3s implementando:
* **Nodi attivi doppi:** esegue contemporaneamente 2 master/agenti K3s attivi per ospitare i pod.
* **Replicazione del database:** replicazione in tempo reale del database di configurazione di MariaDB tra i nodi.
* **Archiviazione persistente:** replica dei volumi persistenti tramite un client NFS integrato con provisioning dinamico (nfs-client).
* **Continuità della rete:** include un indirizzo IP virtuale per un accesso client senza interruzioni.
* **Recupero automatico:** supporto completo per il failover e il failback automatici.
### Oltre a K3s, quali applicazioni e ambienti può proteggere SafeKit? {#beyond-k3s-which-applications-and-environments-can-safekit-protect}
SafeKit è una soluzione versatile ad alta disponibilità **per Windows e Linux** che va ben oltre cluster mirror K3s. Consente **la replica sincrona in tempo reale** e il failover automatico per un’ampia gamma di carichi di lavoro critici, tra cui:
* **Ambienti virtuali e fisici:** macchine virtuali Hyper-V o KVM complete.
* **Orchestrazione di container:** ambienti Docker, Podman.
* **Dati e servizi:** directory di file individuali, servizi e vari database.
* **Infrastruttura cloud:** alta disponibilità per le applicazioni cloud.
SafeKit fornisce inoltre ai **cluster farm** **il bilanciamento del carico di rete nativo e il failover** per le applicazioni senza stato come **i server Web**.
💡 [Esplora l’elenco completo delle soluzioni HA supportate qui.]()
### In che modo SafeKit garantisce l’alta disponibilità di K3s? {#safekit-k3s-architecture-table}
**Architettura e logica di ridondanza per un cluster K3s a 2 nodi tramite SafeKit**
Cluster K3s a 2 nodi | SafeKit PRIM (nodo primario) | SafeKit SECOND (nodo secondario)
---|---|---
Esecuzione del carico di lavoro | I servizi master e agent di K3s sono attivi, gestiscono l’orchestrazione del cluster ed eseguono i pod. | I servizi master e agent di K3s rimangono attivi, fornendo elaborazione parallela e alta disponibilità.
Archiviazione NFS e PV | • IP virtuale host e porta NFS
• Gestisce le condivisioni NFS esportate attive
• Memorizza i volumi persistenti (PV) di K3s | Mirroring sincrono: SafeKit replica tutti i volumi persistenti in tempo reale per garantire l’assenza di perdita di dati.
Database di configurazione | • IP virtuale host e porta MariaDB
• Gestisce il database di configurazione attivo di K3s | Replicazione del database: il database MariaDB viene replicato in modo sincrono, preservando lo stato del cluster per il failover.
**Meccanismo di failover automatico:** in caso di errore del nodo primario, SafeKit migra automaticamente gli IP virtuali e i servizi di archiviazione al nodo secondario, garantendo un servizio ininterrotto per il cluster K3s.
## Come funziona il cluster mirror SafeKit con Kubernetes K3S? {#safekit-mirror-cluster}
### Passaggio 1: replica di file a livello di byte in un cluster mirror {#step-1-byte-level-file-replication-in-a-mirror-cluster}
Questa fase illustra l’architettura ad alta disponibilità tra **il server 1 (PRIM)** e **il server 2 (SECOND)**. Entrambi i server eseguono i componenti master e agent di K3s come definito nella [tabella dell’architettura](#safekit-k3s-architecture-table).
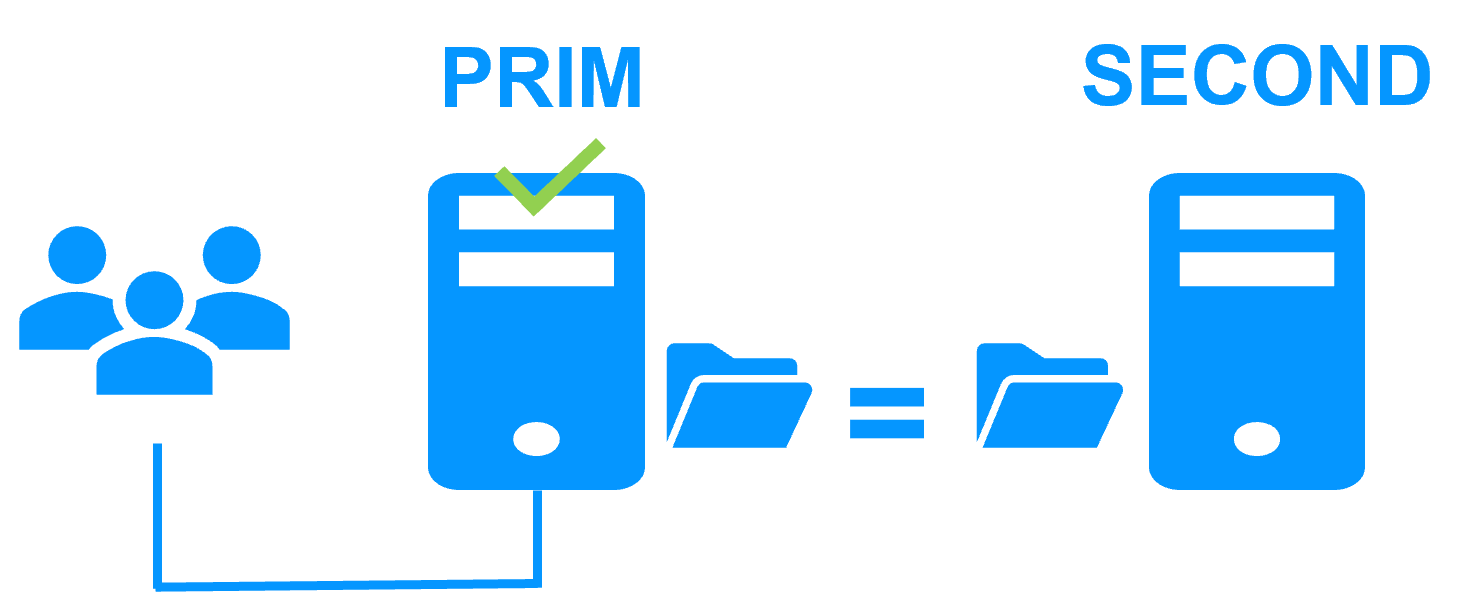
Attualmente, l’**IP virtuale (VIP)**, **l’archiviazione persistente NFS** e **MariaDB** sono attivi solo sul server 1 (PRIM). I componenti master K3s su entrambi i nodi si sincronizzano tra loro accedendo allo stato del cluster tramite l’IP virtuale e la porta MariaDB. SafeKit implementa [la replica sincrona]() di MariaDB e dei file NFS persistenti, garantendo **zero perdita di dati (RPO = 0)** in caso di guasto.
I master K3s distribuiscono il carico di lavoro su entrambi i nodi (o più) comunicando direttamente con gli agenti K3s. I client esterni si connettono al
[indirizzo IP virtuale del cluster]() sul nodo PRIM. Utilizzando i meccanismi standard Kubernetes, il master K3s inoltra il traffico ai pod distribuiti sui nodi. Allo stesso modo, i pod accedono ai loro **volumi persistenti (PV)** sul server PRIM tramite l’IP virtuale e la porta NFS.
### Fase 2: Failover automatico e continuità del servizio {#step-2-automatic-failover-and-service-continuity}
Quando **il server 1 (PRIM)** si guasta, **il server 2 (SECOND)** assume automaticamente le operazioni del cluster per garantirne la continuità.
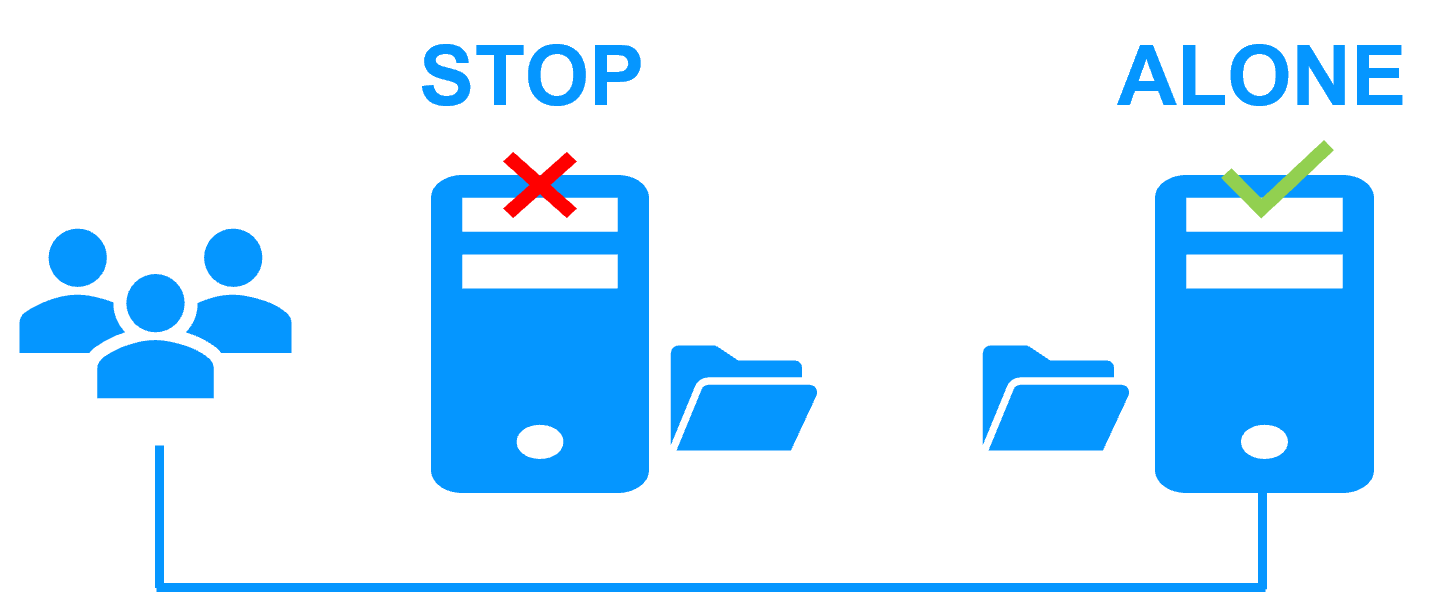
SafeKit rileva l’errore e migra immediatamente l’**indirizzo IP virtuale** del cluster al Server 2. Quindi, promuove i **servizi** locali **MariaDB** e NFS a uno stato attivo. Grazie alla replica sincrona eseguita nel Passaggio 1, tutti i database MariaDB e i file NFS Persistent Volume (PV) sono già aggiornati sul Server 2, garantendo l’assenza di perdita di dati.
Con lo stato del cluster conservato, il **master K3s** sul server 2 continua l’esecuzione. Rileva la perdita dell’agente del server 1 e ripianifica automaticamente i pod interessati sui restanti agenti K3s attivi. Il tempo totale di failover (RTO) è la somma dell’intervallo di rilevamento dei guasti (impostazione predefinita: 30 secondi) e del tempo necessario ai componenti K3s per inizializzarsi sul nodo secondario.
Mentre il server 1 è offline, i servizi MariaDB e NFS continuano a essere in esecuzione sul server 2, scrivendo le modifiche solo in locale.
### Fase 3: Failback e reintegrazione automatica {#step-3-failback-and-automatic-reintegration}
**Il failback** si verifica quando il Server 1 viene riavviato dopo che il problema iniziale è stato risolto. SafeKit risincronizza automaticamente i file MariaDB e NFS, aggiornando solo i dati modificati sul Server 2 durante il tempo di inattività. Questo processo di reintegrazione **non è dirompente** ; i componenti master e agent di K3s continuano a essere in esecuzione sul Server 2 senza interruzioni.
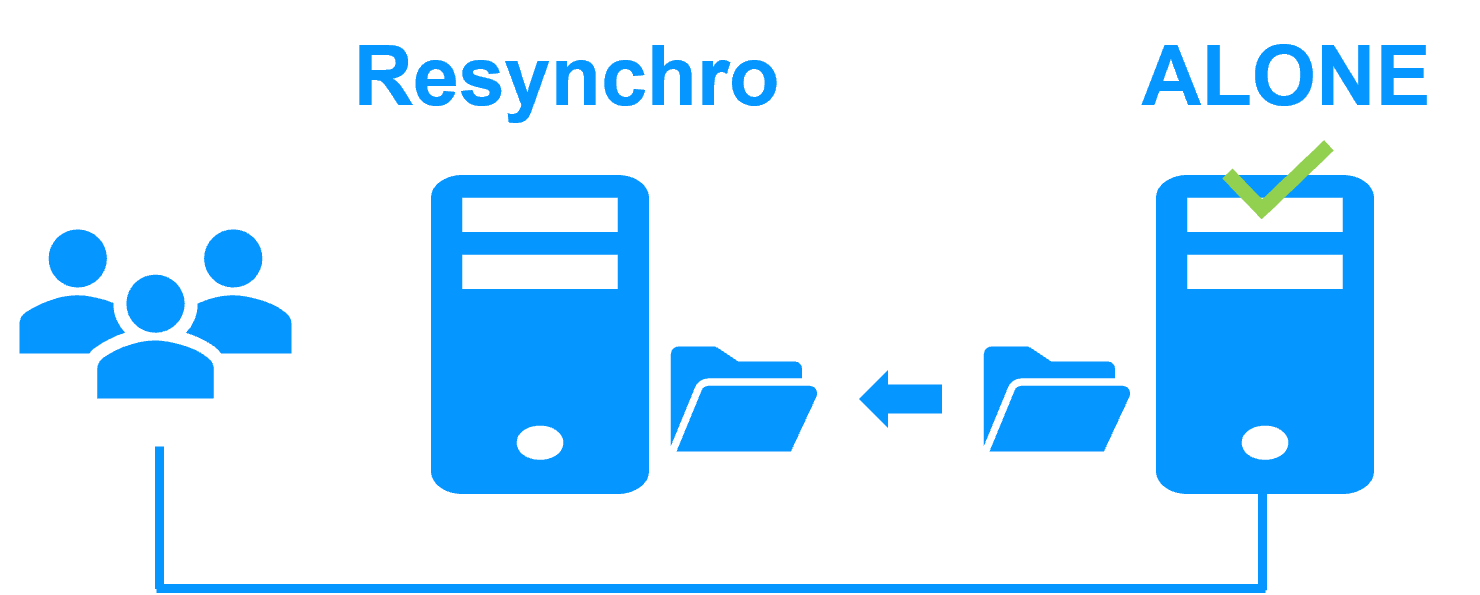
SafeKit ottimizza il tempo di ripristino in base al modo in cui il server è stato arrestato:
* **Arresto pulito:** se SafeKit è stato arrestato intenzionalmente sul server 1, solo le zone specifiche modificate all’interno dei file vengono risincronizzate utilizzando **le bitmap di rilevamento delle modifiche**. Ciò garantisce una reintegrazione ultraveloce.
* **Arresto anomalo del sistema (ad es. interruzione di corrente):** se il server 1 ha subito uno spegnimento anomalo, le bitmap di modifica vengono ignorate per motivi di sicurezza. SafeKit risincronizza invece tutti i file con un timestamp di modifica più recente dell’ultimo punto di sincronizzazione stabilito, garantendo **la totale integrità dei dati**.
### Fase 4: ripristino dell’alta disponibilità e della distribuzione del carico {#step-4-restoring-high-availability-and-load-distribution}
Dopo la reintegrazione, il cluster torna alla **modalità mirror completa**, rispecchiando lo stato descritto nel passaggio 1. Il sistema è nuovamente in uno stato di alta disponibilità: i servizi **MariaDB** e **NFS** rimangono attivi sul server 2, mentre SafeKit esegue la replica in tempo reale di tutti gli aggiornamenti dei file sul server 1.
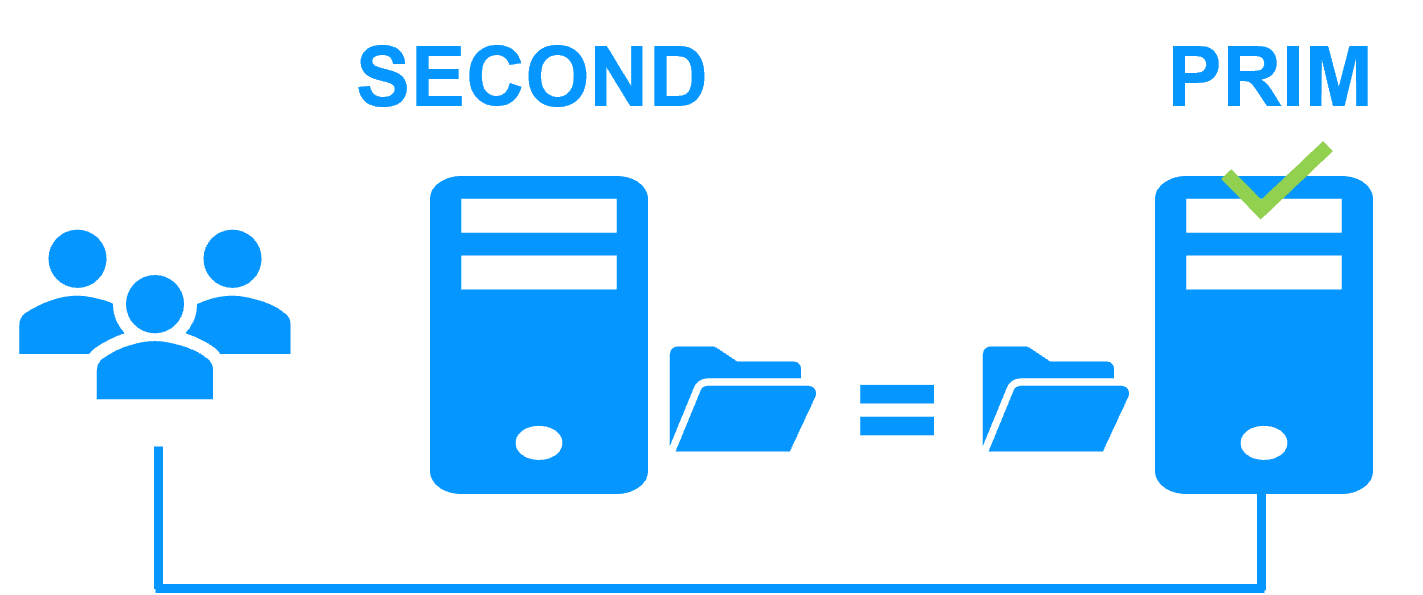
Il **master K3s** e **l’agente K3s** vengono riavviati automaticamente sul server 1. Lo scheduler Kubernetes ora riconosce il server 1 come un nodo integro e può iniziare a riprogrammare i pod per distribuire il carico di lavoro su entrambi i server.
Se l’amministratore preferisce che i servizi MariaDB e NFS vengano eseguiti sul Server 1 (ripristinando il ruolo PRIM originale), è possibile attivare manualmente un **failover** tramite la console web in un momento opportuno o automatizzarlo tramite le impostazioni di configurazione.
### Come configurare un cluster mirror SafeKit? {#safekit-mirror-cluster-configure}
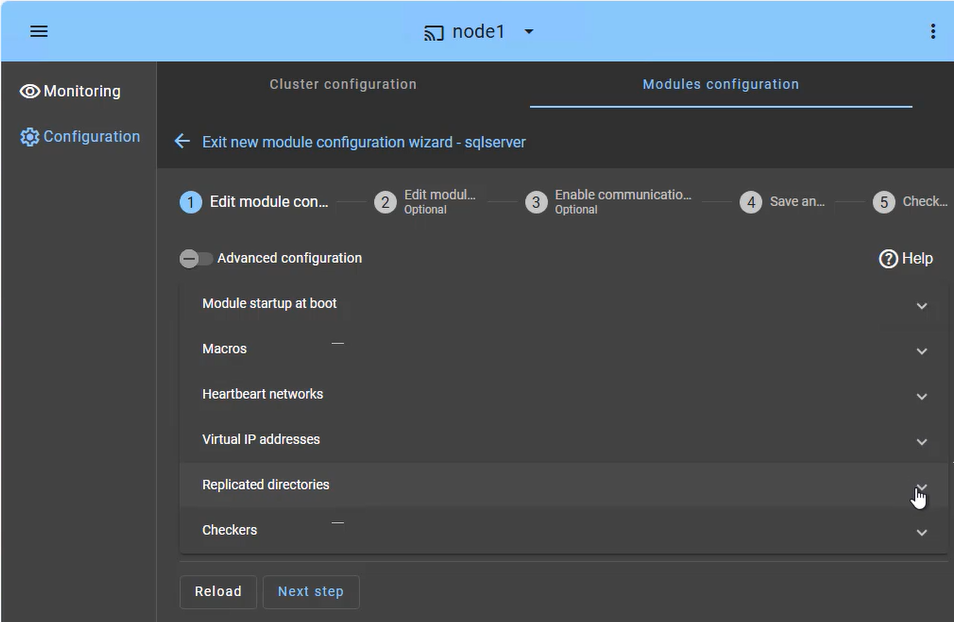
La **console web SafeKit** offre un’interfaccia intuitiva per orchestrare l’alta disponibilità delle applicazioni critiche. In pochi passaggi, è possibile configurare un **cluster mirror SafeKit** per garantire la continuità aziendale:
* **Failover dell’applicazione (scheda Macro):** definire i servizi dell’applicazione specifici da riavviare automaticamente in caso di errore.
* **Rete/i heartbeat:** percorso/i di comunicazione dedicato/i utilizzato/i dai nodi del cluster per monitorare continuamente lo stato di salute e la disponibilità reciproca e per sincronizzare le decisioni di failover.
* **Gestione IP virtuale:** configurare l’IP virtuale (VIP) per la riconnessione trasparente del client dopo un failover.
* **Replicazione in tempo reale:** selezionare le directory critiche per la replicazione sincrona a livello di byte basata sull’host.
* **Checkers:** monitora lo stato di salute dell’applicazione e avvia il ripristino automatico in caso di rilevamento di un errore di processo.
Il cluster SafeKit include un verificatore di split-brain dedicato per risolvere i problemi di isolamento della rete senza la necessità di una terza macchina witness o di una rete heartbeat aggiuntiva. Per saperne di più su [heartbeat, failover e quorum in un cluster]().
### Come monitorare un cluster mirror SafeKit? {#safekit-mirror-cluster-monitoring}

La **console di gestione SafeKit** offre una visione unificata della tua infrastruttura ad alta disponibilità. Consente agli amministratori di monitorare lo **stato operativo** del cluster e di tracciare la sincronizzazione dei dati in tempo reale.
Per un cluster mirror a 2 nodi, la console visualizza chiaramente i ruoli di ciascun server:
* **PRIM (primario):** il nodo attivo che attualmente esegue l’applicazione e gestisce l’IP virtuale. Esegue scritture sull’archiviazione locale e la replica in tempo reale sul nodo secondario.
* **SECOND:** il nodo di standby riceve aggiornamenti sincroni a livello di byte. È pronto a subentrare immediatamente in caso di errore del nodo primario.
* **Stato ALONE:** avvisa visivamente quando il cluster è in esecuzione su un singolo nodo (ad esempio, durante la manutenzione o dopo un errore), indicando che la ridondanza è temporaneamente persa.
* **Avanzamento della risincronizzazione:** quando un nodo guasto si riprende, il suo stato diventa arancione durante la reintegrazione dei dati in background, garantendo l’assenza di tempi di inattività durante la fase di "ritorno alla normalità".
Oltre alle semplici icone di stato, l’interfaccia fornisce **un’orchestrazione di failover con un solo clic**, consentendo di riassegnare manualmente il ruolo primario per la manutenzione pianificata, garantendo al contempo la disponibilità continua per l’attività dell’utente.
## Limitazioni SafeKit High Availability {#safekit-ha-limitations}
Limite/Requisito | Motivo e impatto | Alternativa consigliata
---|---|---
Dimensioni della replica: alcuni TB | Tempo di risincronizzazione dopo un errore ([passaggio 3](https://safekit.eviden.com/it/architectures/file-replication-byte-level-with-failover-mirror-cluster/#safekit-mirror-cluster)):
• Rete da 1 Gb/s ≈ 3 ore/TB
• Rete da 10 Gb/s ≈ 1 ora/TB (a seconda delle prestazioni di scrittura del disco) | • Utilizzare [un’unità di archiviazione condivisa esterna](https://safekit.eviden.com/it/best-practises/san-vs-nas-shared-storage-for-a-failover-cluster/) (più costosa e più complessa).
Numero di file: < 1.000.000 | • Prestazioni del tempo di risincronizzazione dopo un guasto ([passaggio 3](https://safekit.eviden.com/it/architectures/file-replication-byte-level-with-failover-mirror-cluster/#safekit-mirror-cluster)).
• Tempo necessario per confrontare ciascun file tra i due nodi. | • Inserire i numerosi file da replicare in un disco rigido virtuale/macchina virtuale.
• In questo caso, verranno replicati e risincronizzati solo i file che rappresentano il disco rigido virtuale/la macchina virtuale.
Capacità di failover: ≤ 32 VM | • Ogni VM viene eseguita in un modulo mirror indipendente.
• Massimo 32 moduli mirror in esecuzione sullo stesso cluster. | • Utilizzare un’unità di archiviazione esterna condivisa e un’altra soluzione di clustering per macchine virtuali (più costosa e complessa).
Architettura di rete: rete LAN/VLAN tra siti remoti | • Failover automatico [dell’indirizzo IP virtuale](https://safekit.eviden.com/it/best-practises/how-a-virtual-ip-address-works/) con 2 nodi nella stessa sottorete.
• Buona larghezza di banda per la risincronizzazione ([passaggio 3](https://safekit.eviden.com/it/architectures/file-replication-byte-level-with-failover-mirror-cluster/#safekit-mirror-cluster)).
• Bassa latenza per [la replica sincrona](https://safekit.eviden.com/it/best-practises/synchronous-replication-vs-asynchronous-replication/): in genere < 5 ms RTT; i valori più elevati devono essere convalidati in base alla velocità di scrittura dell’applicazione. | • Se i due nodi si trovano in sottoreti diverse (comune nel cloud), utilizzare [altre opzioni di reindirizzamento](https://safekit.eviden.com/it/best-practises/how-a-virtual-ip-address-works/#safekit-virtual-ip-implementation): un bilanciatore del carico, le CLI del provider cloud, BGP o il reindirizzamento DNS.
• Utilizzare soluzioni di backup con replica asincrona per reti ad alta latenza.
## Confronto: SafeKit vs. stack K3s standard (MetalLB e Longhorn) {#safekit-k3s-ha-comparison}
**Confronto: SafeKit vs. soluzioni open source standard (MetalLB + Longhorn)**
Capacità | SafeKit (K3s.safe) | MetalLB + Longhorn (K8s standard)
---|---|---
Architettura | Tutto in uno: rete, replica e failover integrati in un unico pacchetto. | Stack fai da te (DIY): sono necessari più pacchetti indipendenti (CNI, CSI, LoadBalancer).
Efficienza hardware | HA a 2 nodi puro: ridondanza completa senza un terzo nodo "witness" o di arbitrato. | Minimo 3 nodi: in genere sono richiesti numeri dispari per il quorum di Etcd e la sicurezza dell’archiviazione.
Networking (VIP) | Nativo: IP virtuale gestito a livello di sistema operativo; trasparente per K3s. | Complesso: richiede l’installazione di MetalLB con configurazione L2 o BGP utilizzando pod speaker dedicati che consumano CPU/RAM su ciascun nodo.
Requisiti di archiviazione | Sincrono a livello di byte: replica di file in tempo reale delle directory esistenti; funziona su dischi di sistema standard; replica di file a livello di byte con un sovraccarico minimo di CPU/rete. | A livello di blocco: archiviazione distribuita a blocchi (Longhorn) tramite pod di archiviazione dedicati; maggiore consumo di risorse.
Intelligenza di failover | Stabilità indipendente: SafeKit opera al di fuori del runtime del container. Monitora direttamente il sistema operativo e l’hardware, garantendo il failover anche se il piano di controllo Kubernetes o il motore del container si bloccano. | Dipendenza circolare: la logica di failover è ospitata *all’interno* dei pod che dovrebbe proteggere. Se il sistema operativo host o il motore K3s si bloccano, anche i pod di gestione (MetalLB/Longhorn) si bloccano, spesso richiedendo un intervento manuale per sbloccare il "blocco"
Amministrazione | Semplificato: gestibile tramite una singola console web; non è richiesto un esperto Kubernetes. | Specializzato: richiede una profonda conoscenza di YAML, Helm e dei controller interni di K8s.
**In sintesi**, mentre uno stack fai-da-te standard (MetalLB + Longhorn) offre modularità per gli esperti Kubernetes, crea una **dipendenza circolare** in cui gli strumenti di archiviazione e di rete sono vulnerabili agli stessi errori dei nodi che sono progettati per gestire. **SafeKit** interrompe questo ciclo operando come uno strato di infrastruttura indipendente; fornisce una soluzione HA a 2 nodi più robusta e indipendente dall’hardware che rimane operativa anche se il motore Kubernetes o il sistema operativo host si blocca. Ciò garantisce il ripristino automatico e l’integrità dei dati senza il pesante sovraccarico di risorse, il quorum obbligatorio a tre nodi o la complessità di configurazione richiesta dai tradizionali sistemi di archiviazione a blocchi distribuiti e dagli overlay di rete.
## Guida video: configurazione di un cluster mirror SafeKit HA {#videoguide-safekit-mirror-cluster}
### Video SafeKit: clustering a livello di applicazione (8:47) {#demo-mirror-ha-cluster}
Questo video illustra l’alta disponibilità di SafeKit per Microsoft SQL Server e fornisce un’eccellente panoramica di come la soluzione protegga gli ambienti K3s. SafeKit funziona in modo identico per qualsiasi altro database o applicazione business-critical.
### Momenti salienti del video {#video-highlights}
1. 🎬 [2 nodi con SQL Server]() (0:32)
2. 🎬 [Configurare il cluster e il modulo mirror.safe]() (3:58)
3. 🎬 [Avviare e testare la replica, la migrazione e il failover di SQL in caso di arresto anomalo]() (4:17)
&amp;amp;amp;amp;lt;br /&amp;amp;amp;amp;gt;